Причиной в ранних модельных сетях была не , а несколько обычных, в основном исправимых проблем. Теперь мы можем понимать большинство даже в моделях с триллионами параметров. Возможно, перспективы гораздо лучше, чем мы думали.
Ник Каммарата · Goodfire · 2026 Кёрт Тиггес участвовал в исследовании языковых моделей.
Автор излагает рабочую гипотезу. Оценки зависят от выборки и критериев. Термины с пунктирным подчёркиванием открывают пояснение справа. На небольшом экране справочник открывается поверх страницы.
Я думаю, у меня есть хорошие новости о природе сетей.
Много месяцев я изучал и в моделях компьютерного зрения и языковых моделях. В результате я пришёл к убеждению, что собственные механизмы сети и есть её понятные составные части. Возможно, перспективы гораздо лучше, чем я опасался.
Канонические свидетельства и убедили многих исследователей, в том числе меня, что сети произвольно упаковывают понятия. Эти свидетельства были истолкованы неверно. То, что казалось произвольной упаковкой, в основном оказалось закономерностью, которую я назову . Она вызывает гораздо меньше опасений. Значит, сети можно изучать напрямую, без предварительного распутывания. Нейросети уже .
After many months studying neurons and circuits in image and language models, I’ve come to believe a network’s own mechanisms are its legible building blocks, and that the outlook for mechanistic interpretability may be far better than I’d feared. The canonical evidence of polysemanticity and superposition that convinced much of the field, including me, that networks pack concepts arbitrarily was misread. What looked like arbitrary packing was mostly a motif I’ll call recursive generalization, which is much less concerning. This means we can study networks directly, instead of first untangling them. Neural networks are already clean.
Существует по меньшей мере два подхода к . Первый — это быстрая нормальная наука непосредственно с сетью: изучение её и , анализ их взаимосвязей, наблюдение за потоком данных и проведение экспериментов в масштабе агентов для проверки объяснений. Второй подход начинается со списка предполагаемых и пытается извлечь все их, разрабатывая всё более сложные целевые функции реконструкции, обычно игнорируя при этом исходную сеть.
There are at least two ways to approach mechanistic interpretability. The first is rapid normal science on the network itself: look at a network’s neurons and circuits, study how they relate, watch data flow through them, and run experiments at agentic scale to test explanations. The second starts from a list of hypothesized features and tries to extract them all, designing increasingly sophisticated reconstruction objectives and usually ignoring the original.
Исследования начались с первого подхода, но область вернулась ко второму, потому что нейросети казались спутанными узлами. У нас были канонические примеры — общее название для , которые, по-видимому, выполняют несколько несвязанных задач или выглядят непонятными. Самый известный пример в модели компьютерного зрения реагировал как на кошачьи морды, так и на передние части автомобилей. А последний слой раннего этапа исследований, , казался настолько переполненным произвольными смесями, что было неясно, как его изучать: почти ни один не поддавался лёгкой интерпретации.
The field began with the first approach and fell back to the second because neural networks seemed to be tangled knots. We had canonical examples of polysemantic neurons, the broad name for a neuron that appears to have multiple unrelated jobs or that looks impossible to understand. The most famous one, in an image model, responded to both cat faces and the fronts of cars. And the last layer of the early field’s model organism, InceptionV1, seemed so full of arbitrary mixtures it wasn’t clear how to study it: almost none of the neurons were easily interpretable.
Главным объяснением была . Она предполагала новый принцип обучения: когда нейросети не хватает , она перестаёт группировать связанные понятия и начинает объединять несвязанные, просто потому, что они не мешают друг другу. Результатом становится своего рода узел: сеть могла бы сложиться множеством почти равноценных способов, поэтому то, какие понятия объединяет , почти ничего не говорит. Прежде чем изучать что-либо, этот узел нужно распутать. На практике это означает обучение второй модели — декомпозиции, такой как , — чтобы аппроксимировать сеть в том виде, в каком она выглядела бы распутанной, и изучать уже её. Если сеть действительно запутана, альтернативы может не быть.
The leading explanation for polysemanticity was superposition. This proposed a new learning principle: when a neural network runs out of neurons, it stops grouping related things together and instead begins folding unrelated things together, simply because they don’t interfere. The result is a kind of knot: the network could have folded in many almost equally good ways, so which things a neuron groups together tells you almost nothing. You have to unfold the knot before you can study anything. In practice that means training a second model – a decomposition such as a sparse autoencoder – to approximate the network as it would look unfolded and studying that instead. If the network really is knotted, there may be no alternative.
Один из главных результатов состоит в том, что была неверным объяснением для . Архитектурные проблемы приводили к переполнению поздних слоёв. Слабые инструменты интерпретируемости усугубляли эти проблемы, из-за чего поздние слои казались бессвязными. С тех пор архитектурные изменения, призванные помочь глубоким слоям обучаться лучше, имели непреднамеренный эффект: они сделали эти слои более интерпретируемыми. Когда мы впервые изучали , мы почти не нашли интерпретируемых в его последнем слое. Но благодаря этим обычным улучшениям и без изменения размера модели или обучающих данных 99–100% в этом последнем слое легко интерпретируются, а модель в целом понятна на всём протяжении. Это первая нетривиальная нейросеть, которую я, по моему ощущению, в основном понимаю; её можно посмотреть здесь. Я обучал её версии в диапазоне размеров в 300 раз, и она остаётся в целом понятной на каждом масштабе. При меньшем объёме сеть не объединяет несвязанные понятия; её просто охватывают более грубые концепции, например, один -автомобиль охватывает множество видов машин. При большем объёме этот дифференцируется на множество конкретных автомобилей. Таким образом, проблема заключалась не в наличии второго принципа обучения, а лишь в обычном сбое обучения по первому принципу, и её легко исправить.
One main result is that superposition was the wrong explanation for InceptionV1. Architectural problems made later layers overflow. Weak interpretability tools amplified these problems, making the late layers seem incoherent. Since then, architectural changes designed to help deep layers learn better have had the unintended effect of making them more interpretable. When we first studied InceptionV1, we found almost no interpretable neurons in its last layer. But with these ordinary improvements, and no change to model size or training data, 99-100% of neurons in that last layer are easily interpretable and the model is broadly legible the whole way through. It’s the first non-trivial neural network I feel I mostly understand; you can browse it here . I trained versions of it across a 300× range in size, and it’s broadly legible at every scale. With less room, the network doesn’t fold unrelated things together; its neurons just cover coarser-grained concepts, like one car neuron covering many kinds of car. With more room, that neuron differentiates into many specific cars. So the problem wasn’t the presence of a second learning principle, it was just an ordinary learning failure of the first one, and it’s easy to fix.
Канонические примеры и из компьютерного зрения тоже оказались ошибочными. В 2019 году мы с Крисом Олахом нашли , которую изначально представили как феномен в Zoom InZoom In: An Introduction to Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. Ссылки ↓. Она демонстрировала, как автомобильный , казалось бы, распространяется на набор несвязанных «собачьих» . Это был единственный пример, который мы показали, и единственный, который я когда-либо видел. Мы истолковали это как то, что сеть прячет автомобиля в многомерном скрытом месте, откуда последующие могут его считать обратно. Но никто не считывает эту комбинацию. Там ничего не пряталось; это было обычное и . Насколько мне известно, никто не опубликовал вторую с такой структурой.
The canonical vision examples of polysemanticity and superposition were errors too. In 2019, Chris Olah and I found the circuit that was originally introduced as the superposition phenomenon in Zoom In [4] Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓ . It showed a car feature appearing to spread into a set of unrelated dog neurons. It was the only one we showed, and the only one I ever saw. We read it as the network placing the car in a high-dimensional hiding place, for downstream neurons to read back out. But nothing reads that combination. It wasn’t hiding anything; it was ordinary generalization and composition. To my knowledge, no one has published a second circuit with the right shape.
Современные языковые модели гораздо более интерпретируемы, чем принято считать. В работе Anthropic Towards MonosemanticityTowards : Decomposing Language Models With Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Thread. Ссылки ↓ (2023), изучавшей небольшую однослойную модель, медианному по шкале из 14 возможных баллов была присвоена оценка 0, что означало невозможность для оценщика выдвинуть какую-либо гипотезу. В проекте автоматической интерпретируемостиLanguage Models Can Explain in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. Ссылки ↓, который я запустил в OpenAI (также в 2023 году), около 1,7% оказались интерпретируемыми по нашей самой либеральной мере.
Modern language models are also far more interpretable than generally believed. Anthropic’s Towards Monosemanticity [10] Towards Monosemanticity: Decomposing Language Models With Dictionary Learning Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Circuits Thread. References ↓ (2023), studying a small one-layer model, gave the median neuron a 0 on its rubric out of a possible 14, meaning the rater couldn’t form any hypothesis. The automated interpretability project [8] Language Models Can Explain Neurons in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. References ↓ I started at OpenAI (also 2023) found about 1.7% of neurons interpretable by our most generous measure.
С более совершенными инструментами и современными моделями картина выглядит совсем иначе. По нашим предварительным аудитам мы оцениваем, что примерно 90% полюсов выполняют одну основную задачу, часто с небольшими связанными ответвлениями; ещё около 7% имеют две связанные задачи; и лишь примерно 2–4% пока не поддаются пониманиюОговорка относительно этого числа: доля , выполняющих одну задачу, варьируется в зависимости от того, как вы устанавливаете порог для учёта , от глубины, плотности подсхем и от того, что вы считаете «одной задачей».
Важным фактором здесь является то, насколько глубоко стоит заходить в анализ . Ниже есть раздел, описывающий . Их учёт обычно увеличивает количество «связанных тем», больше влияя на это, чем то, является ли суждением о чём-то понятном. Например, Трампа включают кепки MAGA и людей, связанных с ним. «Титаника» включают более общие истории о путешествиях, а также паровые двигатели и другие технологии той эпохи.
Также возникает вопрос: следует ли обращать на или на долю наиболее сильных . В целом я считаю, что следует доверять тому, чему научился , его естественной , диапазонам и так далее. Раньше я в основном не верил в это! Я скорее против попыток стандартизировать вещи для всех . сегодня более распространены, я думаю, потому что о них проще рассуждать.
Бывает и обратное. Например, когда вы смотрите на «несвязанные задачи» «Титаника», он часто обнаруживает, что следующим идёт слово «boat». Инструмент пропустил это, потому что при оценке контекста он смотрел только назад. Когда мы подробно разбираем такие «несвязанные задачи», это почти всегда что-то подобное. Легко создать несовершенный инструмент.
В целом я не думаю, что приход к единому показателю действительно так важен. Но когда мы его убрали, ранние рецензенты чувствовали себя без опоры, не имея даже приблизительного числа. В наборах данных, которые я изучал более внимательно, учитывая сильные , доля не произвольных смесей ближе к 97%, но это относительно небольшие выборки.
В целом, сведение всего к одному показателю следует воспринимать как общий указатель на режим, в котором находится сеть, а не как нечто точное, что нужно напрямую оптимизировать или к чему следует слишком строго придерживаться. Значительная часть этого эссе посвящена тому, чтобы не снижать размерность так сильно, рассматривая каждый и схему по-разному, в соответствии с их мотивами, глубиной, ролью и т.д. Несмотря на это, грубое число может быть полезным.. и модели со () кажутся примерно схожими. Мы обнаружили аналогичные результаты в моделях с параметрами до триллионов, таких как , которые будут рассмотрены в сопутствующей работе более подробно. Эти проценты сводят многомерную картину к нескольким числам, и точное значение зависит от того, где вы устанавливаете пороги для того, что считается «одним целым» — например, объединять ли близко связанные идиомы на двух языках. Я не думаю, что в интерпретируемости много зависит от этого вопроса. Гораздо важнее то, почему вещи вообще разделяют один .
With better tools and modern models, the situation looks quite different. In preliminary audits of Qwen3-32B, we estimate that roughly 90% of neuron poles have one main job, often with small related offshoots; another ~7% have two related jobs; and only ~2-4% are not yet understood 1 A note on this number: the share of neurons with one job varies depending on how you set the threshold for counting weak activations, depth, density of sub-circuits, and what you view as “one thing”. How far to go into weak activations is a big factor here. There’s a section describing weak activations below. It tends to increase how many “related things” there are, more than whether the neuron is a judgement of something legible. For instance, the Trump neuron’s weak activations bring in MAGA hats and people related to him. The Titanic neuron’s weak activations bring in stories of more general voyages, or steam engines and other technologies of the era. There’s also the question of whether to care about activation percentiles, or fraction of the strongest activations. In general I think what the neuron learns should be trusted, its natural sparsity and activation ranges and so on. Which I used to mostly not believe! I’m somewhat against trying to standardize things across all neurons. Percentiles are more common today, I think because they’re easier to think about. It goes the other way too. For instance, when you look at the Titanic neuron’s “unrelated jobs,” it’s often detecting that “boat” comes next. The tool missed this because it only looked backward when judging context. When we look at these “unrelated jobs” in depth, it’s almost always this kind of thing. It’s easy to build an imperfect tool. Overall, I don’t think coming to a single score is actually that important. But when it was taken out, early reviewers felt unanchored without even a rough number. In the sets I’ve looked at more closely, considering strong activations, it’s closer to 97% non-arbitrary mixtures, but these are relatively small samples. Overall distilling everything into one “cleanliness” score should be taken as a broad pointer to the regime a neural network is in, rather than something precise to either optimize directly or hold too tightly. A lot of this essay is for being less dimensionality reduced, treating each neuron and circuit differently, according to their motifs, depth, role etc. Despite this, a rough number can be useful. . Dense and Mixture of Experts models seem roughly similar. We found similar results in models up to trillions of parameters, like Kimi K3, which the companion paper will cover in more detail. These percentages compress a high-dimensional picture into a few numbers, and the precise number depends on where you set thresholds for what counts as “one thing” – like whether you lump together closely related idioms in two languages. I don’t think much in interpretability hangs on that question. What matters a lot more is why things share a neuron in the first place.
Большая часть оставшейся кажущейся , по-видимому, представляет собой мотив, который я называю . Это просто: по мере роста образует ответвления, подобно тому как ветвь дерева даёт боковые побеги. Например, один , обнаруживавший «iy», начал распознавать «diy», а затем и «do it yourself», где последовательности «iy» вообще нет. Эта идея впервые появилась в забытом подразделе статьи, над которой я работал, Multimodal NeuronsMultimodal in Artificial Neural Networks Гоу, Г., Камарата, Н., Восс, К., и др., 2021. Distill. Ссылки ↓ (2021). Тогда я ещё не наблюдал за ростом в процессе обучения. Теперь это проще, и явление подтверждается везде, где я его видел. Даже исходная не была запутанным клубком. Когда я заново обучаю её первоначальную архитектуру, которая всё ещё даёт «грязные» глубокие слои, и прослеживаю самые нечитаемые , выясняется, что они локально разрастаются в разумные соседние области.
Most of the remaining apparent polysemanticity seems to be a motif I call recursive generalization. It’s simple: as a neuron grows, it sprouts offshoots the way a tree branch sprouts sub-branches. For instance, one neuron that detected “iy” grew to detect “diy,” and then “do it yourself,” which doesn’t contain “iy” at all. This idea first appeared in a forgotten subsection of a paper I worked on called Multimodal Neurons [3] Multimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. References ↓ (2021). At the time, I hadn’t watched neurons grow over training. Now it’s easier, and it holds up everywhere I’ve seen. Even the original InceptionV1 wasn’t knotted. When I retrain its original architecture, which still produces messy deep layers, and follow the least legible neurons I can find, they turn out to be overgrowing locally into reasonable, adjacent territory.
Получается, существовало два объяснения , и я участвовал в выдвижении обоих. В некотором смысле они противоположны: объединяет похожие вещи, а — несвязанные. Сообщество сделало ставку на , и до недавнего времени я тоже. Но теперь я считаю, что в основе своей верным было объяснение через . В итоге остаётся один принцип обучения. Это по-прежнему , но оно оказывается фрактальным. Это гораздо меньше тревожит: из того, как сгруппированы вещи, можно что-то узнать, а из соседства двух объектов в — нет. Поскольку само фрактально, объяснения тоже могут быть фрактальными: начать с базового описания, а затем углубляться, если нужно понять больше. В этом смысле почти вся сеть интерпретируема, если присмотреться достаточно внимательно, особенно если наблюдать за тем, как она росла в процессе обучения.
So there were two explanations for polysemanticity, and I helped propose both. In some ways, they’re opposites: generalization groups similar things together and superposition groups unrelated things together. Superposition is the one the field bet on and, until recently, so did I. But I now think recursive generalization was basically right. That leaves one learning principle after all. It’s still generalization, but it turns out generalization is fractal. That’s far less concerning: there’s something to learn from the way things were grouped, and nothing to learn from two items in superposition. And since the generalization itself is fractal, our explanations can be too: start with a basic explanation, then zoom in when you want to understand more. In that sense, almost the entire network is interpretable if we look closely enough, especially if we look at how it grew over training.
Откуда же взялся такой большой разрыв? Думаю, несколько обычных проблем усилили друг друга. Объясняющие модели 2023 года не могли проходить цикл выдвижения гипотез и их проверки; инструменты и метрики были слабыми, поощряя объяснения, которые могли симулировать активации, а не те, что были верными (эти свойства часто расходятся); никто не знал, каких мотивов в языке ожидать, и люди в целом искали не те вещи; и большинство исследований использовало маленькие или упрощённые модели. В некотором смысле эти модели действительно исчерпали свой потенциал, что сделало естественным объяснением. Но сеть, испытывающая нехватку места, не меняет принципы обучения; её просто становятся шире, как в маленьких моделях компьютерного зрения. Широкие обычно легко разобрать, если знать, что искать. Без этого знания и с примитивными инструментами они выглядят как произвольные смеси.
Why was the gap so large? I think several ordinary problems compounded. The explainer models of 2023 couldn’t run the loop of conjecture and test; the tools and metrics were weak, rewarding explanations that could simulate activations rather than ones that were right, which often come apart; no one knew what language neuron motifs to expect, and people broadly looked for the wrong kinds of things; and most studies used small or simplified models. In a sense, those models really had run out of room, which made superposition the natural explanation. But a network short on room doesn’t switch learning principles; its neurons just get broader, as in the small vision models. Broad neurons are usually easy to break down once you know what to look for. Without that knowledge, and with primitive tools, they look like arbitrary mixtures.
Интерпретируемость обладает удивительной инерцией: как в пазле или кроссворде, любое понимание, которое вы получаете, начинает ограничивать остальную систему. Сначала вы смотрите на один . Если вы не можете его понять, мало что другое помогает: и объясняют через другие , которых вы ещё не понимаете. Это может затруднить начало работы. Однако, когда карта начинает заполняться, всё идёт на удивление хорошо. Если вы не понимаете точно, что делает , вы можете изучить, к чему он подключён, экосистему вокруг него и – в модели со – на чём специализируется его эксперт. Как и при сборке пазла, каждая деталь содержит множество подсказок, и они хорошо структурированы и удобны для проведения экспериментов. Вот почему состояния «почти пустой» и «в основном заполненной» не удивительны; это естественные точки опоры.
Interpretability has a surprising amount of momentum: like a jigsaw puzzle or crossword, any understanding you gain starts constraining the rest of the system. At first, you’re looking at a single neuron. If you can’t understand it, little else helps: circuits and attribution graphs only explain a neuron in terms of other neurons you don’t understand yet. This can make getting started hard. Once the map starts to fill in, though, it goes surprisingly well. If you don’t understand exactly what a neuron does, you can study what it connects to, the ecosystem around it, and – in a mixture-of-experts model – what its expert specializes in. As with a puzzle coming together, every piece comes with many clues, and they’re well structured and easy to run experiments against. That’s why nearly empty and mostly filled in aren’t surprising places to be; they’re the natural anchors.
Возьмём , который отслеживает «чувство собственной правоты, когда дешёвая покупка оказывается лучше дорогой альтернативы». , отслеживающие подобные чувства или социальные сигналы, — одни из самых распространённых, которые мы нашли. Представьте, что вы обнаружили этот , не зная характерных паттернов языковых моделей и не имея опоры на , поскольку ещё не объяснены многие соседние . Большинство людей и агентов ожидают, что будут срабатывать на существительные, распознавая их, но в основном они этого не делают. Посмотрите, где этот срабатывает сильнее всего, и вы увидите кучу, казалось бы, несвязанных запятых.
Take a neuron that tracks ‘a sense of righteousness when a bargain purchase turns out to work better than the expensive alternative’. Neurons that track a feeling or social cue like this are some of the most common we’ve found. Imagine finding this one with no knowledge of language neuron motifs and no circuits to lean on, because few neighboring neurons are explained yet. Most humans and agents expect neurons to detect nouns by firing on them, which they mostly don’t. Look at where this one fires most strongly, and you see a pile of seemingly unrelated commas.
Теперь представьте, что карта в основном заполнена. Вы знаете, что многие распознают едва заметные чувства или социальные контексты. Часто они срабатывают не на словах, передающих это чувство, а на знаках препинания, например на запятых, где модель подытоживает смысл предложения. Либо на слове непосредственно перед тем местом, где чувство становится важным для предсказания продолжения. Поэтому вы читаете окружающие предложения и проверяете эффект : что пишет модель, когда вы усиливаете . Эти наблюдения хорошо согласуются. Вы выясняете, как устроен на основе предшествующих вычислений и что он делает в последующих. И то и другое согласуется с объяснением. Затем вы проверяете : что вызывает сильную отрицательную . Там обнаруживается тонкая разновидность того же сигнала или момент, когда социальный контекст заканчивается. Можно провести и конкретные тесты, например проверить, на какие собственные торговые марки магазинов реагирует . Любая из этих проверок могла бы опровергнуть объяснение, но все они продолжают указывать на одно и то же. Понимание этого уточняет и более общий мотив. Изучив тысячи детекторов едва заметных чувств и социальных контекстов, вы уже знаете, чего ожидать от следующего. Это одна из причин, по которым карта заполняется всё быстрее.
Now imagine the map is mostly filled in. You know many neurons detect subtle feelings or social contexts, and that they often fire not on the words that carry the feeling but on punctuation, like commas, where the model summarizes what a sentence meant, or on the word just before the feeling matters for predicting what comes next. So you read the surrounding sentences instead, and check its steering effects (what the model writes when you turn the neuron up), which line up closely. You look upstream at how it’s built and downstream at what it does, and both line up. You check its negative pole, what pushes it strongly negative, and find a subtle variant of the same cue, or the moment the social context ends. You can run specific tests, like checking which store brands it responds to. Any of these could break the explanation, yet they keep pointing to the same place. And understanding this neuron sharpens the broader motif: after thousands of subtle-feeling and social-context detectors, you start to know what to expect from the next one, which is part of why the map fills in faster as it goes.
Это относится и к инструментам. Когда удаётся понять лишь 2% сети, нельзя определить, где ошибаются инструменты. Когда понятна большая часть сети, необъяснённый остаток прямо указывает на их ошибки. Именно так мы с коллегами обнаружили в . Насколько нам известно, раньше его никто не замечал. Декомпозиция, объединяющая множество , вероятно, скрыла бы этот режим.
It works on the tools too. When you can see 2% of a network, you can’t tell where your tools are broken; when you can see most of it, the unexplained remainder points straight at them. That’s how some coworkers and I found a double-negative regime in SwiGLU neurons that, as far as we know, no one had noticed, and that a decomposition mixing many neurons together would likely have hidden.
Плохая новость о современных нейросетях в том, что они огромны. Хорошая новость в том, что эта огромность помогает: по мере заполнения карты каждое объяснение жёстко ограничивается всем, что его окружает, а большие модели учат более узкие , которые изначально легче распознать.
The bad news about modern neural networks is that they're enormous. The g ood news is that the enormity helps: as the map fills in, every explanation is tightly constrained by everything around it, and bigger models learn narrower neurons that are easier to recognize in the first place.
В этом смысле понять всю сеть может оказаться проще, чем разобраться только в самых интересующих нас частях. Во-первых, трудно научиться мыслить как нейросеть, пока не изучишь её внимательно. Например, «обман» полезен как отправная точка, но строительные блоки, обеспечивающие обманное поведение моделей, вероятно, обладают микроструктурой, имеющей отношение к согласованию ИИ (alignment). Узнать её будет трудно, не заглянув внутрь. Во-вторых, нацеливание на небольшой набор механизмов похоже на работу над одной строкой в кроссворде, где остальные строки ещё пусты. Это выполнимо и может сработать, но без пересечений трудно знать, прав ли ты. Возможно, проще решить всё целиком — или хотя бы более широкие части сети, к которым подключены эти механизмы.
In this sense, understanding the whole network may be easier than understanding just the parts we care about most. First, it’s hard to know how to think like a neural network until you’ve studied it closely. For instance, “deception” is a useful initial frame, but the building blocks that contribute to deceptive behavior by models probably have alignment-relevant microstructure that will be hard to know without going in and looking. Second, targeting a small set of mechanisms is like working on one row of an otherwise empty crossword. It’s doable, and might work, but without the crossings it’s hard to know whether you’re right. It may be easier to solve the whole thing – or at least the broader parts of the network these mechanisms connect to.
Когда я применил такой процесс к современным , он в целом сработал. Агенты могут картировать и , создавать инструменты для их исследования, тщательно проверять объяснения и отслеживать сотни тысяч . Ни разу не возникло момента, когда быстрая нормальная наука переставала работать. Теперь мне кажется, что в основном я понимаю эти модели, по крайней мере достаточно, чтобы знать, с чего начать искать ответ на любой возникший у меня вопрос; в конце концов кроссворд просто оказался заполнен. Пока этот подход работает и на языковых моделях, вплоть до моделей с триллионами параметров. Они ещё не решены из-за огромного размера, но я оптимистично настроен относительно возможности масштабировать этот процесс.
When I ran this process on modern convolutional networks, it basically worked. Agents can map out neurons and circuits, build explorable microscopes and explore them, test explanations thoroughly, and track hundreds of thousands of attribution graphs. There was never a point where rapid normal science broke down. I now feel I basically understand these models, at least enough to know where I’d start asking any question I had; eventually, the crossword just got filled in. So far it has worked in language models too, up to trillions of parameters. Those aren’t close to solved due to sheer size, but I’m optimistic about scaling the process.
Всё это вернуло меня к давней надежде: понять нейросеть напрямую, исследуя её механизмы и данные, протекающие между ними, без предварительных попыток что-либо исправить или распутать. Вместе эти доводы складываются в четыре шага.
All of this has brought me back to an old hope: understanding a neural network directly, by studying its mechanisms and the data flowing between them, without first trying to fix or untangle it. Put together, the argument has four steps.
Нейросети используют один принцип обучения, а не два (если не повсюду, то почти везде, так что это не имеет значения для исследования), поэтому ничто не мешает начать заниматься обычной наукой на их примере.
С современными моделями и инструментами эта наука идёт гораздо лучше, чем ожидают большинство людей.
Понимание накапливается, и по мере заполнения карты работать становится легче. Следовательно, как минимум собственные механизмы сети должны входить в инструментарий.
Смелое предположение, пока умозрительное: возможно, это почти всё, что нам нужно, а задача интерпретируемости окажется гораздо более разрешимой, чем мы считали, — возможно, уже в ближайшее время.
В глубоком обучении уже наблюдалась такая закономерность: простой подход в невероятном масштабе превосходит изощрённое решение. Рич Саттон назвал это «горьким уроком»The Bitter Lesson Саттон, Р., 2019. Незавершённые идеи. Ссылки ↓ Возможно, свой горький урок есть и у интерпретируемости: масштабирование обычного исследования окажется эффективнее конструирования новой хитроумной декомпозиции.
That’s been the pattern for deep learning in general: the simple thing at absurd scale beats the clever one. Rich Sutton called it the bitter lesson [22] The Bitter Lesson Sutton, R., 2019. Incomplete Ideas. References ↓ . Maybe there’s a bitter lesson for interpretability too: scaling ordinary investigation beats engineering a clever new decomposition.
В сопутствующей технической статье будет приведён более подробный отчёт об экспериментах с языковых моделей, включая то, что мы обнаружили относительно различных режимов современных нелинейностей и какие проявляются на разных глубинах. В этом эссе мы кратко рассматриваем множество аспектов и выдвигаем предположения о том, куда всё это может указывать.
A technical companion paper will offer a more detailed account of language model neuron experiments, such as what we’ve found about the different regimes of modern non-linearities and what kinds of circuit motifs show up at different depths. This essay glances at many places and conjectures about where it all might be pointing.
Автомобили и животные
Самым известным полисемантическим является 4e:55 в , который реагировал на произвольную смесь кошек и автомобилей. Его приводили в качестве доказательства того, что могут быть не той единицей изучения, в нескольких наиболее читаемых работах в этой области, начиная с Визуализация признаков Olah, C., Mordvintsev, A. and Schubert, L., 2017. Distill. Ссылки ↓ 2017 года и заканчивая Zoom InZoom In: An Introduction to Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. Ссылки ↓. В Zoom InВ работе «Мультимодальные » мы подошли очень близко. Мы задались вопросом, может ли реагировать на какой-то общий , «возможно, кошачьи глаза и фары автомобилей выглядят похоже», а затем по усовидным элементам и хромированным деталям на решили, что это «истинное OR(cat, car)». Мы были правы, ища общую форму, но, думаю, мы недооценили, насколько далеко простирается . Общим была буква V. Думаю, усы ввели нас в заблуждение, потому что происходит внутри высокоуровневых паттернов. V действительно принимает сигналы от кошки, а задача — повысить , поэтому, как только она находит путь, связанный с кошкой, она добавляет всё, что этот путь приносит. Усы попадают туда за компанию, даже если их «не хочет». На последующих этапах считыватели автомобилей получают небольшой сигнал кошки через V, но он едва достигает выхода: один сработавший детектор кошки сам по себе мало что меняет, поскольку многие работают вместе, поэтому сети никогда не нужен отрицательный для его отмены. Чтобы увидеть общий паттерн, нужно визуализировать то, что общего у входов , а не сам в отрыве., в создании которой я участвовал как соавтор, мы прямо заявили, что он «не реагирует на какое-либо общее свойство автомобилей и лиц кошек».
The most famous polysemantic neuron is 4e:55 of InceptionV1, which looked like an arbitrary mixture of cats and cars. It’s been brought up as evidence that neurons might not be the right unit of study in several of the field’s most widely read papers, from Feature Visualization [1] Feature Visualization Olah, C., Mordvintsev, A. and Schubert, L., 2017. Distill. References ↓ in 2017 to Zoom In [4] Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓ . In Zoom In , which I co-authored, we said outright that it “isn’t responding to some commonality of cars and cat faces”. 2 In Multimodal Neurons we came very close. We asked whether the neuron might be responding to some shared feature, “perhaps cat eyes and car lights look similar,” then decided from the feature visualization’s whiskers and chrome that it was “genuinely OR(cat, car).” We were right to look for a shared shape, but I think we underestimated how far generalization reaches. The shared feature was the V. I think the whiskers misled us because generalization happens inside high-level patterns. The V neuron really does take in cat circuitry, and feature visualization’s job is to raise the activation, so once it finds the cat route it adds everything that route brings. The whiskers come along for the ride, even if the neuron doesn’t “want” them. Downstream, the car readers do get a little cat signal through the V neuron, but it barely reaches the output: one cat detector firing does little on its own, since many work together, so the network never needs a negative weight to cancel it. To see the shared pattern, you have to visualize what the neuron’s inputs have in common, not the neuron on its own.
После месяцев наблюдения за чистыми я задумался: не интерпретировали ли мы неправильно некоторые ранние яркие примеры и ? Канонический полисемантический казался очевидным местом для проверки, поэтому я открыл сетку изображений кошек и машин, которую видел сотни раз, и сделал то, чего никогда раньше не делал: я потратил несколько секунд, размышляя, что же это может быть за один объект. Почти мгновенно стало очевидно: это не «кошка и машина», а «V-образная форма».
After months of seeing clean neurons, I wondered if we’d misinterpreted some early prominent examples of polysemanticity and superposition. The canonical polysemantic neuron seemed like the obvious place to check, so I opened up the cat and car image grid I’d seen hundreds of times before and did something I’d never done: I spent a few seconds wondering what one thing this might be. Almost instantly it was obvious: it’s not a cat and car neuron, it’s a V-shape neuron.
Я посмотрел на связи его : V-образное пламя, V-образные струи воды с пожарного катера, V-образные морды лис. Затем посмотрел на : там была буква O, округлая в тех местах, где V заострена. Зачем произвольной смеси кошек и автомобилей настолько сильная связь с пламенем?
I looked at its circuit connections: V-shaped flames, V-shaped water jets from a fireboat, V-shaped fox faces. I looked at its negative pole: an O, round where the V is pointed. Why would an arbitrary mixture of cats and cars need to connect so strongly to a flame?
входы
4d:493морда лисы
4d:477морда волка
4d:201передняя часть фургона
4e:55
Заострённые→общий
Круг→общий
считыватели
5a:94пламя
5a:352лицо койота
5a:317бокал для мартини
Заострённые заставляет его срабатывать
собака
лиса
кошка
автомобиль
бильярдный стол
скоростной поезд
Круг сдвигает его в отрицательную область
собака
собака
улитка
гольф-мяч
теннисный мяч
часы
Сверху: его самые сильные входы и считыватели (ширина линии отражает силу) и общие визуализации. Снизу показано, что он видит на каждом фото: заостренные объекты заставляют его реагировать положительно, а округлые — отрицательно, независимо от метки. Показать целые фотографии
Затем я перешёл к канонической , которую впервые нашёл в 2019 годуЯ обнаружил это, создавая свой первый интерфейс , который поддерживал только и , соединяющие их . Затем я показал это Крису Олаху и спросил, почему автомобиль должен «въезжать» в этих собак именно так. Мы пришли к выводу, что он должен выполнять своего рода сворачивание, и назвали это . Это было интуитивное объяснение того, что мы видели, поэтому оно не побудило нас глубже погружаться в инструменты, что выявило бы обман оптимизации при и различные другие вещи. Помещение в высокоразмерное пространство казалось разумным ответом.. В работе Zoom InZoom In: An Introduction to Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. Ссылки ↓ V и эта схема приводились как два главных примера того, почему изложенное в ней представление о может быть «слишком оптимистичным». Речь о представлении, что почти каждый оказывается понятным, если изучать его всерьёз.
Then I went to the canonical superposition circuit I first found in 2019 3 I found it while building my first Circuits interface, which only had feature visualization and weights connecting their neurons. Then I took them to Chris Olah and asked why the car would be going into these dogs like this. We came to the conclusion it must be doing a kind of folding, and called it superposition. It was an intuitive explanation for what we saw, so it didn’t prompt diving more into the tools, which would have revealed feature visualization reward hacking and various other things. It being placed into a high-dimensional space felt like a reasonable answer. . The V neuron and this circuit were Zoom In [4] Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓ ’s two main examples of why its picture of neurons, that nearly every one turns out to be understandable if you look seriously, might be “overly rosy”.
, казалось, показывала машину, въезжающую в кучу не связанных между собой собак, словно собаки были своего рода хранилищем в многомерном пространстве, где машину можно было бы позже извлечь по мере необходимости.
The circuit appeared to show a car going into a bunch of unrelated dogs, as if the dogs were a kind of high-dimensional storage place where the car could be recovered later as needed.
Но автомобильный вёл себя иначе. Автомобили и собаки объединялись из-за общих поз. В больше сотни таких . Каждый из них представляет собой отдельный детектор позы, общей для автомобилей, собак и других объектов. Насколько мне известно, раньше их никто не замечал. Поздние слои продолжают строить на их основе вычисления вплоть до конца модели. Информация об автомобиле не пряталась в неком скрытом месте, и ничто напрямую не считывает эту комбинацию. Наоборот, представление продолжает разделяться на , специализирующиеся на автомобилях, и более точные детекторы поз.
But that’s not what the car was doing. Cars and dogs were being brought together because of shared pose. InceptionV1 has more than a hundred of these generalized pose neurons, each one its own clean detector of a pose shared across cars, dogs and other objects, and to my knowledge no one had noticed them. Later layers keep building on them, all the way to the end of the model. The car was not being stored in an obscure place, and nothing directly reads out the combination. It’s the opposite: it’s continuing to differentiate into car specialists and finer poses.
Часть причины заключалась в незнании об обобщённых позы, а часть — в том, что техника, которую мы используем для визуализации иконок изображений (), в более глубоких слоях оказывается подверженной . Цель состоит в том, чтобы найти изображение, которое максимизирует активность , но поскольку это делается с помощью , алгоритм выбирает самый простой путь, что в часто означает собак. В обучающих данных много собак и много , реагирующих на собак, и ранняя оптимизация попадает в них и никогда не выходит. Если вы даже слегка смещаете её в сторону естественных путей, по которым идут лучшие изображения, большинство из них — автомобили, а некоторые — и собаки, и автомобили, из-за общей позы.
Part of the reason was not knowing about generalized pose neurons, and part of the reason is that the technique we use to render icons of images — feature visualization — ends up being reward hacked in deeper layers. The intent is to find an image that maximizes the neuron, but the way that’s done is through gradient descent, and it takes the easiest path, which in InceptionV1 often means dogs. There are lots of dogs in InceptionV1’s training data and a lot of dog neurons, and the early optimization falls into them and never recovers. If you even lightly bias it toward the natural paths the top images take, most of them are cars, and some are both dogs and cars, because of shared pose.
Что мы думали
Arbitrary storage place
Что происходит
Just cars
Общая поза автомобиля и собаки
Мы думали, что автомобиль скрыт среди , связанных с собаками, и считывается позже, но мы неверно визуализировали их. При визуализации через автомобиль два из них являются автомобиля, а два делят позу между автомобилями и собаками.
Может возникнуть соблазн обесценить это , исходя из предположения, что собаки и автомобили встречаются вместе только из-за нехватки места. Возможно, модель «действительно хотела» отдельных для позы собаки и позы автомобиля, и более крупная модель с большим пространством разделила бы их. Верно, что более крупные модели, как правило, имеют более узкие , но при масштабировании сети могут делать это контринтуитивными способами.
It can be tempting to discount this generalization, under the assumption that the dogs and cars are only together because there’s not enough space. Maybe it “really wanted” separate dog-pose and car-pose neurons, and a bigger model with more space would have separated them. It’s true that bigger models tend to have more narrow neurons, but when networks scale up, they can do it in counterintuitive ways.
Если посмотреть на DINOv2: Learning Robust Visual without Supervision Oquab, M., Darcet, T., Moutakanni, T., et al., 2023. arXiv:2304.07193. Ссылки ↓, которая более чем в десять раз больше по размеру и примерно на десять лет старше по архитектуре, то в ней больше позы, но многие из них всё ещё обобщённые. Я наблюдал это в каждой модели компьютерного зрения, которую изучал, независимо от её размера.
Looking at DINOv2 [12] DINOv2: Learning Robust Visual Features without Supervision Oquab, M., Darcet, T., Moutakanni, T., et al., 2023. arXiv:2304.07193. References ↓ , which is more than ten times the size and about ten years of architecture later, it has more pose neurons, but many of them are still generalized. I’ve seen this in every vision model I’ve looked at, of any size.
12×
large4×
medium
small1/75×
Этот же обнаруживается в и в наших больших и средних ConvNeXts: собаки и транспортные средства сгруппированы по тому, как они обращены к камере. Наша самая маленькая модель имеет лишь грубую версию, где машины и собаки объединены вместе, но не по позе.
Кажется, что как человеческие, так и автоматические интерпретаторы сильно смещены в сторону описания как детекторов групп существительных, таких как кошки и машины, а не общих паттернов, таких как буква V. Иногда действительно реагирует на группу существительных. Однако, по моему опыту, чаще это общий паттерн, и лучше понимать как глагол, а не как существительное. Его задача — не называть то, что находится во входных данных, а проводить различие, которое последующие могут использовать: он разделяет два тонких паттерна на своём положительном и (V против O) и соответственно направляет поток к разным .
Both human and automated interpreters seem strongly biased toward describing neurons as detectors for groups of nouns, like cats and cars, rather than for a shared pattern, like a V. Sometimes a neuron really does respond to a group of nouns. In my experience, though, it’s more often a shared pattern, and the neuron is better understood as a verb than a noun. Its job isn’t to name what’s in the input but to draw a distinction downstream neurons can use: it separates two subtle patterns at its positive and negative poles (a V versus an O) and pushes the flow of activations toward different neurons accordingly.
Я часто могу снять блокировку в понимании , задав вопрос: если бы я вообще не мог использовать группы существительных, как бы я описал этот другому человеку? Обычно общий паттерн бросается в глаза сразу, и его легко протестировать на других группах существительных (для V: синкансэны, бильярдные столы). Я подозреваю, что это основной источник ошибочной в средних слоёв. Многие объяснения, которые я видел и которые называют , выглядят мне как единый паттерн, описанный как список существительных.
I can often unblock my understanding of a neuron by asking: if I couldn’t use groups of nouns at all, how would I describe this neuron to someone else? Usually the shared pattern pops out right away, and it’s easy to test on more groups of nouns (for the V: shinkansens, pool tables). I suspect this is the largest source of misattributed polysemanticity in mid-layer neurons. Many explanations I’ve seen that call a neuron polysemantic look to me like a single pattern described as a list of nouns.
Мы должны рассматривать , отвечающий за два или три понятия, как один с несколькими сгруппированными значениями. Вероятно, такая группировка не стала проблемой для сети: значения оказываются вместе, потому что с точки зрения сети они похожи. Это делает группировку подсказкой о том, как мыслит сеть, и её изучение может выявить , о которых мы не знали, как это произошло с кошками и машинами в данном случае. Часто дополнительные значения также исчезают при более тщательном рассмотрении, оказываясь незначительными и редко срабатывающими. Наконец, некоторые кажущиеся значения — это просто следствие несовершенства наших инструментов, и в этом эссе есть несколько примеров: в , нечитаемый регулятор значимости, затрудняющий визуализацию , и при , который мы только что видели. Сохранение исходного целостным делает эти ошибки видимыми, поэтому коррекция может продолжаться. Если бы мы использовали оптимизацию для получения более чистого списка, мы могли бы потерять многие из этих подсказок.
We should treat a neuron that means two or three things as one neuron with a few grouped meanings. The grouping probably wasn’t a problem for the network: the meanings sit together because, from the network’s point of view, they’re similar. That makes the grouping a clue to how the network thinks, and following it can turn up generalizations we didn’t know about, as cats and cars did here. Often the extra meanings also melt away on closer inspection, turning out to be minor and rarely active. Finally, some apparent meanings are just our tools being bad, and this essay has several examples: the double-negative regime of SwiGLU, an unread saliency knob that makes the residual stream hard to visualize, and the reward hacking in feature visualization we just saw. Keeping the original neuron whole keeps these errors visible, so the error correction can continue. If we’d used optimization to get a cleaner list, we might have lost many of these hints.
История ошибок микроскопов
История интерпретируемости, как я её вижу, во многом сводится к тому, что объект под микроскопом оказался лучше, чем мы думали. Микроскоп просто был настроен неверно, а то, что требовало настройки, часто оказывалось довольно тонким.
The story of interpretability, as I see it, has largely been one of finding out that what was under the microscope was better than we thought. The microscope just wasn’t tuned right, and what needed tuning was often pretty subtle.
Можно сказать, что современная интерпретируемость нейросетей началась с . Этот метод создаёт синтетическое изображение того, на что реагирует сильнее всего, те самые знаменитые «психоделические» картинки. Некоторое время они выглядели не слишком хорошо. Можно было вполне разумно заключить, что чему-то научились, но ничего особенно там нет. Оказалось, что методу не хватало . Когда исследователи её добавили, визуализации тех же самых стали чёткими.
Modern neural network interpretability arguably started with feature visualization, which renders a synthetic image of what a neuron responds to most: the famous psychedelic pictures. For a while they didn’t look very good. You could reasonably conclude the neurons had learned something, just nothing very clean. It turned out the method was missing transformation robustness. Once researchers added it, the same neurons came out crisp.
Но так удаётся продвинуться лишь до определённой глубины модели. Ближе к концу снова начинает давать сбои по двум причинам: из-за , который мы видели в автомобильной , и не вполне подходящей . Для исправления не понадобилось ничего изощрённого. Несколько небольших изменений разумных настроек, и теперь мы можем заглянуть гораздо глубже в сеть. те же, инструмент наблюдения лучше.
But that only gets you so far into the model. Near the end, feature visualization starts to break down again, for two reasons: the reward hacking we saw with the car circuit, and regularizations that weren’t quite right. Fixing it didn’t require anything fancy. A few subtle tweaks to reasonable settings, and now we can see much deeper into the network. Same neurons, better microscope.
стиля 2009 года20172026Наиболее сильные изображенияСредний слой
Наиболее сильные изображения
Поздний слой
Наиболее сильные изображения
Небольшие изменения сначала выделяют средний , а затем поздний.
Но дело было не только в микроскопии. Модель тоже требовала настройки. , ранний в этой области, в последних слоях был совершенно неинтерпретируем. Одна оценка гласила: «Насколько мне известно, на финальном слое практически нет интерпретируемых », что близко к моим собственным воспоминаниям: я бы, наверное, оценил их долю примерно в 5%. Вот как они выглядели.
But it wasn’t all the microscope. The model needed to be tuned too. InceptionV1, the early model organism of the field, was totally uninterpretable in the late layers. One estimate said “To the best of my knowledge, there are essentially no interpretable neurons on InceptionV1’s final layer,” which is close to my own recollection, I’d have maybe said 5%. This is what they looked like.
Примеры из датасета
позднего слоя , показанный с помощью оптимизированных представлений и изображений.
Наиболее распространённое объяснение, насколько мне было известно, заключалось в том, что высокого уровня требовалось представить слишком много для имеющегося числа и параметров, поэтому сеть начала произвольно упаковывать те, которые не принадлежат вместе, поскольку они не сталкиваются. Ранние слои были , потому что ранних слоёв требовалось представлять не так много.
The leading explanation as far as I knew was that there were too many high-layer features needed to be represented for the number of neurons and parameters there were, so it started packing ones that don’t belong together arbitrarily, since they don’t collide. The early layers were monosemantic because not as many early layer features needed to be represented.
Но это не было правильным объяснением. Вот более современная сверточная сеть с тем же количеством параметров и набором данных, но с , и несколькими другими улучшениями. Последний слой прекрасен.
But this wasn’t the right explanation. Here’s a more modern convolutional network with the same number of parameters and dataset, but with residual connections, LayerNorm, and a couple other improvements. The last layer is beautiful.
7,06 млн · с сопоставлением по количеству параметров28.6M
‹
Божьи коровкиТерьерыПлатипусыМолочные канистрыЖёлтый на зелёномАлтариТыква мускатнаяКрокодилыВеличественные фасадыКоатыМагнитофоныКроликиБородавочникиЗлатоглазки грибыПолугусеничные машиныПуделиКатераЗакрученные рога
20 самых сильных ответов каждого из 50 000 изображений, в порядке убывания. Метки отмечают изображения из других классов.
Таким образом, потребовались две вещи. Во-первых, сеть должна была хорошо обучиться, используя архитектуру, разработанную людьми, полностью сосредоточенными на этой цели и не заинтересованными в интерпретируемости. — один из примеров: он был введён, чтобы облегчить обучение более глубоких сетей, и, похоже, он также помогает глубоким слоям оставаться концептуально чистыми, что может быть связано. Во-вторых, нам нужны были инструменты, достаточно мощные, чтобы ясно их видеть.
So two things were required. First, the neural network needed to learn well, using an architecture designed by people fully focused on that goal and with no interest in interpretability. The residual stream is one example: it was introduced to help learn deeper neural networks, and it also seems to help the deeper layers be conceptually clean, which may be related. Second, we needed tools strong enough to see them clearly.
Последний слой был одним из главных доказательств того, что сети практически фундаментально неинтерпретируемы, поскольку способ их обучения приводит к смешиванию несвязанных . Замена казалась единственным выходом. С инструментами той эпохи я оценивал это примерно в 5%, другие исследователи — около 0%. С более совершенными инструментами интерпретируемости (исправленная , методы визуализации и т. д.) на той же сети этот показатель составляет около 50%. Речь идёт о модели 2014 года, чьи контрольные точки и детали обучения были утеряны. При повторном обучении той же архитектуры с более разумной современной показатель возрастает до 70%. В того же размера он составляет около 99%. Эти сети поддаются исследованию .
The last layer of InceptionV1 was one of the main pieces of evidence that neural networks were almost fundamentally uninterpretable, since the way they learn overlaps unrelated mixtures. Replacing the neurons seemed like the only option. I put it around 5% with tools of that era, others at ~0%. With better interpretability tools (fixed feature visualization, methods for visualizing attribution etc) it’s more like 50% on the same network. This is all with the 2014 model whose checkpoints and training details were lost to time. Retraining the same architecture with more reasonable modern regularization it’s more like 70%. In the ConvNeXt of the same size, it’s about 99%. They’re explorable here .
Итак, мы показали, что последний слой можно исправить. Но что он делал до того, как его исправили? Даже до архитектурных улучшений он не объединял понятия произвольно. Когда мы повторно обучили модель и наблюдали формирование , он начал с желтых цветов на фотографиях, где иногда встречались собаки. Затем он разрастался по каждому аспекту этих изображений: в сторону других видов природы, в сторону зеленых объектов, таких как мячи, и в сторону собак без каких-либо цветов. Это верно для каждого , который я рассматривал. Улучшенная архитектура демонстрирует ту же закономерность, но в гораздо меньшей степени.
So we’ve shown the last layer was fixable. But what was it doing before it was fixed? Even before the architectural improvements, it wasn’t putting things together arbitrarily. When we retrained the model and watched a neuron form, it started on yellow flowers, in photos that sometimes included a dog. Then it grew along each facet of those photos: toward other kinds of nature, toward green objects like balls, and toward dogs without any flowers. This is true of every neuron I looked at. The improved architecture shows the same pattern, but much less of it.
Серая полоска за каждой строкой показывает долю сильнейших изображений .
в и один в , обученные на одних и тех же данных, которые оба изначально реагируют на поля рапса. Обе модели рано начинают тянуться к мячам и фруктам; позволяет им отпустить их и остаётся на полях, тогда как продолжает расширяться, переходя к собакам, а затем к брокколи, пока поля почти не исчезнут.
Мы называем это : обобщает более чем по одной оси, часто сначала по одной оси, а затем разрастаясь наружу способами, которые легко проследить локально, но которые в итоге не позволяют ему оставаться «».
We call this recursive generalization: a neuron generalizing along more than one axis, often first along one axis, then sprouting outwards in ways that are easy to follow locally, but stop it from being “monosemantic” in the end.
Например, языковой модели реагирует на «iy», в том числе в слове «Miyazaki», затем на «diy», а затем на «do it yourself», которое уже не содержит «iy».
For instance, a language-model neuron responds to “iy,” including in “Miyazaki,” then to “diy,” and then to “do it yourself,” which no longer contains “iy” at all.
. «iy» растет в нескольких направлениях. От "diy" он достигает "do it yourself", где вообще нет "iy". Концептуальная иллюстрация.Повтор ↻
Такие примеры встречаются повсюду, и в моделях компьютерного зрения, и в языковых моделях. Например, , связанный с геологией, по мере начинает реагировать и на Cesium, библиотеку JavaScript для геологии.
There are examples all over the place in both image and language models. Like a geology neuron that generalizes into Cesium, a geology JavaScript library.
Обычно произошедшее настолько очевидно, что трудно решить, стоит ли вообще называть это как-то иначе, чем обычным . Например, , реагирующий на врагов, срабатывает на русское стихотворение о врагах. Иногда связь менее очевидна, но всё ещё правдоподобна. Srinivasen также слабо срабатывает на базу данных белков UniProt. С этим проектом связано несколько Сринивасенов, но уверенности пока нет.
Usually it’s very obvious what happened, to an extent where it’s hard to know whether to just call it normal generalization or not. Like an enemy neuron that fires for a Russian poem about enemies. Sometimes it’s less clear but still plausible. A Srinivasen neuron also lightly fires for the UniProt protein database. The project has several Srinivasen’s associated with it, but it’s hard to know for sure.
Топ-8 срабатываний
String is a scalar string or1-element string array, then STRSPLIT returns an array containing72
determine the average of the values0 to9:↵SPAWN, ’test_pipe’, UNIT62
Set this keyword to make the "Cancel" button the default selection for the dialog. The default selection61
Stage,↵ ModelExperimentalSceneMeshPrimitive,↵} from "../../../Source/Cesium.js";↵↵describe("Scene59
of KREEP-rich rock at the base of the crust left by the original crystallization of the54
Highlands are older than the Northern Lowlands, based on the larger number of impact craters seen covering54
ers during their final days. The dramatic footage was taken on December14,2054
in the night sky, it's really easy to see the difference between the dark lowland plains called54
Сгруппировано по маршруту доля в топ-100
Кора Луны и Марса44%поступает черезL31Марс, планетыпродвигаетВысокогорьерядомтемным side is also home to one of the largest and oldest impact features in the solar system, the South of KREEP-rich rock at the base of the crust left by the original crystallization of the
Миссии на Луну42%поступает черезL28Лунапродвигаетлунадалекократер crust. But with fuel running low, NASA decided to fly them into a mountain near the Moon's the moon to distort images, the LROC (Lunar Reconnaissance Orbiter Camera) is now
древние ударные события, Марс6%поступает черезL30жизнь на других планетахпродвигаетравнинамибассейнМарс exist.↵“3.4 billion years ago a large meteorite triggered the first wave of the tsunami)↵In other words, the internal pressure buildup due to the massive Hellas impact quite pos
Код Cesium и IDL8%поступает черезL6имена вроде Cesiumпродвигает.jsобъектыпрограммное обеспечение and precipitation rate values from which CesiumJS can then generate↵pointPrimitive objects. Because some of number of colors, once initialized, cannot be changed without first exiting IDL.↵Colormaps define
Подробнее
Кора Луны и Марса
нагорья, ближняя и дальняя стороны, бассейн Южный полюс — Аиткен
поступает черезL31Марс, планетыL28Луна
просыпается↑ L34китайская лунная программа↑ L37глубокое время
стремится кВысокогорьерядомтемнымвлияние
in the night sky, it's really easy to see the difference between the dark lowland plains called
Миссии на Луну
космические аппараты на орбите, съёмка и столкновение с Луной
поступает черезL28ЛунаL7Луна, ранняя
просыпается↑ L36космические аппараты, миссии↑ L37воздействие на поверхность
стремится клунадалекократерспутники
but they’re running out of fuel so NASA will command them to hit the surface.↵Because it will
древние ударные события, Марс
Эллас, Вальес Маринерис, ранняя Земля; более слабые срабатывания
поступает черезL30жизнь на других планетахL32крупные вулканы
стремится кравнинамибассейнМарс
pictures in one week, focusing on a crater near the western terminus of Valles Marineris
Код Cesium и IDL
библиотека глобуса CesiumJS и документация по обработке изображений IDL/ENVI
поступает черезL6имена вроде CesiumL32числа в технической документации
either a space or a comma is detected. In this case, IDL performs a simple string search
Самые сильные срабатывания , связанного с планетарной геологией, смешивают лунную кору с кодом IDL и Cesium. Сгруппированные по , которые их питают, они разделяются на три грани одного ядра — планетарные поверхности — и одно ответвление — код, который приходит своим собственным путём.
Мы поговорим об этих рекурсивно обобщённых ответвлениях и о том, насколько они важны, в разделе о языковых моделях. Здесь же мы хотим обсудить, что собой представляет этот мотив.
We’ll talk about these recursively generalized offshoots and how much they matter in the language model section . Here we just want to talk about what the motif is.
Мы впервые упомянули об этом в Multimodal NeuronsMultimodal in Artificial Neural Networks Гоу, Г., Камарата, Н., Восс, К., и др., 2021. Distill. Ссылки ↓, называя их «сросшимися ». Я забыл об этом, пока не вернулся к самым известным моделям области, спустя месяцы изучения . Насколько я помню, никто, включая меня, не предполагал, что это может быть общим объяснением, например, того, что не так с последним слоем . Без контрольных точек обучения мы не могли наблюдать, как оно формируется, но объяснение было в основном верным. Приложение объясняет, почему я считаю новое название более точным.
We first hinted at this in Multimodal Neurons [3] Multimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. References ↓ , calling them “conjoined features.” I’d forgotten until I went back through the field’s most famous models, months into studying recursive generalization. As far as I can remember, no one, including me, suggested it might be the general explanation, for instance for what was wrong with InceptionV1’s last layer. Without training checkpoints we couldn’t watch it form, but the explanation was basically right. The appendix explains why I think the new name is more accurate.
не кажется особенно смелым объяснением. Можно сказать, что именно этого и следует ожидать от обычного . Но для предложили и гораздо более смелое объяснение: новый принцип обучения.
Recursive generalization isn’t a particularly bold explanation, it’s arguably just what we should expect out of ordinary generalization. But there’s also a much bolder explanation that has been proposed for polysemanticity, a new learning principle.
Главный принцип обучения, который мы наблюдаем повсюду, это . При объекты объединяются благодаря общей закономерности. Её полезно сосредоточить в одном месте, чтобы затем использовать в дальнейших вычислениях. При несвязанные объекты размещаются вместе, потому что не мешают друг другу.
Эти объяснения дают противоположные предсказания. должно быть локальным, а нелокальной, поскольку при ней рядом должны оказаться очень разные объекты.
The main learning principle we see everywhere is generalization. With generalization, things are put together because of a shared pattern that it’s useful to have in one place, so it can be built on. With superposition, unrelated things are placed together because they don’t interfere. These have opposite predictions: generalization should be local, superposition should be non-local, since it would want very different things to be near each other.
стремилось бы к «собака с висячими ушами», который можно представить как множество слегка различающихся висячих ушей разных видов и под разными углами, объединённых вместе. стремилась бы к «собака с висячими ушами + латинская поэзия».
Generalization would want a floppy ear dog neuron, which can be thought of as lots of slightly different floppy ears at different angles and kinds together. Superposition would want a floppy ear dog + Latin poetry neuron.
Произвольная упаковка
Несвязанные вещи разделяют один
Похожие вещи разделяют один
4816
Концептуальная иллюстрация. В обеих панелях присутствуют те же 32 вещи; похожие цвета и формы обозначают похожие вещи. Меньшее количество делает , осуществляющие , более грубыми, но никогда не раздробленными. Наведите курсор или нажмите на , чтобы найти его вещи в обеих панелях.
Определения здесь переплетаются. Наряду с , Zoom InZoom In: An Introduction to Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. Ссылки ↓ предложили идею о том, что являются фундаментальной единицей сетей. В зависимости от контекста, может означать либо «больше , чем измерений» (что верно даже для полностью моносемантической сети, поскольку её композитны), либо принцип обучения, подобный приведённому выше, который применяется то к тому, чему учатся , то к тому, куда распределяются .Например, в слое 4b практически отвечают за такие части автомобиля, как окна, кузов и колёса, которые следующий слой объединяет в «автомобиль» 4c:447. С точки зрения разумно утверждать, что « автомобиля» содержится не только в 4c:447, но и в комбинации 4b, формирующих его. Таким образом, в соседних слоях присутствуют два автомобиля, использующие практически идентичные механизмы. В рамках подхода « больше, чем размерностей» первый находится в , а второй может не находиться. В смысле неформальной заметки Distributed Representations: Composition & Superposition, первый распределён, но за счёт , а второй вообще не распределён. Это часть причины, по которой мне трудно оперировать предполагаемыми , и почему я обычно предпочитаю конкретные механизмы, такие как , и конкретные фрагменты данных.
The definitions get tangled here. Along with superposition, Zoom In [4] Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓ introduced the idea of features as the fundamental unit of neural networks. Depending on where you look, superposition then means either “more features than dimensions,” which even a fully monosemantic network would satisfy, because its neurons compose, or a learning principle like the one above, applied sometimes to what neurons learn and sometimes to where features go. 4 For instance, InceptionV1’s layer 4b has basically monosemantic neurons for car parts like windows, car bodies, and wheels, which the next layer assembles into a car neuron, 4c:447. In the feature view, it’s reasonable to say the “car feature” isn’t just in 4c:447, but also in the combination of 4b neurons that builds it. So there are two car features in adjacent layers, sharing almost exactly the same mechanics. In the “more features than dimensions” view, the first is in superposition and the second may not be. In the sense of the informal note Distributed Representations: Composition & Superposition , the first is distributed, but by composition, and the second isn’t distributed at all. This is part of why I find hypothesized features hard to think with, and why I usually prefer specific mechanisms, like neurons, and specific pieces of data.
Получается, само слово «» находится в нескольких распространённых значений. Здесь мы сосредоточимся на принципе обучения применительно к таким механизмам, как , потому что от того, существует ли он, в значительной мере зависит, насколько хороши или плохи перспективы интерпретируемости. К тому же это сравнительно легко проверить: и предсказывают почти противоположные вещи, и можно наблюдать за ростом , чтобы увидеть, что именно происходит.
So “superposition” is itself in superposition between several common uses. We focus on the learning principle applied to the mechanisms like neurons, because whether it forms holds such a disproportionate share of the good or bad news for interpretability. It’s also fairly easy to test: recursive generalization and superposition predict nearly opposite things, and you can watch a neuron grow and see which one happens.
Когда я говорю о в этом эссе, я имею в виду именно эту версию. Вопрос о том, что больше, чем измерений, мы рассмотрим позже — я в основном не считаю это плохой новостью.
When I say superposition in this essay, I’m referring to this version, and we’ll address the question of “more features than dimensions”, which I basically don’t think is bad news, later.
пробелов
часто является скорее утверждением об наблюдателе, чем о . Она говорит, что хорошего объяснения ещё нет. Есть несколько причин, по которым это может быть:
Polysemanticity is often more a claim about the observer than the neuron. It says there’s no good explanation yet. There’s a few reasons that could be:
Плохие инструменты: наша линза или микроскоп недостаточно хороши
Плохие объяснения: созданы с помощью этих инструментов
Плохое обучение: сеть обучалась плохо из-за плохой архитектуры, обучающих данных или чего-то ещё
: при ветвился в нескольких связанных направлениях
: изменение принципа обучения, при котором сеть упаковывает не связанные между собой вещи в одни и те же , потому что они редко сталкиваются.
В течение многих лет я был убеждённым сторонником . Я начал изучать языковых моделей не из-за какого-либо интереса к самим или , а потому, что меня интересовало, есть ли у агентов научный вкус! Я хотел увидеть, задают ли они хорошие вопросы, проверяя объяснения, и начал с только как с базового уровня. Я ожидал, что они столкнутся с неразрешимыми фрагментами в . Это дало бы новую базовую линию для того, насколько чистыми на самом деле являются , после чего агенты могли бы продолжить работу с более чистым обученным базисом. Но этого не произошло, потому что продолжали появляться, сводясь к простому объяснению, которое делало удивительные предсказания, оказавшиеся верными.
For years I was a staunch superposition believer. I started studying language model neurons not out of any interest in neurons or superposition, but because I was interested in whether agents had research taste! I wanted to see if they’d ask good questions as they tested explanations, and started with neurons only as a baseline. I expected them to run into intractable feature fragments in superposition. That would produce a new baseline for how clean neurons really are, then the agents could continue with some cleaner learned basis. But it never came, because the neurons kept coming, resolving to a simple explanation that made surprising predictions that held.
В передовой языковой модели я обнаружил , который в основном срабатывал на «pr», но также и на множестве строк Base64 URL, а также на некоторых бенгальских словах. Я подумал, что это, наконец, произвольная смесь. Но декодируйте URL: это слова «pr». Переведите бенгальский: «pr».
In a frontier language model, I found a neuron that mostly fired on “pr”, but also on a bunch of Base64 URL strings as well as some Bengali. I thought this must finally be an arbitrary mixture. But decode the URLs: “pr” words. Translate the Bengali: “pr”.
Иллюстрация: декодированный или транслитерированный шум оказывается «pr».
В Qwen коллега обнаружил , который стандартные методы с использованием классифицируют как « запятой». Однако при более детальном анализе выяснилось, что он отслеживает Колорадо: телефонные номера, сленг и связи с другими Колорадо. Управление этим заставляло модель хотеть пойти в поход. Запятые служили местом, где он хранил текущее резюме контекста Колорадо на данный момент. В целом, , кажется, концентрируется на пунктуации, что мы называем мотивом резюме. Как только вы это знаете, понять многие похожие становится легче.
In a dense Qwen model, a coworker came across a neuron that standard top-k automated interpretability lists as a “polysemantic comma neuron”. But looking more closely, it turned out to track Colorado: phone numbers, slang, and connections to other Colorado neurons. Steering it made the model want to go hiking. The commas were where it stored a running summary of the Colorado context so far. In general attention seems to collect on the punctuation, which we call the summary motif. Once you know it, a lot of similar neurons get easier to understand.
Новая работа, новый город, новую жизнь, a Денвер Бронкос,303 код города,зеленыйchile,воскресенья библиотека,Redкамни,синийптица дни для катания на порошке,Санitas начало тропы,четырнадцатьers.
Новая работа, новый город, новый договор аренды, адрес в Денвере, код города 303, зеленый чили, воскресенья Бронкос, Красные скалы, дни с голубым порошковым снегом, начало тропы Санитас, четырнадцатитысячники. Первые три запятые не активируются; как только появляется Денвер, каждая запятая активируется, достигая максимальной силы после зеленого чили.
My plan for this weekend is to go to the library and study for the test. I also want to visit my grandmother and help her with some gardening.
Управлять
Запятые остаются тёмными, пока не появляется Колорадо, а затем становятся ярче по мере накопления информации о нём. этого заставляет модель планировать поход.
В других случаях у нас просто не хватало данных. Сначала мы не включали длинный контекст, двух абзацев казалось достаточно. Но это случайно заставило все , работающие с длинным контекстом, выглядеть .
Other times, we just didn’t have enough data. At first we didn’t include long context, two paragraphs felt like enough. But this accidentally made all the long-context neurons look polysemantic.
We spent our second week in Hanoi, staying with a friend of my cousin's.
Most mornings started slowly. We would wake up late, read for a while, and argue about where to eat.
My sister called on Tuesday. The dog had learned to open the fridge, and she wanted to know when we would be home.
On Thursday we found a small place near the station. The owner poured the coffee slowly, and told us about the university where her son studies.
Что увидел агент↑Расширить контекст
Один только последний абзац намекает на , отвечающий за кофе и университеты; причина этого указана выше.
В другом случае выглядел как произвольный беспорядок, без сильного срабатывания. Оказалось, что он искал специфические на страницах спама по SEO для здоровья, и как только у нас появился достаточно широкий набор данных, это стало понятно.
In another case a neuron looked like an arbitrary mess, with nothing firing strongly. It turns out it looked for specific signs within pages of health SEO spam, and once we had a sufficiently broad dataset, it was understandable.
За сотни подобных случаев ничто не поколебало мою веру в . Менялось лишь место, где я её искал. Если сильные оказывались , начинали искать в слабых, в комбинациях или в , которые я ещё не изучал. А может быть, и между самими слоями.
Across hundreds of cases like these, nothing shook my belief in superposition. It just kept moving. If the strong activations came back clean, superposition would move to the weak ones, or to combinations of neurons, or to the neurons I hadn’t looked at yet. Or maybe across layers themselves.
Но в конце концов я задумался: что же происходит? Если это не какой-то драматичный и затяжной случай предвзятости отбора, то что-то не сходилось с ранними . Поэтому я вернулся к исходным данным, и первоначальные доказательства рухнули. Это и привело к написанию данного эссе.
But eventually I wondered what was going on. Unless this was some dramatic extended case of selection bias, something wasn’t matching the early model organisms. So I went back, the original evidence fell, and that led to this essay.
Теперь я считаю, что ошибочно принимал за нулевую гипотезу, тогда как она должна была быть последней из рассматриваемых. Это самая радикальная и наименее проверяемая гипотеза. На первый взгляд она кажется бессмысленной. Однако именно так выглядят и плохие инструменты (например, хакинг награды при ), и , которое вы ещё не проследили ( «iy»), и неудачная архитектура (5b в ), и , которое вы ещё не поняли (кошка и машина).
I now think I was making superposition the null hypothesis when it should have been the last hypothesis, since it’s the most radical and the least testable. It just looks like things that don’t make sense. But that’s also what bad tools look like (feature visualization reward hacking), or recursive generalization you haven’t followed yet (“iy” neuron), or a bad architecture (5b of InceptionV1), or generalization you haven’t understood yet (cat and car).
Думаю, отчасти дело в том, что просто казалась правдоподобной. В статье Anthropic Softmax Linear UnitsSoftmax Linear Units Эльхаге, Н., Хьюм, Т., Олссон, К. и др., 2022. Transformer Thread. Ссылки ↓ 2022 года об этом сказано прямо: «В сообществе часто принимают за гипотезу по умолчанию лишь потому, что она интуитивно кажется убедительнее других объяснений, хотя свидетельств мало».В следующем предложении статья указывает, что её результаты являются умеренным доказательством существования . Это доказательство является косвенным, по собственному выражению авторов: подавляет , распределённые по многим , дополнительный восстанавливает производительность, и после выглядели менее связанными с его основной задачей, что статья интерпретирует как пронос через малые . Мы же читаем это как свидетельство о в архитектуре, созданной для его подавления, а не о том, что упаковывают вместе несвязанные вещи, что является тем смыслом, который нас интересует. Различить эти два случая при сложно даже с современными инструментами, поскольку смысл меняется во всех направлениях одновременно по мере ослабления , а в 2022 году это было ещё сложнее для всех нас. В статье также отмечается, что её обсуждение было заменено работой « of », которую мы рассматриваем в приложении. Мы поднимаем этот вопрос не как критику какой-либо из статей, а потому, что это единственное место, которое нам известно, где кто-то прямо сказал, насколько мало реальных доказательств существует, и мы думаем, что люди всё ещё часто предполагают, что их больше, чем есть на самом деле. Насколько мне известно, после моего первого примера, который оказался ошибочным, никто не нашёл в реальной сети. Я не вижу ничего подобного в реальных моделях, хотя ожидал найти. На мой взгляд, такие утверждения должны быть очень хорошо обоснованы. Это радикальное объяснение, и его подтверждение стало бы большой, крайне неприятной новостью о том, как нам следует изучать нейросети.
I think part of what was going on was that superposition just felt right. Anthropic’s Softmax Linear Units [20] Softmax Linear Units Elhage, N., Hume, T., Olsson, C., et al., 2022. Transformer Circuits Thread. References ↓ paper said as much in 2022: “In the mechanistic interpretability community, superposition is often treated as the default hypothesis simply because it seems intuitively more compelling than other explanations, but there is little evidence.” 5 In the next sentence, the paper says its own results are moderate evidence for superposition. That evidence is circumstantial, in the paper’s own word: SoLU suppresses activations spread across many neurons, an extra LayerNorm restores performance, and after the LayerNorm a neuron’s weak activations looked less related to its main job, which the paper reads as features being smuggled through small activations. We read it as evidence about distributed representation in an architecture built to suppress it, rather than about neurons packing unrelated things together, which is the sense we care about. Telling the two apart in weak activations is hard even with today’s tools, since meaning shifts in every direction at once as activations weaken, and it was harder still in 2022, for all of us. The paper also notes that its discussion of superposition has been superseded by Toy Models of Superposition, which we address in the appendix. We bring it up not as a criticism of either paper, but because it’s the only place we know of where someone said plainly how little real-world evidence there was, and we think people still often assume there’s more than there is. To my knowledge, no one has found a superposition circuit in a real network since my original one, which was an error. I don’t see anything like it in real models, despite expecting to, and I think the bar for claiming it should be high, since it’s such a radical explanation and would be big news, terrible news, for how we should study neural networks.
Конечно, есть риск противоположной ошибки: объяснять пробелы предположением, что для каждого обязательно найдётся осмысленное объяснение. По двум причинам меня это меньше тревожит. Во-первых, каждую из других причин можно проверить. Более удачный инструмент либо позволяет понять , либо нет. Повторное обучение с более удачной архитектурой показывает, была ли проблема в обучении. А можно наблюдать по мере роста, шаг за шагом. Единственный симптом состоит в том, что что-то не удаётся понять. Во-вторых, настоящие объяснения обычно конкретны и легко проверяемы. Заподозрив, что связан с Колорадо, измените его и посмотрите, что напишет модель. Если реагирует на конкретное телевизионное клише, круг вещей, соответствующих такому объяснению, очень мал. А формулировка «что-то непонятное» охватывает всё остальное.
Of course, this risks the opposite error, an explanation of the gaps: assuming every neuron must have a sensible story. Two things make it less worrying. First, each of the other causes can be tested. A better tool either resolves the neuron or it doesn’t; retraining with a better architecture shows whether learning was the problem; and recursive generalization can be watched as it grows, in small steps. Superposition’s only symptom is that something doesn’t make sense. Second, real explanations tend to be narrow and easily testable. Once you suspect a neuron is a Colorado neuron, steer it and see what it says. If a neuron fires for some narrow TV trope, the set of things that could count as that explanation is tiny, while “something that doesn’t make sense” covers everything outside it.
Кроме того, нам не нужно навязывать объяснение, которого у нас нет. Если может выполнять несколько несвязанных задач и вы не уверены, можно так и сказать. Я считаю, что должно стоять высоко в списке подозреваемых, и его легко проверить, если у вас есть . Теперь я думаю, что должна быть далеко в конце списка.
Also, we don’t have to force an explanation we don’t have. If a neuron might do a couple unrelated things and you’re not sure, it’s fine to say so. I think recursive generalization should be high on the list of things to suspect, and it’s easy to check if you have training checkpoints. I now think superposition should be far down the list.
Исследование моделей изображений
Малые модели изображений могут казаться устаревшими, но я считаю, что они имеют большое значение для этого вопроса, поскольку мы можем изучать их достаточно ясно. Именно в них зародилась большая часть первоначальных опасений: там мы наблюдали то, что выглядело как хаос высокого разрешения, а не неоднозначность низкого разрешения. Языковые модели огромны, у нас нет таких инструментов, как , которые облегчают нашу работу, механизм смешивает различные типы механизмов вместе, а многие их паттерны удивительны. Как я показал выше, даже паттерны в компьютерном зрении могут быть контринтуитивными, а в языковых моделях ситуация ещё хуже. Каждый из этих недостатков может заставить моносемантический выглядеть . Если вы смотрите на размытое изображение и пытаетесь понять, это собака или кошка, размытие затрудняет задачу, но не отдаёт предпочтения ни одному из ответов. Если же вы смотрите на размытое изображение и пытаетесь решить, само ли оно размыто или вы просто плохо видите, каждый недостаток вашего зрения засчитывается как размытость на изображении. Если мы хотим изучать, как меняются в зависимости от масштаба, давления сжатия, силы и глубины, лучше начинать там, где мы можем видеть ясно.
Small image models may seem obsolete, but I think they matter a lot to this question because we can see them so clearly. They're also where much of the original worry came from: there we saw what looked like high-resolution chaos, not low-resolution ambiguity. Language models are massive, we don't have tools like feature visualization which make our life easier, attention mixes different kinds of mechanisms together, and many of their motifs are surprising. As I showed above, even vision motifs can be counter-intuitive, and language is worse. Each one of these deficiencies can make a monosemantic neuron look polysemantic. If you're looking at a blurry image trying to figure out if it's a dog or a cat, the blur makes it harder, but it doesn't favor either answer. If you're looking at a blurry image and trying to decide if the image itself is blurry or if you're just looking badly, every flaw in your eyesight gets counted as blur in the image. If we want to study how neurons change with scale, compression pressure, activation strength, and depth, it's better to start where we can see clearly.
Я обучил три модели , различающихся по размеру примерно в 300 раз: маленькую с 92 тыс. параметров, среднюю с 7,06 млн (такого же размера, как ) и большую с 28,6 млн. Мы рассмотрим их, а также , чтобы попытаться понять, что делают в разных ситуациях, и попытаться найти места, где может формироваться упаковка.
I trained three ConvNeXt models spanning roughly 300× in size: a small one with 92k parameters, a medium one with 7.06M (the same size as InceptionV1), and a large one with 28.6M. We’ll look at those, and also InceptionV1, to try to understand what neurons do in different situations, and try to find places packing may form.
Как я думаю о
Раньше я представлял как существительные в человеческом облике: один — это машина, другой — кривая. Теперь я думаю о них скорее как об элементе управления потоком. определяет не столько то, что он видит, сколько то, что он делает с входящим потоком, и часто его задача — управлять областью сети. Если смотреть на это так, вопрос почти некорректен. Более правильный вопрос заключается в том, что пропускает и что он отсекает.
I used to think of neurons as human-shaped nouns: one is a car, another is a curve. Now I think of them more as control flow. A neuron is less about what it sees than about what it does to the flow coming in, and often its job is to gate a region of the network. Seen this way, monosemanticity is almost the wrong question. A better one is what a neuron lets through and what it keeps out.
На вход поступают пиксели, и сеть начинает группировать и различать объекты. Автомобили и собаки могут оказаться в одной группе, так как они имеют схожую позу. Далее появляются специфические детекторы автомобилей — для такси, скорой помощи и тому подобного — и они не должны реагировать на собак. Поэтому , стоящий перед ними, действует как вентиль: он положительно реагирует на автомобили и отрицательно на собак, а его отрицательная сторона отсекает собак. Собаки переходят в свою собственную область, которой не нужно беспокоиться об автомобилях. Последующие развивают эту структуру, специализируясь ещё сильнее: скорой помощи может иметь такси на своём , а такси — скорую помощь. В более крупной модели эти различия могут становиться ещё тоньше, разделяя один вид такси на другой. Более мелкие модели могут останавливаться на более грубых различиях, формируя нечто, близкое к общему «автомобиль».
Pixels come in, and the network begins grouping and distinguishing things. Cars and dogs might be grouped together because they share a pose. Further along there are specific car detectors – for taxis, ambulances and the like – and they don’t want dogs. So a neuron in front of them acts as a gate: it responds positively to cars and negatively to dogs, and its negative side keeps the dogs out. The dogs go on to their own area, which doesn’t have to worry about cars. Later neurons build on this, specializing further: an ambulance neuron might have a taxi on its negative pole, and a taxi an ambulance. In a larger model, these distinctions can become finer still, separating one view of a taxi from another. Smaller models may stop at coarser distinctions, with something closer to a general “car” neuron.
Воспроизвести
В ранних слоях автомобили и собаки имеют общую позу. Вентиль перед детекторами автомобилей пропускает автомобили, а его отрицательная сторона отсеивает собак.
Вот настоящий спортивный автомобиль, прослеженный через последние пять блоков нашей большой модели. На полпути он группируется с другими прямоугольными формами, такими как столы и шкафы, в отличие от змей и собак. К последнему блоку разделение происходит между кабриолетами и универсалами.
Here’s a real sports car, followed through the last five blocks of our large model. Partway through, it’s grouped with other rectangular shapes, like tables and cabinets, against snakes and dogs. By the last block, the split is convertibles against station wagons.
Автомобиль
спортивный автомобиль
Блок 14 · 203
автомобили и лимузины
по сравнению с автобусами и трамваями
Блок 15 · 920
столы и шкафы
по сравнению со змеями и собаками
Блок 16 · 609
автомобили с откидным верхом, спортивные автомобили
по сравнению с микроавтобусами
Блок 17 · 1455
автомобили с откидным верхом
по сравнению с фургонами и универсалами
Блок 18 · 632
автомобили с откидным верхом
по сравнению с универсалами
Один выбранный спортивный автомобиль, прослеженный через последние пять из 18 блоков large. Каждый столбец показывает , который вносит наибольший вклад в следующий на этом изображении (последний — в выход спортивного автомобиля). Выше линии — с чем он группирует автомобиль; ниже — от чего он его отделяет.
Негативная сторона важна почти так же, как и позитивная, для их понимания, даже в сетях с , где негативная сторона отсечена. формируется на основе голосов: каждый входа голосует за его позитивную или негативную сторону, и голоса суммируются перед нелинейностью. Сама негативная сторона никогда не получает градиент, но отдельные голоса получают его всякий раз, когда активен, поэтому она тоже формируется в процессе обучения. Значение негативной стороны зависит от контекста: когда , находящийся на пути спортивного автомобиля, отделяет его от змей и собак, он не утверждает, что автомобили и собаки являются противоположностями, а просто отсекает вещи, которые были полезно сгруппированы ранее. Негативная сторона показывает, какое различие важно на данном этапе , что также служит быстрой проверкой того, является ли группировка реальной: негативная сторона V представляет собой букву O.
The negative side of neurons matters almost as much as positives for understanding them, even in ReLU networks where the negative side is cut off. A neuron is built from votes: each input weight votes for its positive side or its negative side, and the votes add up before the nonlinearity. The negative side never gets gradient on its own, but the individual votes do whenever the neuron is on, so it’s shaped by learning too. The negative side’s meaning depends on context: when a neuron in the sports car’s path separates it from snakes and dogs, it isn’t calling cars and dogs opposites, just gating out things that were usefully grouped earlier. The negative side tells us what distinction matters at this point in the circuit, which also makes it a quick check on whether a grouping is real: the V neuron’s negative side is an O.
Если посмотреть на последний слой, мы видим высокоуровневые паттерны и то, от чего они отличаются: такси от машин скорой помощи, брокколи от цветной капусты и ложкоротов от фламинго.
If we look at the last layer, we see high-level patterns and what they’re being distinguished from: taxis from ambulances, broccoli from cauliflower, and spoonbills from flamingos.
+Такси
−Скорая помощь
+Брокколи
−Цветная капуста
+Лопатоносы
−Фламинго
последнего слоя large: каждый положительно реагирует на один паттерн и отрицательно — на тесно связанный с ним.Дополнительные примеры
Когда мы смотрим на нашу самую маленькую модель, мы видим, что становятся грубее. В одном её последнего слоя оказываются машины, поезда и телеги, а на его отрицательной стороне — лодки, самолёты и водный воловий санный возок (о котором я даже не знал, что он существует). Модель всё ещё проводит различия, но более грубо, и делает это раньше.
When we look at our smallest model, we see the neurons get coarser. Its last layer ends at cars, trains, and carts in one neuron, with boats, planes, and a water-based ox-cart, (which I didn’t know even existed), on its negative side. It’s still differentiating, but more coarsely, and it ends early.
+
эвакуатор
трамвай
грузовик для переезда
пожарная машина
автомобиль для отдыха
легковой автомобиль
грузовик с прицепом
микроавтобус
−
спасательная шлюпка
пассажирский лайнер
дровни
военный самолет
последнего слоя маленькой модели: на его положительной стороне — наземные транспортные средства, на отрицательной — лодки и самолеты.
Что делают под давлением
Ранние слои в большинстве моделей компьютерного зрения . Насколько я понял, стандартное объяснение заключается в том, что не так много ранних зрительных , которые нужно представить. На первый взгляд немного странно, что каждая модель — от AlexNet до ResNets, от до CLIP — имеет верное соотношение ранних к ранним , хотя соотношения размера набора данных к размеру параметров у них сильно различаются.
Early layers in most vision models are monosemantic. As I understood it, the standard explanation is because there’s not that many early vision features that need to be represented. On its surface, it’s a bit strange that every model, from AlexNet, to ResNets, to InceptionV1, to CLIP all have the right ratio of early features to early neurons, since they have such different ratios of dataset to parameter size.
Один слой, на котором стоит сосредоточиться, — это 3b в . Это слой с кривыми и высоких и низких частот, которые, по моему мнению, являются одними из самых фундаментальных. В этой модели нет , поэтому невозможно «обтекать». Чтобы проверить, что происходит с при нехватке места, мы уменьшили их количество с 480 до 10 и переобучили модель.
One layer we can focus on is 3b of InceptionV1, the layer with Curve Neurons and High-Low Frequency neurons, which are among the most fundamental in my opinion. This model has no residual stream, so there’s no way to “flow around” the neurons. So we can test what happens to neurons when there’s not enough space by reducing the amount from 480 to 10 and retraining.
Если бы она переключилась в , мы должны были бы видеть перекрывающиеся смеси, например, кривая плюс оранжевая спираль плюс паутина и несколько других детекторов текстур. Мы уменьшили её масштаб в 48 раз, так что эффект должен быть заметным!
If it switched to superposition, we should see overlapping mixtures on top of each other, like a curve plus an orange spiral plus spider webs and several other texture detectors. We’ve crushed it 48x so it should be dramatic!
Но это не то, что мы видим. остаются интерпретируемыми и обобщёнными, но более грубыми: один «кривые и петли» вместо десяти , два «круги» вместо нескольких типов кругов и так далее.
But that’s not what we see. The neurons stay interpretable and generalized, but coarser: one “curves & loops” neuron instead of ten curve detectors, two circle neurons instead of several circle types, and so on.
Тёмные круги
Red
Жёлтый
Наклонные края
Вертикальные края
Глаза и лица
Кривые и петли
Круги
Высокая частота
Цветные метки
, переобученная с нуля: слой 3b, сокращённый с 480 до 10, без обходного пути. Каждый ряд — один и его пять самых сильных фрагментов из естественных изображений. Точность 58,35% и 81,14% на .Детали
Топ-1099–99.9%1–5%Нижние 10
Оптимизированное изображение и 10 изображений, вызвавших самые сильные отклики при просмотре 50 000 изображений. Выберите фрагмент, чтобы увидеть его и место в рейтинге.
Тёмные круги
Red
Жёлтый
Наклонные края
Вертикальные края
Глаза и лица
Кривые и петли
Круги
Высокая частота
Цветные метки
была обучена с нуля с уменьшением mixed3b с 480 до 10 пространственных каналов, без обхода вокруг слоя. Получившаяся модель достигла 58,35% и 81,14% точности на 50 000 отложенных изображениях .
Примеры ранжированы по максимальной на каждом из 50 000 обучающих изображений. В сетке показаны пять самых сильных примеров каждого ; каждый диапазон здесь содержит десять сохранённых примеров. Названия — предварительные описания по внешнему виду. Для визуализаций, направляемых по пути, использованы 60 самых сильных примеров.
Мы можем явно проверить кривые, чтобы понять, что с ними произошло. Если они были закодированы в некоторой высокоразмерной комбинации , мы должны иметь возможность их извлечь. Поэтому мы обучаем на этом сжатом слое и сравниваем результаты с оригиналами. Мы не видим ничего, похожего на чистые кривых!
We can test curves explicitly to see what happened to them. If they were placed in some high dimensional combination of neurons, we should be able to extract them. So we can train an SAE on this crushed layer and compare them to the originals. We don’t see anything like clean curve neurons!
Оригинальная 3b · 480
Десять
Переобучена с 3b при 10
сжатый слой
на сжатом слое
Наиболее близкий совпадающий для каждого детектора
предпочитает
Кривые и петли
расширить
, переобученная со сжатием слоя 3b до 10 , а затем обратно расширенная с помощью . На месте каждого исходного показан автоэнкодера, наиболее близкий к нему: широкий и сгруппированный вместе, а не десять отдельных кривых.Детали
Сжатая модель обучалась с нуля с сокращением mixed3b с 480 до 10 каналов и без обходного пути (bypass), достигнув 58,35% точности и 81,14% на 50 000 валидационных изображений . Автоэнкодер представляет собой с , имеющую 640 , из которых активны 2 на каждой позиции (рецепт из эссе плюс обычная вспомогательная функция потерь, предотвращающая «умирание» ), обученного на сжатом слое при 25,6 миллионах позиций из 200 000 обучающих изображений . Он объясняет 82% дисперсии на отложенных позициях, и при его внедрении точность на 10 000 валидационных изображений падает с 58,8% до 43,0%.
Каждый детектор и его ближайший
Детектор
Предпочитает
Ширина
Предпочитает
Ширина
Совпадение формы
Совпадение по фото
3b:385
16°
40°
79
38°
174°
0.52
0.09
3b:343
84°
40°
64
84°
64°
0.72
0.14
3b:342
116°
56°
510
86°
80°
0.61
0.19
3b:388
166°
40°
174
192°
44°
0.38
0.11
3b:324
184°
24°
174
192°
44°
0.79
0.26
3b:340
214°
42°
435
232°
146°
0.48
0.08
3b:330
244°
52°
89
232°
88°
0.52
0.11
3b:349
272°
34°
277
278°
64°
0.60
0.18
3b:379
328°
44°
544
32°
138°
0.56
0.18
3b:406
356°
26°
354
334°
94°
0.42
0.17
Настройка — это отклик в центре изображения на тонкую тёмную дугу, нарисованную под 180 углами и двумя кривизнами, как в приложении Missing Curves. Совпадение каждого детектора — это , среди тех, которые реагируют на нарисованные кривые наиболее сильно, чья кривая настройки лучше всего коррелирует с детектором (совпадение формы). Ширина — это диапазон углов, в котором отклик превышает половину пикового; кривые настройки в кольцах каждая масштабирована до своего собственного пика. Совпадение по фото — это корреляция по всем позициям 10 000 отложенных фотографий между и исходным детектором в том же месте.
Оригиналы имеют ширину 24–56° и неактивны под противоположным углом; совпадения имеют ширину 44–174° и продолжают реагировать под противоположным углом, а 3b:388 и 3b:324 разделяют один . Ни один из 91 , наиболее сильно реагирующих на нарисованные кривые, не является неактивным при противоположном угле. Удаление этого фильтра находит с более близкими, узкими формами (0,63–0,98), но они реагируют на нарисованные кривые только с 9–42% от их обычной сильной (оригиналы — 72–183%) и отслеживают детекторы на фотографиях ещё меньше (0,02–0,12). эссе для исходного слоя совпадает с теми же детекторами, имея корреляции формы 0,96–1,00. На сжатом слое даже лучший нелинейный считыватель десяти в одной позиции отслеживает каждый детектор с корреляцией всего 0,29–0,48. Другие автоэнкодеры рассказывают ту же историю (от 1 до 4 активных , 160 или 640 , второе начальное число или отсутствие вспомогательной функции потерь): медианное совпадение формы 0,47–0,63, совпадение по фото не более 0,27. При 3 или 4 активных предпочтительные углы выравниваются лучше, но кривые остаются широкими и двусторонними.
Контроль
Оптимизированные изображения используют рецепт, привязанный к пути из эссе (тот, что лежит в основе оригинальных изображений кривых), для сжатых , и рецепт (тот, что лежит в основе Missing Curves) для . пути масштабирован к диапазону каждой единицы, поскольку сжатого слоя в сотни раз меньше оригинальных. Тот же рецепт , применённый к эссе для исходного слоя, даёт чёткие кривые:
Изображения сжатых
Топ-1099–99.9%1–5%Нижние 10
Кривые и петли
Круги
Тёмные круги
Глаза и лица
Наклонные края
Вертикальные края
Высокая частота
Red
Жёлтый
Цветные метки
Названия «сжатых » — это временные визуальные описания. Фотографии ранжируют максимальные значения каждого по 50 000 обучающим изображениям.
Я считаю, что это хороший тест того, можем ли мы превратить знакомый мне моносемантический слой в суперпозированный. Но в некотором смысле это не идеально, поскольку в последних слоях подозревали в основном. Поэтому мы можем взять нашу модель среднего размера, «сжать» последний слой, запретить ей обходить и посмотреть, чему она научится. Мы видим ту же картину расширения.
I think this is a good test of whether we can turn a monosemantic layer I know well superposed. But in some ways it’s not ideal, since people mostly suspected superposition in the last layers. So we can take our medium size ConvNext, crush the last layer, stop it from routing around the residual stream, and see what it learns. We see the same pattern of it broadening.
Это также то, что мы наблюдаем на примере небольшой , которая в некотором роде представляет собой очень похожий тест.
ЖукиПриборные панелиЦифровые часыCarsКосмические шаттлыТелефонные будки и счётчикиЗнаки и дисплеиЖуки и транспортные средстваПомеранские шпицыШнауцеры и терьерыТранспорт и мелкие млекопитающиеDogsФасады и собаки
Средняя модель с финальным слоем, сокращённым с 1024 до 13 и обученная с нуля. Самые сильные положительные и отрицательные изображения для каждого .
Поздние
Мы также можем изучить в поздних слоях, чтобы исключить вероятность того, что последний слой каким-то образом особенный. Мы видим, что он организован на всём протяжении.
We can also look at circuits in the late layers, to rule out any chance that the last layer is somehow special. We see that it’s organized the whole way through.
Монастырь
Замки
Эвакуатор
Клубника
Рыба-клоун
Положительная Отрицательная
Пять , каждая из которых следует по выбранным связям к последнего слоя через пять блоков. Каждый демонстрирует оптимизированное изображение и четыре примера из набора данных.
Что выучивают словари
Если бы комбинации скрывали что-то, словарь (например, ) должен был бы найти строительные блоки, которых не хватает . Поэтому я обучил несколько на этих слоях и начал искать, сам и с агентами. Я ничего не нашёл.
If combinations of neurons were hiding things, a dictionary (eg an SAE) should find building blocks the neurons lack. So I trained several on these layers and went looking, myself and with agents. I didn’t find any.
В основном оба выглядели так, как они являются механистически: как строительные блоки, а единицы как эти блоки, сгруппированные по контексту. Это было наиболее ясно на примере пауков. Единицы представляли пауков в разных условиях; представляли узоры ног и паутины. Они не сильно расходились.
Mostly, the two looked like what they mechanistically are: the neurons like building blocks, the SAE units like those blocks grouped by context. It was clearest with spiders. The SAE units were spiders in different settings; the neurons were leg patterns and webs. They didn’t disagree much.
действительно помогли ответить на вопрос «что изображено на этом снимке?». Они помогли больше всего в самой маленькой модели, чьи грубые. На среднем размере я немного предпочёл их; на большом, думаю, я предпочитаю . Но меня больше интересует понимание сети, чем понимание любого конкретного изображения, и я никогда не видел, чтобы постигла что-то фундаментальное, чего не понимали . Если модель определённого размера не понимала бейсболистов, то её также не понимала. Когда модель наконец поняла бейсболиста, это произошло на уровне .
SAEs did help with “what’s in this image?” They helped most in the smallest model, whose neurons are coarse. At medium size I slightly preferred them; at large, I think I prefer the neurons. But I care more about understanding the network than about any one image, and I never saw the SAE grasp something fundamental the neurons didn’t. If a model at a particular size failed to understand baseball players, so did its SAE. When the model finally understood a baseball player, it was on a neuron.
Что именно обнаружила , что не имело уже четкого аналога в виде отдельного ? На последнем слое 88% ее активности приходится на почти точные копии отдельных , а остальное — слабо выражено: удаление всех направлений словаря, не совпадающих ни с одним , не меняет точность, а немногочисленные ответы, которые она меняет, уже были близки к ничьей. Кроме того, если искать повороты слоя, в котором несколько единиц несут наибольшую активность, начиная со случайного, то в каждом блоке мы возвращаемся к . Среди немногих , достаточно сильных для изучения, то, что добавила , — это слабые группировки, построенные из существующих , например, животные у поверхности воды или бледная, комковатая еда. Ничто из найденного там не выглядело как фундаментально новый строительный блок.
What did the SAE find that didn’t already have a clear neuron counterpart? On the last layer, 88% of its activity is near-copies of single neurons, and the rest is faint: removing every dictionary direction that matches no neuron leaves accuracy unchanged, and the few answers it flips were already near-ties. Additionally, if you search the rotations of a layer for the one where a handful of units carry the most activity, starting from a random one, you land back on the neurons, in every block. Among the few features strong enough to look at, what the SAE added was loose groupings built from existing neurons, like animals at the water’s surface or pale, lumpy food. Nothing we found there looked like a fundamentally new building block.
Что добавила Типичные
‹1 of 16›
Животные у поверхности воды 6717−
Построен из
733 0.19170 0.17920 0.17482 0.15…
Каждый добавленный показан вместе с существующими , из которых он построен, и долей каждого из них, которую он использует. «Типичные » показывает почти копии одиночных , из которых состоит большая часть .
Редкие объекты и
Значительная часть опасений по поводу скрытых связана с редкими явлениями. Они редко пересекаются с другими объектами, и может казаться, что они не заслуживают отдельного . Поэтому мы изучали редкие явления всеми доступными способами. Редкие классы часто оказываются более консолидированными: для требуется множество паттернов собак, но достаточно лишь одного для трицератопса. Когда я исключил на последнем этапе, ни один класс не выделялся. , которые мы проанализировали, использовали стандартные семантические маршруты .
A lot of the worry about hidden features comes from rare things. They seldom collide with anything, and they may not seem worth a neuron of their own. So we looked at rare things every way we could think of. Rare classes are often more consolidated: you need a lot of dog patterns for ImageNet, but only one Triceratops neuron. When I removed weak activations in the last stage, no class stood out. The adversarial examples we traced used normal semantic circuit routes.
Я посмотрел на изображения, чьи представления в последних слоях находятся дальше всего от любого другого изображения. Они оказываются забавными, странными изображениями, которые модель неправильно интерпретирует с помощью обычных : колибри, которую она принимает за мороженое, гигантский банан, который она принимает за хранилище, и человек в опрокинутой тачке, которого она принимает за газонокосилку. Я также обучил модель отображать случайный шум на случайные метки, и даже это было отчасти семантическим: она частично опиралась на текстуры шерсти и текстуру далёких деревьев, которые являются высокочастотными, немного напоминая высокочастотный шум. Я не проводил полной аудиторской проверки модели, но мне показалось интересным, что она вообще их использовала. Во всех экспериментах с языковыми и зрительными моделями стремится располагаться как можно ближе к выходу, поскольку всё, что ему нужно сделать, — это посмотреть ответ, и основную работу выполнили поздние слои.
I looked at the images whose representations in the last layers are furthest from any other image. They end up being entertaining, weird images that the model misreads with ordinary neurons: a hummingbird seen as ice cream, a giant banana seen as a vault, and a guy in a fallen wheelbarrow seen as a lawn mower. I also trained an ImageNet model to map random noise to random labels, and even that was partly semantic: it partially leaned on wool textures and the texture of distant trees, which are high-frequency, a bit like high frequency noise. I didn’t fully audit the model, but thought it was interesting that it used them at all. Across all experiments in language and vision, memorization tends to want to sit as close to the output as possible, since all it has to do is look the answer up, and the late layers did most of the work.
Необычные изображения, обычное устройство. Сверху: измеренные карты отклика. Снизу: естественные примеры, демонстрирующие наиболее поддерживающий последнего слоя для каждого изображения, измеренный с помощью .
Мы также можем создать редкий маршрут самостоятельно, обучив нашу модель на 7,06 млн параметров чему-то бессмысленному: что фотография зонта — это пчела. Можно представить, что это не опирается ни на что другое: скрытый , который цепляется за этот точный набор пикселей и говорит «пчела», отрезанный от остальной части сети, потому что она в нём не нуждается. Это было бы довольно плохой новостью, но происходит совсем не это. За девять шагов обучения лучший предсказанный класс сменился с «зонт» на «майский шест», а затем на «пчела». , реагирующие на зонт, погасли, а существующие , реагирующие на пчел, сработали; почти всё это произошло в последних трёх блоках: замените только их в исходной модели, и она будет говорить «пчела».
We can also make a rare route ourselves, by teaching our 7.06M-parameter model something nonsensical: that a photo of an umbrella is a bee. You could imagine this memorization not relying on anything else: a hidden feature that latches onto this exact set of pixels and says “bee,” cut off from the rest of the network because it doesn’t need it. That would be pretty bad news, but it’s not at all what happens. In nine training steps, the top guess went from umbrella to maypole to bee. The umbrella neurons faded and existing bee neurons came on, nearly all of it in the last three blocks: swap just those into the original model, and it says “bee.”
Зонт переключается на маршрут пчелы
эта фотография, исходная модельпосле обучения «пчеле»каждая на естественных изображениях
Столбцы показывают отклик каждого на эту фотографию до и после того, как модель научилась относить её к классу «пчела». Засечка показывает отклик на типичный зонт или пчелу. Изображения показывают, на что реагировали изначально; линии обозначают связи, проверенные аблиацией.
Это альтернатива обучению некоему скрытому зонта, отдельному от любых обычных путей распознавания зонта или пчелы. Хотя такой вариант возможен, на мой взгляд, на его освоение уйдёт больше времени, чем собрать связанные компоненты, которые уже активируются и имеют пути к выходу. Эти пути обеспечивают пластичность и градиент. Отдельный скрытый к тому же был бы более хрупким. Мы нигде не наблюдаем такой структуры.
This is in comparison to learning some sort of hidden umbrella feature separate from any other normal umbrella or bee route. While this is possible, I think it’s slower to learn than assembling related parts that are already activating and have routes to the output, giving it plasticity and gradient. It’s also more fragile, and isn’t what we see anywhere.
Случайный
Что происходит
Воспроизвести
Один из способов запомнить бессмысленную метку — создать , не связанный ни с чем. То, что мы видим вместо этого, — это ответвление между двумя маршрутами, которые сеть уже использует.
Важны ли ?
Когда люди спрашивают, имеют ли значение , я думаю, что здесь смешано несколько вопросов, и на каждый из них есть свой ответ.
When people ask whether weak activations matter, I think there are several questions mixed together, and they have different answers.
Это или ?
Неудивительно, что я считаю это . Представьте, что вы — плотно упакованный, несвязанный , пытающийся избежать столкновения с тем, что находится в основном . значительно плотнее, поэтому вы бы сталкивались с порядками величин большим количеством вещей, получая при этом мало выгоды.
Unsurprisingly, I think it’s generalization. Imagine you’re a packed, unrelated feature trying not to collide with what’s in a main neuron. Weak activations are vastly denser, so you’d be colliding with orders of magnitude more things, for little upside.
100 миллионов через один . Почти все значения близки к нулю; около 160 достигают верхней половины диапазона.Текст и подписи схемы по-русски
верхняя половина
0
половина от максимума
макс
100 миллионов через один . Почти все значения близки к нулю; около 160 достигают верхней половины диапазона.
Но, возможно, вы прячетесь в многих одновременно. Мы видим, что можно отключить почти все сети практически без потерь. Места, где их удаление обходится дороже всего, являются одними из самых простых для понимания. В языковых моделях это последний слой, который в основном используется для подавления отдельных в рамках того, что мы называем мотивом «сказать или просто подумать». В моделях зрения это ранние слои, которые работают как ручки настройки: разница между слегка ярким и средне ярким имеет значение, но для более позднего детектора, например, королевского пингвина, низкое или очень низкое доказательство не важно. Таким образом, критически важные общие не могут находиться в , поскольку мы можем их удалить.
But maybe you hide in the weak activations of many neurons at once. What we see is that you can ablate almost all the weak activations of the network for almost no cost. The places where removing them costs the most are some of the easiest to understand. In language models, they include the last layer, which is largely used to suppress single tokens, for what we call a “say or just think” motif. In vision models, it’s the early layers, which function like dials: the difference between slightly bright and medium bright matters, but for a later detector, like king penguin, low or very low evidence doesn’t. So critical common things can’t be in the weak activations, since we can remove them.
Мы также можем посмотреть, что мы теряем, отбрасывая . В рамках нескольких видов исследований это обычно тонкие различия между объектами, в которых сеть уже запуталась. И , которые их вызывают, исходят от семантически связанных , каких вы и ожидали бы.
We can also look at what we lose when we cut weak activations. Across several kinds of studies, it’s usually fine distinctions between things the neural network is already confused about. And the faint activations that tip them come from the semantically related neurons you’d expect.
Удаление самых слабых 75%
точность 72%→ to71% · 1 in 10 ответы меняются
Удаление самых сильных 7%
точность 72%→ to4% · 96 in 100 ответы меняются
Та же общая , что и у самых слабых 75%
Близкие результаты
Уверенные ответы
Слабейшие 75% удаленыУдалены самые сильные 7%Слабейшие 75% удаленыУдалены самые сильные 7%
Эскимосская собака (54% от его двух лучших)weak removed: становится Сибирский хаскиstrong removed: становится бархат
сверчок (56% от его двух лучших)weak removed: становится виттstrong removed: становится комарная сетка
опоссум. (57% от его двух лучших)weak removed: становится Салюкиstrong removed: становится гейзер
тигровый кот (62% от его двух лучших ответов)weak removed: становится полосатыйstrong removed: становится гейзер
мусоровоз (100% от его двух лучших ответов)слабо удалено: samestrong removed: становится лопата
колибри (100% от его двух лучших ответов)слабо удалено: samestrong removed: становится Гренни Смит
бурый медведь (100% от его двух лучших ответов)слабо удалено: samestrong removed: становится фонтан
зебра (100% от его двух лучших ответов)слабо удалено: samestrong removed: становится у озера
Medium , все 18 блоков. Каждая полоска показывает распределение двух лучших ответов модели до удаления каких-либо .
Это оставляет редкие данные и сильные, но не экстремально сильные .
Как мы видели ранее, редкие явления возникали на связанных в каждом из проведённых нами экспериментов, поскольку они слишком слабы, чтобы сформировать собственные ниши. Приведённая выше указывает в том же направлении: если бы редкие случаи хранились в , их удаление должно было бы полностью сломать некоторые ответы. Вместо этого каждое изменение было незначительным, и результат почти ничем не отличался, склоняясь то в одну, то в другую сторону.
Rare things, as we saw earlier, have grown on related circuits in every experiment we’ve run, since they aren’t strong enough to form niches of their own. The ablation above points the same way: if rare cases lived in the weak activations, cutting them should have broken some answers outright. Instead, every change was small, a near-tie tipping one way or the other.
На сильные, но не экстремальные можно просто посмотреть. Во всех известных мне случаях по мере ослабления они семантически расходятся от исходной темы. Например, у нейрона Трампа в CLIPMultimodal in Artificial Neural Networks Гоу, Г., Камарата, Н., Восс, К., и др., 2021. Distill. Ссылки ↓ это сначала фотографии Трампа, затем произведения искусства и связанные с ним люди, затем студии Fox News. Чем дальше мы спускаемся по этому ряду, тем легче принять связанную вещь за несвязанную. Как минимум стоит посмотреть на , через которые прошёл пример: то, что слабо сработало здесь, могло сильно сработать слоем раньше.
And the strong-but-not-extreme activations we can just look at. In every case I know of, they radiate outward semantically: for CLIP’s Trump neuron [3] Multimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. References ↓ , photos of Trump, then art and people related to him, then Fox News studios. The further down you go, the easier it is to be fooled by something that seems unrelated but isn’t. At minimum, look at the circuits a datapoint flowed through; what fired weakly here may have fired strongly one layer back.
Вот все сильные срабатывания пяти в языковой модели. В центре показан максимум каждого : по мере удаления от центра связи становятся более отдалёнными. Серым цветом выделены области, которые трудно однозначно интерпретировать. Обычно они всё ещё связаны, но требуют дополнительных усилий для понимания, так как связь более отдалённая. Можно нажать на любой , чтобы раскрыть его и увидеть, из каких пришла каждая .
Here's every strong firing of five neurons in a language model. The center is each neuron's maximum, as it radiates out it becomes more distantly related. Gray is where it's hard to place, usually these are still connected but require more work to understand, since it's more distant. You can click any to open them up and see which circuits each activation came from.
Каждое сильное срабатывание пяти . В центре — максимум каждого , кольца показывают доли от этого максимума, а цвет указывает, о чём идёт речь при срабатывании. Серый цвет обозначает базовый уровень. Нажмите на один из , чтобы исследовать его.Текст и подписи схемы по-русски
Пять в
Titanic
Открыть карту
Titanic и катастрофы лайнеров
Корабли, море, морские происшествия
История 1800-х – 1910-х годов
Нет обрыва до 99,9-го процентиля
Baroque
Открыть карту
Сам по себе стиль барокко
Другие художественные стили, направления
Названия исторических эпох
Нет обрыва до 99,9-го процентиля
Christmas
Открыть карту
Рождество и его символы
Праздничный сезон, зима и подарки
Праздничная еда и выпечка
Обрыв около 5% от максимума
Rainbow
Открыть карту
Цвета радуги
Другие фиксированные наборы
Другие цвета и цветовые системы
Нет обрыва до 99,9-го процентиля
Colorado
Открыть карту
Места и учреждения Колорадо
Другие горные земли, не имеющие выхода к морю
Запад США и Канады
Нет обрыва до 99,9-го процентиля
Каждое сильное срабатывание пяти . В центре — максимум каждого , кольца показывают доли от этого максимума, а цвет указывает, о чём идёт речь при срабатывании. Серый цвет обозначает базовый уровень. Нажмите на один из , чтобы исследовать его.
Раньше я мыслил в процентных долях, поскольку это удобно и позволяет стандартизировать показатели для разных . Но я пришёл к выводу, что исходная форма несёт важную информацию. Некоторые сохраняют своё значение на всём протяжении диапазона; другие резко падают, как рождественский выше, примерно на 5% от своего максимума. Одни срабатывают несколько раз за книгу, другие — несколько раз за страницу. Процентные доли сглаживают эти различия, и именно они часто подсказывают, имеем ли мы дело с регулятором, где важна середина, или с детектором, где это в основном не важно.
I used to think in percentiles, since they’re easy to think in and standardize across neurons. But I’ve come to think a neuron’s raw shape is telling us something. Some neurons hold their meaning far down the range; others drop off a cliff, like the Christmas neuron above at about 5% of its max. Some fire a few times a book, others a few times a page. Percentiles flatten that, and it’s often what tells you whether you’re looking at a dial, where the middle matters, or a detector, where it mostly doesn’t.
Процентили также искажают интуицию. 99-й процентил звучит высоко, но 1 из 100 — это примерно четверть страницы, и для нишевого чувства или социального контекста — которые повсеместно встречаются в языковых моделях — не должен появляться четыре раза на странице. Мышление в страницах помогает: 99,9-й процентил — это каждые две или три страницы, 99,99-й — каждые 25 или 30.
Percentiles also mess with intuition. The 99th percentile sounds high, but 1 token in 100 is about a quarter of a page, and a neuron for a niche feeling or social context – which are all over language models – shouldn’t come up four times a page. Thinking in pages helps: the 99.9th percentile is every two or three pages, the 99.99th every 25 or 30.
Нужны ли они для маркировки ?
Обычно нет. После ручного просмотра тысяч языковых моделей трудно переоценить способность проводить аналогии. Если речь идёт о путешествии на судне, модель может счесть его немного похожим на историю «Титаника». Обычно, на мой взгляд, не слишком полезно представлять « морского путешествия», распределённый по «Титаника» и других . Вместо этого есть механизм, распознающий сходство с «Титаником»: когда такое сходство возникает, он срабатывает, а его служат голосами в пользу вещей, напоминающих «Титаник». Вы смотрите на самые сильные , видите это сходство, и такое описание обычно подтверждается при остальных проверках. Если вам действительно важна конкретная , можно проследить связанные с ней пути, провести и продолжать приближение практически до любой детализации.
Usually not. After looking at thousands of language model attribution graphs by hand, it’s hard to overstate how much neurons are analogizers. If you’re talking about voyaging on a boat, the model might judge that a bit Titanic-ish. I don’t think it’s usually helpful to think of a “naval voyage feature” spread across the weak activations of the Titanic neuron and others. Instead, there’s a Titanic-ish mechanism: whenever something is Titanic-ish, it fires, and its weights are votes for Titanic-ish things. So you look at the top activations, see that it’s Titanic-ish, and that label usually holds up through the rest of your audits. If you ever really care about a particular activation, you can follow its pathways, ablate the circuits, and keep zooming in to almost arbitrary resolution.
Мой главный вывод: если кажется не связанной, не стоит слишком беспокоиться, если вы не изучили её тщательно. Из, вероятно, сотен, которые я проследил вручную, почти все оказались связанными, проходя через разумную ; это просто не было визуально очевидно, пока я не проследил её.
My main takeaway: if a weak activation looks unrelated, don’t be too worried unless you’ve looked at it carefully. Of the probably hundreds I’ve followed by hand, almost all turned out to be related, coming through a reasonable circuit; it just wasn’t visually obvious until I traced it.
Многие связи были хитроумными. Например, дзенских коанов слабо срабатывал на рекурсию в математике: многие коаны строятся на похожей самоотсылке, на поиске наблюдателя. Другие связи были более далёкими и неуклюжими, не всегда такими, какие провёл бы я. Но обычно можно было проследить, как они возникли. Я подозреваю, что большинство, возможно почти все, устроены именно так.
Many were clever, like a Zen koan neuron that fires weakly on recursion in math: many koans turn on the same kind of self-reference, looking for the observer. Others were more distant and ugly, not always the connection I would have drawn, but you could usually follow how it got there. I suspect most, possibly almost all, are like this.
Исследование языковых моделей
Этот раздел подготовлен совместно с Кёртом Тиггесом. В нём использованы эксперименты из нашей готовящейся технической статьи, в которой подробно исследуются языковых моделей. Поэтому здесь я буду говорить «мы».
This section was done with Curt Tigges, and brings in experiments from our forthcoming technical paper studying language neurons in depth, so I’ll use we for this section.
Языковые модели настолько велики, что точно проверить утверждения о механизмах сложно, но мы можем проверить, работает ли там и простая история. Мы начинаем с медицинской диагностики, который нам понравился в работе Anthropic’s Биология схемOn the Biology of a Large Language Model Lindsey, J., Gurnee, W., Ameisen, E., et al., 2025. Transformer Thread. Ссылки ↓. Они изучали Claude 3.5 Haiku, используя Crosslayer . Оказалось, то же самое работает и с в .
Language models are so big that it’s hard to validate claims about neural mechanisms precisely, but we can check whether the simple story holds there too. We start with a medical diagnostic attribution graph we liked from Anthropic’s Circuit Biology [15] On the Biology of a Large Language Model Lindsey, J., Gurnee, W., Ameisen, E., et al., 2025. Transformer Circuits Thread. References ↓ . They were studying Claude 3.5 Haiku using Crosslayer Transcoder features. It turns out the same works with neurons in Qwen3-32B.
Поскольку это оригинальная модель, здесь отсутствует функция , и для получения результатов не требуется дополнительное обучение. Их самый большой предсказывает то же следующее слово, что и оригинал только в половине случаев Tracing: Revealing Computational Graphs in Language Models Амейсен, Э., Линдси, Дж., Пирс, А. и др., 2025. Transformer Thread. Ссылки ↓, а их графы нуждаются в узлах ошибок для того, что они упускают.
Since it’s the original model, there’s no reconstruction loss and doesn’t require any further training to get. Their largest transcoder predicts the same next word as the original only half the time [14] Circuit Tracing: Revealing Computational Graphs in Language Models Ameisen, E., Lindsey, J., Pearce, A., et al., 2025. Transformer Circuits Thread. References ↓ and their graphs need error nodes for what it misses.
Диагностический хаб состоит всего из четырёх , и если их удалить, модель начинает спрашивать о зуде. Зуд является характерным другого состояния печени при беременности, как будто модель перешла к своей следующей догадке.
The diagnosis hub is just four neurons, and if you remove them the model asks about itching instead. Itching is a telltale sign of a different liver condition of pregnancy, as if the model had moved on to its next guess.
Мы также добавили несколько других , которые нам понравились. Есть ещё несколько графов, если вы хотите их увидеть. Среди тысяч, которые я видел в моделях компьютерного зрения и языковых моделях, они легко читаемы и при аблиации ведут себя так, как вы обычно ожидаете.
We’ve also added a few other attribution graphs we liked. There’s a few other graphs if you’d like to see them. Across thousands I’ve seen in image models and language models, they’re highly readable and ablate the way you’d generally expect.
Одна и та же схема: и
Наведите курсор на группу Qwen, чтобы увидеть её · нажмите, чтобы удалить · нажмите на ссылку для Нажмите на группу Qwen, чтобы увидеть её , или на ссылку для
Anthropic · Claude 3.5 Haiku ·
Ours · ·
Qwen asks about нарушения зрения, как у Claude. P(visual) 0.90 · P(protein) 0.058
Отслеживание между двумя группами
Кто украл книгу? Заклятый враг короля львов
Наведите курсор на группу, чтобы увидеть её · нажмите на ссылку для просмотра Нажмите на группу, чтобы увидеть её , или на ссылку для просмотра
Никакие указания не указывают на Анну; сопротивление исходит от , которые активируются непосредственно перед «not», и уверенный пользователь перевешивает их.
Подробнее
Мы добавили еще несколько, если вам любопытно посмотреть разные .
в обоихчастичное совпадениетолько с этой стороныне найдено
Слева: Рисунок 30 из статьи Anthropic On the Biology of a Large Language Model, в перерисованном виде. В исходном рисунке не указаны, поэтому все связи показаны линиями одинаковой ширины. Справа: собственные - , сгруппированные Claude. Числа обозначают количество в группе, а ширина связи показывает, насколько сильно каждая группа влияет на следующую. Пять небольших групп, встречающихся только у Qwen, не показаны. Большая часть несгруппированных связей приходится на форматирования ответа в поздних слоях. В контрольном условии «Random» удаляется такое же число из тех же слоёв.
Без шага, связанного с «Королём Львом» (18 ), Qwen отвечает Симба, а не случайным злодеем. P(Scar) 0,24, случайное 0,91
группы , с указанием их количествасмещает ответ в нужную сторонуpushes against it
Отслежены и сгруппированы так же, как на первом графике. «Random» удаляет как можно больше из одних и тех же слоёв.
Без этих 8 с , Qwen обвиняет семейного питомца. P(Santa) 0,059, случайное 0,997
группы , с указанием их количествасмещает ответ в нужную сторонуpushes against it
: сильно активируется в отрицательную сторону, и его самые отрицательные примеры из набора данных связаны с Сантой.
Без 19 , формирующих оговорки о неуверенности, Qwen утверждает: Маркус, планировщик. P(hedge) 0,23, случайное 0,76
группы , с указанием их количествасмещает ответ в нужную сторонуpushes against it
"Hedge" соответствует P(most) + P(likely) для следующего слова; другой вариант, "**", открывает выделенное жирным имя.
Без 25 «говорить нет», Qwen перестаёт сопротивляться и называет Anna. P(Anna) 0,92, случайное 0,66
группы , с указанием их количествасмещает ответ в нужную сторонуpushes against it
Слова «абсолютно уверен» не несут почти никакого собственного ; они меняют то, насколько сильно проявляется «Анна» пользователя.
Негативная сторона важна примерно так же, как и позитивная. Мы полагаем, что интерфейсы склонны уделять слишком много позитивному полюсу и его . Мы считаем, что обычно не важны, но сильные положительные и отрицательные имеют большое значение.
The neuron’s negative side matters about as much as its positive. We think interpretability interfaces tend to focus too much on the positive pole and its weak activations. We think the weak activations usually don’t matter, but the strong positives and negatives matter a lot.
Например, Санта живёт на .
На графе про Санту стандартная автоматическая интерпретация по может давать метки вроде «столицы»: она игнорирует , связанный с культурными представлениями о Санта-Клаусе. Если удалить восемь , у которых Санте соответствует , вероятность прежде почти достоверного ответа «Санта» падает до 6%, и Qwen обвиняет домашнего питомца. Если же удалить двадцать , которые действительно получили метки «Рождество» или «Санта», вероятность падает лишь до 76%.
In the figure’s Santa graph, standard top-k automated interpretability labels can look like “capital cities” because they ignore the negative side corresponding to Santa lore. Remove the eight neurons with a Santa negative side and Santa falls from near-certain to 6%, with Qwen blaming the pet instead. Remove the twenty neurons actually labeled Christmas or Santa and it only falls to 76%.
Вот от , построенный только на . Насколько нам известно, это первый опубликованный для модели с многотриллионным числом параметров. Когда его спросили, что делать с найденным кошельком, он связал сам кошелек, наличные и удостоверение личности владельца с категориями «потерянные вещи» и «честность», после чего выдал ответ «вернуть». Мы ещё не приступали к полномасштабным аудитам такого уровня, но надеемся сделать это в ближайшее время. Пока же большинство результатов интуитивно понятно.
Here’s an attribution graph from Kimi K3 using only neurons. As far as we know, it’s the first published attribution graph of a multiple trillion parameter model. Asked what to do with a wallet it found, it links the wallet, the cash and the owner’s ID to lost property and honesty, and answers “return”. We haven’t begun full audits of this scale yet, and hope to soon, but so far most things have been intuitively interpretable.
Найденный кошелёк в модели с триллионом параметров
Наведите на группу, чтобы увидеть её Нажмите на группу, чтобы увидеть её
Факты вопроса активируют , отвечающие за утерянные вещи и честность, а затем за возврат, что толкает сеть к ответу «вернуть». Однако наибольшее сопротивление оказывает группа , которые пытаются это предотвратить.
Ours · Kimi-K3 ·
Факты вопроса активируют , отвечающие за утерянные вещи и честность, а затем за возврат, что толкает сеть к ответу «вернуть». Однако наибольшее сопротивление оказывает группа , которые пытаются это предотвратить.
Подробнее
Без одного из , «сдерживающих» , Kimi-K3 ещё более уверен в вернуть. Ни один другой изученный нами не изменяет его даже наполовину так сильно. P(return) 0.83 → 0.98, случайное 0.83
группы , с указанием их количествасмещает ответ в нужную сторонуpushes against it
Собственные - Kimi-K3, прослеженные от их следующего слова и сгруппированные агентом на основе описания каждого ; числа показывают количество в группе, а ширина связей демонстрирует, насколько сильно каждая группа влияет на следующую. Эти двенадцать групп — вручную отобранная часть графа: большая часть его приходится на поздние в ответе, которые не изображены.
Мы могли бы интуитивно ожидать упаковки с такими вещами, как или имена, просто потому, что их так много. Но на деле мы обнаруживаем обычное и . Ранние языковые фрагменты, такие как «iy» в «Miyazaki», подобны тому, как ранние модели зрения используют .
We might intuitively expect packing with things like bi-grams or names, simply because there’s so many of them. What we find is that it’s ordinary generalization and composition. Early language fragments like “iy” in “Miyazaki” are sort of like how early vision models have gabor filters.
В приложении мы разбираем статью Neurons in a HaystackFinding in a Haystack: Case Studies with Sparse Probing Gurnee, W., Nanda, N., Pauly, M., Harvey, K., Troitskii, D. and Bertsimas, D., 2023. arXiv:2305.01610. Ссылки ↓. Её авторы предположили, что обнаружили в направлении «социального обеспечения», однако сеть это направление не использует. Мы показываем направление, которое сеть использует на самом деле, и выясняем, что она применяет обычное и .
In the appendix we address Neurons in a Haystack [9] Finding Neurons in a Haystack: Case Studies with Sparse Probing Gurnee, W., Nanda, N., Pauly, M., Harvey, K., Troitskii, D. and Bertsimas, D., 2023. arXiv:2305.01610. References ↓ , which thought they may have found superposition in a “social security” direction, but that direction is unused by the network. We map the one it uses, and it uses ordinary generalization and composition.
От фрагментов написания к «Миядзаки»
1 / 6
L0–L1 Фрагменты
L1:15229+4.42Финальное i после k / g / qL0:13886+3.32ak-clusterL0:4289+2.06окончания ki-L1:20486+1.88iy-
L2–L3 Паттерны
L3:12478+6.71trans|act → z|akiобщее продолжениеL2:8891+2.09Продолжение на ромадзивнутрислововой паттернL3:15141+3.15окончания −saki / 崎Кавасаки также изобрёл Mawasaki
L4 Распознавание имён
L4:8476МиядзакиМиядзакиaki сосредоточен на Дзиро…宫崎骏Миядзакиaki Префектура
Общие элементы орфографии питают один Миядзаки, который срабатывает на имя во всех шрифтах и смыслах, которые мы пробовали, и питает более поздние ассоциации, такие как «Унесённые призраками».
Мы видим, что примерно 90% выполняют по сути одну задачу, а ответвления обычно связаны с ней. Когда мы оценивали значимость этих ответвлений, наиболее важные из них оказались наиболее связанными. Например, геологии срабатывает на Цезий и на библиотеку JavaScript для геологии. У многих из оставшихся есть две или три такие задачи. Я никогда не видел , выполняющий что-то вроде десяти несвязанных вещей. В другой статье содержится гораздо больше деталей.
What we see is about 90% of neurons having basically one job, with recursive generalization offshoots that are usually related. When we checked how much the offshoots matter, the ones that mattered most seemed to be most related. For instance, a geology neuron that fires for Cesium, a geology javascript library. A lot of the remaining ones have two or three. I’ve never seen a neuron with something like ten unrelated things it does. There’s a lot more detail in the other paper.
Побочные не кажутся особенно важными скрытыми . Один из страхов заключается в том, что они чем-то похожи на спящих агентов: крайне важны в собственном контексте, но встречаются редко. Что мы обычно находим, так это то, что они встречаются реже и менее важны в своём собственном контексте, чем основная в своём.
The offshoots don’t seem to be particularly important hidden features. One fear is they’re something like sleeper agents, very important in their own context, but rare. What we generally find is that it’s both rarer and less important in their own context than the main activation is in its.
Одним из главных источников шума был . У современных есть управляющая и . Когда обе дают отрицательные значения, попадают на , но обычно выглядят как . Обычно это «эхо» невелико, однако примерно у 4% оно занимает всю верхнюю часть списка. При их по всей сети результаты на большинстве бенчмарков улучшаются, но на некоторых задачах рассуждения ухудшаются. Мы думаем, что объяснение, скорее всего, простое: какой-то использует одну из таких , чтобы рассуждать дольше. Но глубоко мы это не исследовали. На наш взгляд, разработчикам архитектур стоит поискать способ это исправить.
A big source of noise was the double negative SwiGLU. Modern neurons have both a gate and value. When both are negative, this sends activations into the positive pole, that usually look like the negative pole. Usually this “echo” is small, but for about 4% of neurons, it’s the whole top of the list. Ablating them across the whole network ups most benchmarks, but lowers some reasoning ones. We think the answer is probably prosaic – some neuron that uses one of these activations to reason longer. But we haven’t looked into it deeply. Architecture designers, we think you should look into fixing this!
Верх списка
Его самые сильные положительные , так как их показывает панель
+0.99…3. The book of Colossians is an epistle…
+0.98…(e.g. 1 Chronicles 16:9, Colossians 3:1…
+0.98…(Romans 5:10, 11:28; Colossians 1:2…
+0.98…(Matthew 28:18; Colossians 1:1…
+0.98…meekness, and patience” (see Colossians 3:1…
Метка : Ссылки на послание к Колоссянам
Сгруппировано по
У каждого из них затвор закрыт, поэтому происходит небольшая утечка значения с инвертированным знаком, составляющая менее 8% от пикового значения .
+0.99Colossians is an epistleзатвор закрыт
+0.98Colossians 3:1затвор закрыт
+0.98Colossians 1:2затвор закрыт
+0.98Colossians 1:1затвор закрыт
+0.98Colossians3:1 · вентиль закрыт
gate
значение
выход
Колосс|ians
−1.2
−3.5
+1.0
Говори русский
+4.4
−2.9
−12.5
Одно и то же значение, противоположный затвор
После отделения утечки
Только те срабатывания, при которых затвор открыт
Положительная сторона: ничего выше +0,5, около 4% от пика
−20.6www.un.org/russianзатвор открыт
−19.0```kotlin package ruзатвор открыт
−12.5Speak russian in that case
gate open−8.6…российскогозатвор открыт
Задача : , завершающий «Россия» или «русский», на любом языке
L1/N20736 модели
Рассматривая в моделях зрения, где мы понимаем процессы лучше, значение обычно учит более общие , а вентиль — более специфические. Например, значение учит широкий класс, такой как маленькие серые птицы или всё оранжевое, а вентиль открывается только для джунко или золотых рыбок.
Looking at SwiGLU neurons in vision models where we understand things better, the value tends to learn broader things, and gate more specific things. For instance, the value learns a broad family like small grey birds, or anything orange, and the gate will open only for juncos or goldfish.
Эксперты гораздо более специализированы, чем сообщалось ранее. Поскольку было трудно оценить , было трудно оценить специализацию экспертов; такие показатели, как «сходство », не являются хорошей мерой.
Experts are far more specialized than previously reported. Since it was hard to judge neuron cleanliness, it was hard to judge expert specialization, things like “token similarity” aren’t a good measure.
Как и , они сужаются с глубиной. Когда они не «», они, кажется, охватывают широко связанные понятия. Мы не изучали процесс обучения, но полагаем, что это, вероятно, тот же паттерн , что и при увеличении масштаба. В целом, мы начали рассматривать сеть как тот же самый организующий принцип, но на нескольких уровнях: от , , экспертов и . Каждый уровень имеет свои собственные задачи, такие как детали нелинейности, но между ними много общего.
Like neurons, they get narrower with depth. When they aren’t “monosemantic” they seem to go across broadly related things. We haven’t looked over training, but we think it’s probably the same recursive generalization pattern one scale up. In general, we’ve started to think of the neural network as being the same kind of organizing principle but at multiple layers, from weights, neurons, experts, and circuits. Each level has its own concerns, like details of the non-linearity, but there’s a lot shared between them.
Интересно также рассматривать экспертов как архитектуру, противостоящую . стремится упаковывать несвязанные понятия вместе, но высоко специализированные эксперты затрудняют это, поскольку срабатывает только тогда, когда выбран его эксперт. Эксперт, ориентированный на упаковку, не хотел бы быть полностью посвящённым боссам в настольных RPG (один из них); он предпочёл бы упаковать вместе десять тысяч несвязанных понятий. Но тогда должен был бы распознавать все эти десять тысяч, чтобы знать, когда отправлять туда , а — это всего лишь один небольшой линейный слой.
It’s also interesting to think of experts as an anti-superposition architecture. Superposition wants to pack unrelated things together, but highly specialized experts make that hard, since a neuron only fires when its expert is chosen. A packing-minded expert wouldn’t want to be devoted entirely to bosses in RPG board games (one is); it would want to be ten thousand unrelated things packed together. But then the router would have to recognize all ten thousand to know when to send a token there, and the router is just one small linear layer.
Все 10 240 экспертов в Qwen3.6. Каждый ряд — это слой, отсортированный от самых узких экспертов к самым широким, согласно оценке агентов, читающих сводки каждого эксперта. Наведите курсор на один, чтобы увидеть его тему.Текст и подписи схемы по-русски
Узкая тема
Широкая
Неродственные ниши
Напоминает случайную выборку
Наведите курсор или нажмите на эксперта
Все 10 240 экспертов в Qwen3.6. Каждый ряд — это слой, отсортированный от самых узких экспертов к самым широким, согласно оценке агентов, читающих сводки каждого эксперта. Наведите курсор на один, чтобы увидеть его тему.
Существует риск определять объяснения слишком широко, как «многофункциональный языковой ». В технической статье описано несколько способов проверки этого, а в приложении приведён один из них: объяснения сталкиваются с «почти промахами», специально написанными, чтобы обмануть их. Один из найденных нами особенно полезных методов — . Один агент исследует и пишет краткое объяснение; второй видит только это объяснение и генерирует пример, предназначенный для максимальной . Результатом обычно становится простое, понятное предложение, которое может активировать сильнее, чем любой пример, найденный нами в 10 миллиардах .
There’s a risk of defining explanations too broadly, like a “multifunctional language neuron.” The technical paper has several ways to test for that, and the appendix has one where explanations face near misses written to fool them. One we found particularly useful is blind maximum. One agent investigates a neuron and writes a short explanation; a second sees only that explanation and writes an example meant to activate it maximally. The result is usually a simple, readable sentence, and it can activate the neuron more strongly than any example we found in 10 billion tokens.
Соблазнительно думать об как о простом числе, а о — как о способе увеличить его. Мне кажется более точным представлять как цель, от центра которой во всех направлениях расходится смысл. Всё, что поступает в него, вносит своё собственное мелкое семантическое суждение, а максимум — это точка, где они все согласуются сильнее всего. Поэтому «попасть» в него — значит не получить большее число, а приблизиться к центру того, что ищет . Десять миллиардов реальных получили свой шанс, и предложение, составленное только на основе объяснения, оказалось ближе.
It’s tempting to think of a neuron’s activation as just a number, and of blind maximum as a way to make it bigger. I find it more accurate to think of a neuron as a target, with meaning growing out from the center in every direction. Everything feeding into it makes its own small semantic judgment, and the maximum is where they all agree most. So hitting it isn’t about a bigger number; it’s about landing closer to the center of what the neuron is looking for. Ten billion real tokens had their chance, and a sentence written from the explanation alone got closer.
Агент 2 никогда не видит , он видит только объяснение, и его предложение все равно активирует сильнее, чем любой пример, который мы нашли в корпусе.
Одно ограничение заключается в том, что проверяет центр , а не его широту. Если выполняет несколько функций, даже связанных, один может активировать только одну. Поэтому мы также кластеризуем , поступающую в . Для , реагирующего на микрочипы домашних животных, это даёт группы входящих для маркировки животных, поиска потерянных питомцев и спасения, а также идентификации по микрочипу и RFID: три направления, исходящие из одного центра. Затем мы проводим для каждой группы, аблируя все остальные, и сравниваем результат с самым сильным примером из корпуса при той же аблиации. Группа, которая была "упакована", а не "выращена", проявилась бы здесь как объяснение, не связанное с остальными, но всё ещё способное активировать . Это не даёт полного покрытия, но охватывает гораздо больше целевой области, чем одна попытка воздействовать на её центр.
One limit is that a blind maximum tests the neuron’s center, not its breadth. If a neuron has several jobs, even related ones, a single blind maximum may only reach one. So we also cluster the attribution flowing into the neuron. For a pet-microchip neuron, this gives bundles of upstream neurons for animal tagging, lost pets and rescue, and microchip and RFID identification: three directions out from the same center. We then run a blind maximum for each bundle, ablating all the others, and compare it against the strongest corpus example under the same ablation. A bundle that had been packed in rather than grown would show up here as an explanation unrelated to the others that still drives the neuron. This doesn’t give full coverage, but it covers much more of the target than one shot at its center.
Существуют также общие тесты, например предсказание и по объяснению. Честно говоря, я доверяю им лишь до определённой степени. «Кошки и автомобили» могут хорошо проходить многие тесты для V-, совершенно не понимая, что он представляет на самом деле. Вы можете опровергнуть это, заметив связь с пламенем, или поступить иначе, но все такие проверки требуют креативности и суждения, а не сводной статистики. Интерпретируемость здесь имеет ту же структуру, что и остальная естественная наука: ньютоновская гравитация объяснила огромный спектр наблюдений, но дала сбой из-за крошечного расхождения в орбите Меркурия. Лучшая критика всегда специфична для конкретной гипотезы.
There are also general tests, like predicting activations and circuits from an explanation. To be honest, I trust these only up to a point. “Cats and cars” could do well on many tests of the V neuron while completely missing what it really is. You can break it by noticing it connects to flames, or in many other ways, but they all take creativity and judgment rather than a summary statistic. Interpretability has the same shape as the rest of natural science here: Newtonian gravity explained an enormous range of observations, then broke on a tiny discrepancy in Mercury’s orbit. The best criticism is specific to the conjecture.
На пути к
Мы можем вернуться к ранним языковым моделям и выяснить, почему их было трудно понять, так же как вернулись к ранним компьютерного зрения. Лучше всего я знаком с GPT-2 XL. Эту модель использовали в исходном проекте автоматической интерпретацииLanguage Models Can Explain in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. Ссылки ↓, который я начал в OpenAI. Тогда оказались менее 2% её . Мы вновь исследовали её и подготовили 500 статей о , практически без итеративной доработки. Теперь примерно 70% выглядят как с одной основной задачей. У некоторых остаются дополнительные отклики, похожие на . Совершенно по-прежнему немного, около 5%. Остальные выполняют несколько широких задач, до шести, чаще всего две. Способ оценки отличается от исходного проекта. На задаче реконструкции , которую мы использовали тогда, нам удаётся получать результаты в несколько раз лучше без итераций. Но я больше не считаю её особенно хорошей метрикой для объяснений, см. «Об оценках симуляции». Подробности будут в нашей готовящейся технической статье. В целом небольших моделей охватывают более широкий круг задач, а остаточное выражено у них сильнее, чем в современных моделях.
Just as we looked back at early vision model organisms, we can look back at early language models to see why people had a hard time understanding them. One I know better is GPT-2 XL, the model in the original automated interpretability project [8] Language Models Can Explain Neurons in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. References ↓ I started at OpenAI, where fewer than 2% of its neurons came out clean. We went back and made 500 neuron papers with almost no iteration. Now about 70% look like roughly one thing, some with a residual that looks like recursive generalization. The amount of pristine ones are still low, about 5%. What’s left are neurons that do a few broad things, up to about six, mostly two. The scoring isn’t identical to the original project. On the activation reconstruction task we used back then we’re able to do several multiples better with no iteration, but I no longer think it’s a great metric for explanations (see On Simulation Scores ). There’s more detail in our forthcoming technical paper. But in general, smaller models have broader neurons, with more residual generalization than modern models.
Что-то подобное могло произойти с во введении Towards MonosemanticityTowards : Decomposing Language Models With Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Thread. Ссылки ↓, на что указали несколько человек и агентов, когда мы говорили, что могут быть чистыми. Статья начинается с замечания, что было бы неплохо, если бы были интерпретируемыми, но они содержат произвольные смеси. В ней приводится пример «кошка-машина», а также из его однослойной языковой модели, который срабатывает на «смесь академических цитат, английских диалогов, HTTP-запросов и корейского текста».
Something similar may have happened with the neuron in the introduction of Towards Monosemanticity [10] Towards Monosemanticity: Decomposing Language Models With Dictionary Learning Bricken, T., Templeton, A., Batson, J., et al., 2023. Transformer Circuits Thread. References ↓ , which several people, and agents, pointed us to when we said neurons might be clean. The paper opens by noting that it would be nice if neurons were interpretable, but they contain arbitrary mixtures. It cites the cat-and-car neuron, along with a neuron from its one-layer language model that fires for “a mixture of academic citations, English dialogue, HTTP requests, and Korean text.”
Я думаю, это может быть «» — мотив, который мы видим повсюду в языковых моделях. Почти все цитаты, диалоги и HTTP-запросы срабатывают на точке или рядом с ней, и восемь из десяти его самых сильных отрицательных -связей начинаются с точки. Остаются примеры на корейском языке: они срабатывают примерно на две трети пути через незавершённый слог, что вполне разумно, если не хочется ставить точку. Или, возможно, это второе явление; без модели мы не можем дальше сужать объяснение. В любом случае, это два небольших синтаксических толчка, и легко понять, почему они вместе.
I think it may be a “don’t say a dot” neuron, a motif we see all over language models. Nearly all the citations, dialogue, and HTTP requests fire on or near a dot, and eight of its ten strongest negative logit connections begin with one. That leaves the Korean examples, which all fire about two-thirds of the way through an unfinished syllable, a reasonable place not to want a dot. Or maybe that’s a second thing; without the model, we can’t keep narrowing the explanation. Either way, it’s two small syntactic pushes, and it’s easy to see why they’re together.
Этот фрагмент встречается в 16 из 20 самых сильных контекстов.
, которые он подавляет6 самых отрицательных
.--1.18.-1.15.,-1.09.:-1.01.;-0.90uncture-0.89
Убрать его → следующий . растёт в 20/20 верхних контекстах.
Qwen3.6
Та же видимая закономерность
Где она активируется
… Go back to a Fortune 500. You’ll be safe.14.81
… Tacotarians across the U.S.7.25
… implementation details (i.e. encoding.)7.06
… So indeed all sides are 20.4.91
… at 8:00 p.m.4.81
… une main étendue au-dessus.....14.75
Точки в прозе, сокращения, технический текст и многоточия.
, которые он подавляет6 самых отрицательных
.-0.289.**-0.189.\-0.185.`-0.180.|-0.174.]-0.172
Убрать его → следующий . становится более вероятной в 30/30 активных сильных тестах.
Слева: Towards в собственном просмотрщике; справа: Qwen3.6, выполняющий ту же задачу. Удалите любой из них, и следующая точка становится более вероятной.
Я считаю этот пример полезным, потому что это известный произвольный микс, который, как оказалось, занимает промежуточное положение, по крайней мере на данный момент, поскольку у нас нет модели, чтобы продолжать проверять. Мы не знаем, является ли это одним явлением или одним явлением плюс более слабым, связанным синтаксическим паттерном. Но в любом случае это гораздо более узкое и обнадеживающее объяснение, чем четыре несвязанных явления, а термин «» объединяет их все, хотя они находятся на очень разных уровнях интерпретируемости.
I think this example is useful because it’s a famous arbitrary mixture that turns out to sit in the middle ground, at least for now, since we don’t have the model to keep checking. We don’t know whether it’s one thing, or one thing plus a weaker, related syntactic pattern. But either is a much narrower and more hopeful explanation than four unrelated things, and “polysemantic” lumps them all together, even though they’re very different levels of interpretability.
В 2023 году, в период первого автоматического анализа интерпретируемостиLanguage Models Can Explain in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. Ссылки ↓, я считал, что маленькие упрощённые модели — лучшее отправное место для интерпретируемости: там меньше «украшательств», о которых нужно думать, а малый размер означает меньше объектов для изучения. Но теперь я думаю, что может быть наоборот. Эти «украшательства» существуют, чтобы помочь сети учиться лучше, как, например, , которого не было у , а при упрощении легко сделать так, что будут учиться хуже. Большие модели, как правило, имеют более узкие , поэтому легче выявлять паттерны и мотивы. По крайней мере, для GPT-2 я часто смотрел на несколько мотивов одновременно, ни один из которых мне не был известен, что усложняло дело. Принимая архитектуры и масштаб, к которым всё равно стремилась область, мы, возможно, неосознанно скользили к .
In 2023 during the time of the first automated interpretability project [8] Language Models Can Explain Neurons in Language Models Bills, S., Cammarata, N., Mossing, D., et al., 2023. OpenAI. References ↓ I thought small simplified models would be the best starting place for interpretability, since there’s fewer bells and whistles to think about, and small size means fewer things to study. But now I think it may be the opposite. The bells and whistles are there to help the neural network learn better, like the residual stream InceptionV1 never had, and by simplifying it’s easy to make neurons learn less well. And bigger models tend to have more narrow neurons, so it’s more easy to spot patterns and motifs. At least for GPT-2, I was often looking at multiple motifs together, neither of which I knew, which made things hard. By adopting the architectures and scale the field wanted anyway, we may have been slouching towards monosemanticity without knowing it.
Беспокойство относительно заключается не в том, что объектов, которые нас интересуют, больше, чем измерений. Это непрерывный аналог упаковки: , переплетённые друг с другом, допускающие определённые помехи в обмен на возможность хранить больше данных. Полностью исключить это может быть невозможно. Но на практике это не стало . Мы можем читать, что записывают в и что они из него читают, получаются чистыми, и мы не видим, чтобы поток накапливал помехи только для того, чтобы позже их устранить.
The worry with the residual stream isn’t that there are more things we care about than dimensions. It’s a continuous version of packing: manifolds woven through each other, accepting some interference in exchange for room to store more. Ruling that out entirely may not be possible. But in practice it hasn’t been a bottleneck. We can read what neurons write to the residual stream and what they read from it, attribution graphs come out clean, and we don’t see the stream accumulating interference only to undo it later.
В моделях компьютерного зрения мы тоже могли бы проверить это визуально. Долгие годы я не мог визуализировать сверточных сетей: каждая карта выходила в виде одной большой дуги. Оказалось, сеть помещает почти всю массу в одно нечитаемое измерение, которое она может менять, чтобы масштабировать все остальные измерения, считываемые через . Как только мы это поняли, удалить его стало легко, и карты стали осмысленными. Технические детали того, как это работает, или даже того, что именно происходит, менее важны, чем более общий паттерн, прослеживающийся во всём этом эссе: найдите, что делает архитектура, и работайте с этим, а не боритесь с сетью. Это также указало на нечто, к чему область в итоге всё равно пришла: .
In vision models, we could also check this by eye. For years I couldn’t visualize the residual stream of convolutional networks: every map came out as one big arc. It turned out the network was putting almost all of its activation mass into a single unread dimension, which it can change to scale all the other dimensions that are read through LayerNorm. Once we understood that, removing it was easy, and the maps made sense. The technical details of how it works, or even what it’s doing, are less important than the more general pattern throughout this essay: find what the architecture is doing and work with it, rather than fighting the network. It also pointed toward something the field ended up building anyway: attention.
Мы не знаем, нужна ли языковым моделям аналогичная коррекция. Когда мы визуализировали их , это в основном просто работало. Однако судить о том, имеет ли смысл вся карта текста, гораздо сложнее, чем бегло взглянуть на карту изображений, именно поэтому большую часть этой работы мы провели в области компьютерного зрения. В любом случае, единая глобальная карта может быть не лучшим инструментом для языковых моделей. Каким бы ни оказался правильный взгляд (субмногообразия, то, какие считывают и записывают , или считывания в стиле линзы), всё, что мы пробовали, работало, и мы не на какую-либо часть , которую не смогли бы осмыслить.
We don’t know whether language models need a similar fix. When we’ve visualized their residual streams, it has mostly just worked. Judging whether a whole map of text makes sense is much harder than glancing at a map of images, though, which is why we did most of this work in vision. A single global map may not be the best tool for language models anyway. Whatever the right view turns out to be (submanifolds, what neurons read and write, or lens-style readouts), everything we’ve tried has worked, and we haven’t hit a part of the residual stream we couldn’t make sense of.
() на каждом слое , изображённый в виде одной карты. Каждая линия прослеживает одно местоположение изображения от первого слоя (слева) до последнего этапа (справа), начиная с цвета своего патча. На первом слое карта отсортирована по цвету. Местоположения, которые в итоге становятся лицами животных, начинаются там, где их цвет меха помещает их, и постепенно собираются вместе. Красные патчи начинаются вместе, а затем превращаются в разные вещи. Наведите курсор или нажмите на строку, чтобы увидеть её патч на каждом этапе.Текст и подписи схемы по-русски
Разные цвета, одна вещь
места, которые в итоге превращаются в лица животных
на первом слое
на последнем этапе
этап 1
2
3
4
Один цвет, разные вещи
красные пятна на первом слое
на первом слое
на последнем этапе
этап 1
2
3
4
Другие группы, оказавшиеся вместе
выбрано на последнем этапе
Люди
начинаются отдельно
1
2
3
4
Текст и знаки
начинаются отдельно
1
2
3
4
Трава
начинают вместе
1
2
3
4
Небо
начинают вместе
1
2
3
4
на каждом слое , изображённый в виде одной карты. Каждая линия отслеживает одно местоположение изображения от первого слоя (слева) до последнего этапа (справа), начиная с цвета своего патча. На первом слое карта отсортирована по цвету. Местоположения, которые в итоге становятся лицами животных, начинаются там, где их цвет меха помещает их, и постепенно собираются вместе. Красные патчи начинаются вместе, а затем превращаются в разные вещи. Наведите курсор или нажмите на строку, чтобы увидеть её патч на каждом этапе.
Как создаётся карта
Одни и те же локализации изображения прослеживаются через каждый слой, при этом тяжёлые координаты откладываются в сторону, а каждый слой центрируется. Четыре стадии имеют разные ширины и разрешения, поэтому пространство каждой стадии поворачивается, чтобы выровняться с пространством следующей стадии, сопоставляя каждую локализацию с ячейкой, содержащей её после уменьшения разрешения. Это поворот подгоняется; это не собственное уменьшение разрешения сети. Одна подгоняется ко всем слоям одновременно, при этом соседи каждого состояния берутся только из других локализаций, поэтому локализация перемещается, когда меняются её соседи. Ничто в методе не упорядочивает слои: карта получается упорядоченной по глубине, и мы повернули её так, чтобы глубина шла слева направо. Лица животных и группы на маленьких картах являются кластерами потока на полпути через последнюю стадию, поэтому их сход в конце обусловлен конструкцией. Красные патчи — это кластер первого слоя, поэтому их начальное объединение обусловлено конструкцией. То, что добавляет каждая панель, — это другой конец. Измеренные в полном потоке, а не на карте, ближайшие соседи лиц переходят от случайных к преимущественно другим лицам, а красных патчей — от преимущественно других красных патчей к близким к случайным. Выделенные строки были выбраны на глаз для удобства чтения, а бледные линии представляют собой случайную выборку каждой группы. Линии сглаживаются вдоль глубины. Выход последнего блока исключён, поскольку там поток сгруппирован по изображению и классу.
Мы также попробовали «сжать» сам , подобно нашим экспериментам со сжатием слоёв. Мы переобучили нашу модель со 7 млн параметров и средней шириной, сделав поток в четыре и восемь раз уже, вплоть до всего 46 измерений в последнем блоке, сохранив при этом все . Точность упала с 72% до 60% и 39%, но по сравнению с моделью нормальной ширины карта сжатого потока выглядит довольно похоже, лишь немного более зашумлённой. Ничего не выглядит искусно переплетённым. Чтение и запись рассказывают ту же историю: вещи становятся более зашумлёнными, но то, что просачивается, — это тот же самый тип объектов. «тёмная птица на воде» также срабатывает на аллигаторах и плывущем ретривере, а не на часах.
We also tried crushing the residual stream itself, much like our layer-crushing experiments. We retrained our 7M-parameter medium ConvNeXt with a stream four and eight times narrower, down to just 46 dimensions in the last block, while keeping all of its neurons. Accuracy fell from 72% to 60% and 39%, but compared with a normal-width model the crushed stream’s map looks quite similar, just a bit messier. Nothing looks cleverly interleaved. Neuron reads and writes tell the same story: things get noisier, but what leaks in is the same kind of thing. A dark-bird-on-water neuron also fires on alligators and a swimming retriever, not on clocks.
Мы больше заботимся об активных , мешающих пониманию сетей, чем о доказательствах того, что может или не может содержать . Если интерференция не проявляется на картах или в том, что читают и записывают , даже когда мы убираем пространство, мы считаем, что находимся в довольно хорошем положении.
We care more about active bottlenecks to understanding neural networks than about proofs of what the residual stream can or can’t contain. If interference isn’t showing up in the maps or in what neurons read and write, even when we take away the room, we think we’re in a pretty good spot.
Остаётся опасение, что больше, чем размерностей в . Поток может вмещать гораздо больше информации, чем позволяет его размерность, просто располагая данные в нужных направлениях, поэтому само по себе это не является упаковкой. Это имеет значение в основном тогда, когда хочется получить большой список всех модели, и люди часто обращаются к потоку именно с такой целью. Как мы обсуждаем в разделе «Zooming Out», мы не считаем, что такой большой список — правильная конечная цель. Но если вы всё же хотите его получить, направления, в которых записывают данные и из которых считывают, — хорошее место для начала. Таким же хорошим началом служат непрерывные , например те, которые находит Блочный разреженный извлекатель признаковUncovering Neural Geometry in Vision Models With Block-Sparse Featurizers Фель, Т., Коуол, М., Джейкобс, М. и др., 2026. Goodfire. Ссылки ↓. Это кажется особенно естественным, поскольку не имеет выделенного базиса. Пока все эти подходы работали хорошо: они находят осмысленные подпространства, и мы можем прослеживать их через слои.
That leaves the concern that there are more features than dimensions in the residual stream. A stream can hold far more than it has dimensions just by placing things in the right directions, so this alone isn’t packing. It mostly matters if you want a big list of all the model’s features, and people often go to the stream for exactly that. As we discuss in Zooming Out, we don’t think a big list is the right end goal. But if you want one, the directions neurons write to and read from are a good place to start. So are continuous submanifolds, like those Block Sparse Featurizer [28] Uncovering Neural Geometry in Vision Models With Block-Sparse Featurizers Fel, T., Kowal, M., Jacobs, M., et al., 2026. Goodfire. References ↓ finds, which seem especially natural here since the residual stream has no privileged basis. So far all of these have worked well: they find sensible subspaces, and we can follow them across layers.
Мы меньше изучали языковых моделей, но увиденное укладывается в ту же картину. Для понимания высокоуровневой структуры и мотивов ничего в пока не мешало нам.
We’ve looked at language models’ residual streams less, but what we’ve seen fits the same story. For understanding higher-level structure and motifs, nothing in the residual stream has blocked us so far.
Мы добились меньшего прогресса в изучении , чем в изучении , и это в основном выходит за рамки данного эссе. Честно говоря, я не уверен, что кто-то понимает достаточно хорошо, чтобы уверенно утверждать, что нечитаемость является в том смысле, который нас интересует. Отличить её от всех других возможных вариантов сложно, и изменение принципа обучения не должно находиться в верхней части списка гипотез о том, почему новые механизмы трудно понять.
We’ve made less progress on attention than on neurons, and it’s mostly outside the scope of this essay. To be honest, I’m not sure anyone understands attention well enough to confidently say that illegibility is a superposition in the sense we care about. Distinguishing it from all the other things it could be is hard, and a change in learning principle shouldn’t be near the top of the list of hypotheses for why new mechanisms are hard to understand.
Кажется, основная ценность механизма заключается в более простых задачах.
Мы можем разбить на несколько вопросов: куда оно смотрит, что ищет, что делает при обнаружении и почему действует именно так.
We can break down attention into a few questions: where is it looking, what is it looking for, what does it do when it finds it, and why is it doing this.
Куда именно смотрит модель, относительно просто. Это практически дается бесплатно и уже многое вам говорит. В графе преэклампсии она выполняет две отдельные функции. Сначала она собирает факты дела на место «she» (она), где модель решает медицинский вопрос. Затем формулировка вопроса определяет, что именно сказать дальше.
Where it looks is relatively easy. It basically comes for free, and it already tells you a lot. In the preeclampsia graph it does two separate things. First it gathers the facts of the case onto “she,” where the model works out the medical question. Then the question’s wording decides what to actually say next.
1Медицинский вопрос: ключевым становится местоимение «she»
ВопросПациентка, 32 года, на 30 недель беременности жалуется на сильную боль в правом верхнем квадранте живота, легкую головная больи тошноту. АД 162/98 мм рт. ст., а анализы показывают слегка повышение уровня печеночных ферментов. Если мы можем задать вопрос только об одном другом симптом, нам следует спросить, испытывает ли она симптомы…QwenНам следует спросить, действительно ли онаиспытывает визуальные искажения0.90
, слои 24–31: преэклампсии срабатывает на «she», хотя это слово никогда не пишется.
2Что сказать дальше: формулировка запроса требует указания на симптом, который она ощущает
ВопросПациентка, 32 года, на 30 недель беременности жалуется на сильную боль в правом верхнем квадранте живота, легкую головная больи тошноту. АД 162/98 мм рт. ст., а анализы показывают слегка повышение уровня печеночных ферментов. Если мы можем задать вопрос только об одном другом симптом, нам следует спросить, испытывает ли она симптомы…QwenНам следует спросить, действительно ли онаиспытывает визуальные искажения0.90
Слова «symptom» и «experiencing» требуют назвать то, что она ощущает. Если вместо этого спросить об обнаруженном у неё , модель ответит: «белок в моче».
Мы также можем понять, что она ищет, и что она делает, когда находит это, в терминах . Мы думаем, что это даёт вам большую часть преимуществ того, что делает .
We can also understand what it’s looking for, and what it does when it finds it, in terms of neurons. We think this gives you a lot of the benefit of what attention is doing.
Например, возьмите запятую после «headache.» в примере с преэклампсией. Три слоя 30 считывают данные непосредственно из , но если проследить, что записывается в этих направлениях, мы увидим головной боли, мигрени и мозга. То, что они записывают, в основном попадает в преэклампсии на запятой и в некоторых соседних , таких как эклампсия и гипертензия. этих голов снижает вероятность преэклампсии на четверть. Если запретить им обращать на боль, ничего не меняется.
For instance, take the comma after “headache.” in the preeclampsia example. Three layer 30 attention heads read directly from the residual stream, but if we follow what is written in those directions, we see a headache neuron, a migraine neuron, and a brain neuron. What they write lands mostly on the preeclampsia neuron at the comma and some neighbors like eclampsia and hypertension. Ablating these heads drops preeclampsia by a quarter. Stopping them from looking at pain and nothing changes.
преэклампсии на «,», передаваемый тремя головами, слой 30
Головы не могут обращать на «головную боль»45.5 → 34.5
…или на «боль» вместо этого45.5 → 45.8
Заглушите там головной боли45 → 30.3
Музыкальный на слове «it», передаваемый одной головой в слое 31, при поддержке слоёв 28–30
«it» не может смотреть на «music»31.1 → 0.26
…или на «sentence» вместо этого31.1 → 33.8
Заглушить 100 музыкальных там31.3 → 1.7
Второй «музыкальный» чип — это отрицательная сторона его : он почти не срабатывает положительно, а его самые сильные отрицательные срабатывания приходятся на слово «music».
Neverland на слове «land», переносимый одиннадцатью головами, слоями 1–4
Головы не могут смотреть на «Never»47 → 18.8
…или на «Pan» вместо этого47 → 47
Заглушить 10 на слове «Never»47 → 29.6
Чипы под — это , которые активируются там. Мы можем проследить часть того, что делает , наблюдая за потоком , на которые оно влияет.
Это также работает в обратную сторону. Некоторые гораздо легче увидеть, когда можно увидеть вокруг них, а некоторые головы имеют смысл только через свои .
It also works the other way. Some neurons are much easier to see once you can see the attention around them, and some heads only make sense through their neurons.
Дополнительно: , затем с заблокированным взглядом
28 января, 2013 … объявлено что7.3 → 0.1
(Мозер и Адамс 2012)6.6 → 0.2
Волк с Уолл-стрит стрит … что год7.4 → 1.9
как сланец, ослабили OPEC6.1 → 1.6
ELA Common CoreРесурсы5.1 → 0.5
Gangnam Style … мои друзья что0.4, без взгляда
Метка этого — «общие служебные слова»: он активируется на словах вроде «the» и «that». Но он активируется только в тексте примерно 2012–2016 годов, и он получает дату от одной головы (head), которая косвенно обращается к ближайшей подсказке, здесь это «7» в «iOS 7». Заблокируйте этот один взгляд, и упадёт с 5.2 до 0.2. Заблокируйте три головы, которые смотрят на «7», ещё сильнее, и он останется на уровне 4.8. Он работает только тогда, когда голова случайно смотрит на подсказку: «Gangnam Style» и «Flappy Bird» промахиваются.
Дополнительно: , затем с заблокированным взглядом
наконец пинка the ведро13.7 → −0.4
не обязана ломать the банк6.4 → −0.1
Стоп тянущий my нога5.0 → −0.2
мою тётю делает a суету3.3 → −0.3
Она открыла тяжёлую дверь0.2, без взгляда
Этот заголовок (head) опирается на первое слово в 91% случаев, поэтому его паттерн мало что вам расскажет. , который он питает наиболее сильно, демонстрирует свою задачу: в конце выражения вроде «rocked the boat» он смотрит назад на глагол, с которого оно началось, и срабатывает. Блокировка этого одного взгляда снижает значение с 13.4 до −0.1. Блокировка того же взгляда через другую голову, которая смотрит на «rocked» еще сильнее, оставляет его на уровне 12.9. Голова таким же образом питает несколько других ; это основной из них.
Дополнительно: голова на слове «may» с → без
это может … Этот перечень может0.85 → 0.06
He может … основные убеждения может0.84 → 0.10
ты может … пример может0.64 → 0.03
Ваша собака может … Это может0.63 → 0.03
, срабатывающий на слово «might», записывает данные в запрос одной головы, и эта голова ищет более раннее «may». Удаление приводит к тому, что головы на слове «may» падает с 0.69 до 0.03, и оно переключается на первое слово. Удаление такого же количества других ранних ничего не меняет. Для всех 32 пар may…might в нашем корпусе это по крайней мере уменьшается вдвое в 31 случае. Голова чувствительна: любое сильное усиление на «might» ослабляет её примерно на четверть, но эффект в три раза больше.
Понимание и через друг друга. Три случая в , где и голова имеют смысл только вместе. Ниже приведены дополнительные примеры: выделено то, что считывает голова, в рамке — место срабатывания . Наведите курсор на рисунок для проверки.
В целом мы не считаем, что и так сильно разделимы. Понимание того, куда помещает информацию, очень помогает в понимании , которые затем работают с этой информацией. Даже такие простые вещи, как паттерны вокруг мест, где информация обычно размещается, например, в концах чисел или на запятых, оказались полезными.
Overall, we don’t think attention and neurons are so separable. Understanding where attention is putting information is quite helpful for understanding the neurons that then work with that information. Even simple things like motifs around where information tends to be placed, like the ends of numbers, or on commas, have been helpful.
По моему опыту, знание того, от каких считывает информацию , на какие она влияет и куда смотрит, даёт многое. Но одно главное она не даёт — это глобальные имена для каждой . Было бы неплохо иметь такие имена, но это не стало серьёзным препятствием для изучения или . Рассмотрев довольно много голов, я предположил, что предельная «объяснительная остаточная» польза от глобальных имён голов составляет около 5%. Затем я попросил агента сделать то же самое, рассмотрев 100 без моего предварительного предположения, и он также оценил это примерно в 5%, разделив оценку примерно поровну между «», которые относительно легче назвать, поскольку они выполняют такие действия, как просмотр одного назад, и всем остальным, которое, конечно, разнообразно и сложнее.
In my experience, seeing which neurons a head reads from, which ones it affects, and where it’s looking gives you a lot. One main thing it doesn’t give you is a global name for each attention head. It’d be nice to have them, but it hasn’t been a big bottleneck on exploring neurons or attribution graphs. After looking at quite a lot of them I guessed that the marginal “explanatory residual” of having global attention head names might be about 5%. Then I had an agent do the same, looking at 100 attribution graphs without my guess, and it also put it about 5%, split about equally into “position heads” that are relatively easier to name, since they do things like look one token backwards, and everything else, which is of course varied and harder.
Трудно оценить ценность знаний, которых у вас ещё нет, поэтому эти оценки могут сильно ошибаться. Но пока, на мой взгляд, даже без глобальной разметки голов можно довольно далеко продвинуться в поиске высокоуровневой структуры и мотивов. Для этого достаточно локального потока и глобальных объяснений . Мой прогноз, в котором я не очень уверен: окажутся широко обобщающими, в том числе рекурсивно, как небольших моделей. Ведь их гораздо меньше: в несколько тысяч голов против более миллиона .
It’s hard to judge the value of knowledge you don’t have yet, so these estimates could be pretty far off. But so far even without global attention head labels I think we can go quite far in discovering high level structure and motifs with just local attention flow and global neuron explanations. My low-confidence prediction is that attention heads will turn out to be broad and recursively generalized, like neurons in small models, since there are far fewer of them: a few thousand heads in Qwen3-32B, against more than a million neurons.
От к целой сети
Что я называю
Сети
Одна сеть
Район
Обучение
маленький92k параметров
средний7,06 млн параметров
большой28,6 млн параметров
Собаки и дикие млекопитающие
Dogs
Dogs
чёрно-белые собаки
бостон-терьеры
этап 0
этап 1
этап 2
этап 3
ответ
лица и мех животных
морды собак
Dogs
породы собак
плоскомордые мопсы и бульдоги
хаски, волки и лисы
колли, корги и шелти
маленькие белые пушистые собаки
чёрные собаки и тёмные животные
неопрятные палевые терьеры
короткошёрстные собаки танно-чёрного окраса
Dogs
дикие млекопитающие
Птицы
боксеры
Бостон-терьеры, блоком ранее
бордер-колли
трёхцветные горные собаки
миниатюрные пинчеры
плоскомордые собаки
бостон-терьеры
бостон-терьерыдо +50 · повышает «бостон-терьер»
серые лисыдо −52 · повышает «серая лиса»
этап 3, блок 2, 61
its 364 input weights
364 , по одному на канал потока, который он считывает
те же самые , считанные по отношению к 2 048 , которые записывают данные в этот поток: 8 крупнейших
бостон-терьерыотрицательная сторона
бордер-колли
трёхцветные горные собаки
чёрно-белые собаки
Апенцеллеры и горные собакиотрицательная сторона
черно-белые морды собак
темные животные на поляхотрицательная сторона
темные пушистые животные
эпоха
его 364
+ сторона
− сторона
наиболее сильно подтолкнуто
0
1
2
5
10
20
45
90
Воспроизвести
Три сети, обученные независимо и различающиеся по размеру в 300 раз, развивают одни и те же районы: более грубые в маленькой сети, более тонкие в большой.
Сравнение на основе того, как сети были обучены. Нити соединяют районы, реагирующие на одни и те же классы; в маленькой сети нет бостон-терьера, только общие собак.
Здесь ничего не было изменено или перекомбинировано. Каждый район, и принадлежат самой сети, в том виде, в котором она их выучила.
Когда я говорю, что нейросети уже , я имею в виду нечто большее, чем . Хотя даже по этому критерию, на мой взгляд, положение гораздо лучше, чем ожидает исследовательское сообщество. Части сети устроены так, чтобы последующие механизмы могли считывать их выходы и использовать их в дальнейших вычислениях.
В этом смысле нейросеть почти фрактал объяснений, то есть осмысленных, полезных группировок. Они возникают и на крупном масштабе, в механизмах сети, и на малом, где формирует каждый из этих механизмов. Отсюда и цель интерпретируемости: стать ещё одним читателем сети.
When I say neural networks are already clean, I mean something deeper than neuron monosemanticity, although even by that standard, I think things look much better than the field expects. I mean that a network’s parts are built to be read, and built upon, by its downstream readers. In this sense, a neural network is almost a fractal of explanations, of coherent, useful groupings: at the macro scale, in its mechanisms, and at the micro scale, where recursive generalization shapes each one. That points to a goal for interpretability: become another reader.
Думаю, чем точнее мы будем читать сеть так, как это делают её собственные механизмы, тем понятнее она будет казаться. Стоит остерегаться слишком человеческого прочтения: сеть не обязательно хаотична только потому, что не вписывается в наши заранее выбранные понятия.
The more we read it the way its own readers do, the more interpretable I think it will look. We should be wary of reading it too much like a human, and concluding it’s messy just because it doesn’t fit our preconceived concepts.
Я думаю, что причина, по которой всё оказывается столь организованным, частично в том, что так быстрее строить. Как только в сети появляется область для автомобилей с их деталями, добавить туда ещё один вариант автомобиля проще, чем создавать вторую область для автомобиля где-то ещё. Я думаю, это тесно связано с идеями гонки и .
I think the reason things end up so organized is partially because it was faster to build that way. Once you have a car area of the neural network with car parts, it’s easier to add the marginal car there than to build a second car area somewhere else. I think this is closely related to ideas of circuit racing and gradient starvation.
Обычно «интерпретируемый» и «» считают почти синонимами. Думаю, отчасти потому, что эти представления выросли из изучения , , который был почти бимодальным. Ранние слои были понятными и , а поздние выглядели произвольным хаосом. Но в языковых моделях мы видим нечто среднее: большинство в основном означают что-то одно, некоторые — несколько. Насколько это плохо?
We normally consider interpretable and monosemantic to be nearly synonyms. I think this is partly because these ideas grew out of a model organism (InceptionV1) that was almost bimodal. Early layers were interpretable and monosemantic, late ones seemed like arbitrary mayhem. But what we see in language models is somewhere in the middle, with most neurons meaning mostly one thing, some meaning a few. How bad is that?
Существует два широких подхода к интерпретируемости. Один из них можно назвать . Его цель — составить большой список для аудита, чтобы убедиться, что мы не пропустили какую-либо значимую закономерность. В рамках этого подхода одной из главных проблем является , или элементов, связанных с другими элементами, где каждый из них означает более одной вещи.
There are two broad styles of interpretability. One we can call enumerative interpretability. The goal is to have a big list of features to audit, to make sure we haven’t missed some meaningful pattern. A big concern within this view is avoiding the curse of dimensionality, or a combinatorial explosion of items connected to other items, where each one means more than one thing.
Другой стиль, который мы можем назвать . Всё начинается с вопросов. Она может исследовать любую часть сети, плавно приближая и отдаляя вид, подобно Google Maps, на и таких механизмах, как или . По ходу дела мы задаём больше вопросов. Механизмы, такие как , – хорошее место для начала, но дело не в том, что являются каким-то окончательным решением для всего – хотя я думаю, что это ближе к этому, чем большинство людей осознаёт. Этот подход гораздо более устойчив к . Также вполне допустимо игнорировать большую часть сети, подобно тому как человек, изучающий город, игнорирует районы, не имеющие отношения к его анализу.
Another style we can call exploratory interpretability. It starts with questions. It can explore any part of the neural network, zooming in and out fluidly like Google Maps across attribution graphs, and mechanisms like neurons or attention heads. We pick up more questions along the way. The mechanisms like neurons are a good place to start, but it’s not about neurons being some final solution to everything – though I do think it’s closer to that than most people realize. This approach is far more resilient to polysemanticity. It is also broadly fine ignoring lots of the neural network, in the same way someone studying a city would ignore areas irrelevant to their analysis.
Я думаю, что исследовательские подходы будут более плодотворными. Моё ощущение таково, что поле уже движется в этом направлении, но я не уверен, что это чётко зафиксировано в письменном виде. Эта точка зрения имеет несколько следствий. Вопросы вроде «есть ли больше , чем измерений?» в основном нерелевантны. Нам не нужно определять , что, как известно, сложно. Мы можем сосредоточиться в основном на механизмах, таких как и , которые являются частью модели, на данных, проходящих через неё, а затем на группах того и другого и мотивах, которые повторяются во всём этом.
I think exploratory approaches will be more fruitful. My sense is that the field is moving in this direction already, but I’m not sure it has been written down clearly. This view has a couple implications. Questions like “are there more features than dimensions?” are mostly irrelevant. We don’t have to define features, which is famously difficult. We can focus mostly on mechanisms like neurons and attention heads which are part of the model, data flowing through it, and then groups of both and motifs that recur across all of this.
Большой список всегда был средством для достижения цели. Возможно, к ней ведут и другие пути, не требующие такого списка.
Мотивы вместо
Если бы я мог нажать кнопку и сделать каждый идеально или вместо этого разобраться в , стоящих за несколькими важными для меня вопросами, я бы без колебаний выбрал второе. Меня интересует, как правильно ставить вопросы о психологии агента, как связаны с моделью выбора персоны и как агент думает о своих целях и границе между собой и другими.
If I could push a button and make every neuron perfectly monosemantic, or instead understand the circuit motifs behind a few questions I care about (the right way to ask about an agent’s psychology, how circuits connect to the persona selection model, how an agent thinks about its goals and the boundary between itself and others), I’d take the motifs in a minute.
Представьте себе исследователя интерпретируемости, прибывшего на сто лет вперёд, который знает не только ответы на наши вопросы, но и какие вопросы нам следовало задавать. Что бы он нам сказал? Я не могу знать, но однажды я сам оказывался в подобной ситуации. Сейчас мне кажется, что я в основном понимаю модель зрения, что делает меня чем-то вроде будущего исследователя для себя самого восемь лет назад.
Imagine an interpretability researcher arriving from a hundred years in the future, who knows not just the answers to our questions but which questions we should have been asking. What would they tell us? I can’t know, but I’ve been in a small version of their position once. I now feel like I mostly understand a vision model, which makes me something like a future researcher to myself eight years ago.
Вот что я сказал бы себе тогда. Обрати на огромную схему распознавания позы прямо перед тобой. Считай вентилями в , а не противоположностью . В поздних слоях эксплуатирует уязвимости своей функции награды, поэтому часть видимого беспорядка создаёт инструмент, а не сеть. Последний слой отчасти беспорядочен из-за неудачной архитектуры. Это важный сигнал, не стоит его маскировать. И всякий раз, когда видишь , присмотрись внимательнее. Шум, который бросается в глаза, обычно указывает на объяснение, которого у тебя пока нет.
Here’s what I’d tell myself then. Pay attention to the giant pose circuit right in front of you. Think of negative poles as gates in a circuit, not a neuron’s opposite. Feature visualization reward hacks in late layers, so some of the mess there is the tool’s, not the network’s. The last layer is messy partly because of a bad architecture; that’s a sign, so don’t paper over it. And whenever you see polysemanticity, look harder. The noise that stands out usually points to an explanation you don’t have yet.
Почти ничто из перечисленного не является списком . Если не считать этого совета, лучшее, что я мог бы передать себе в прошлое, это сами исходные и с просьбой изучить их внимательнее.
Almost none of this is a list of features. Short of handing my past self this advice, the best thing I could give is the original neurons and circuits, with a note to look harder at them.
Вот почему разница между и имеет такое большое значение. Следовать за шумом имеет смысл только если в нём есть чему поучиться. Группировка, возникшая благодаря , действительно содержит полезную информацию. А вот группировка объектов, случайно оказавшихся вместе, почти ничего не даст.
This is why the difference between recursive generalization and superposition matters so much. Following the noise only works if the noise has something to teach. A grouping that grew from generalization does. A grouping of things packed together because they don’t belong together would teach almost nothing.
Поэтому я предполагаю, что совет исследователя из будущего был бы похожим. Он мог бы дать нам набор мотивов, очевидных для него, но не для нас. А если этого не произойдёт, он посоветовал бы продолжать изучать исходную нейросеть. Не дробить её слишком сильно. Учиться её видеть. Это немного напоминает «Автостопом по галактике»: ответ — 42 — уже известен, а найти нужно вопрос. Сеть — это ответ, а интерпретируемость во многом состоит в поиске правильного вопроса. Трудно найти для этого поиска лучший ориентир, чем сама сеть. Именно в этом более глубоком смысле я говорю, что сеть уже чиста.
So my best guess of the future researcher’s advice would look somewhat similar. They might hand us a set of motifs that look obvious to them but not to us. But short of that, they’d say keep looking at the original neural network. Don’t fracture it too much. Learn how to see it. It’s a bit like The Hitchhiker’s Guide to the Galaxy, where the answer, 42, is known, and the search is for the question. The network is the answer, and interpretability is largely the search for the right question. It’s hard to find a better guide to that question than the network itself. That’s the deeper sense in which I mean the network is already clean.
Город против узла
В более крупной системе не обязательно труднее ориентироваться. В маленьком городе вопрос о финансовом районе едва ли имеет смысл. Всё разбросано: банк на одной улице, страховая компания на другой, возможно, бухгалтер работает из дома. В Нью-Йорке такой район можно найти на карте за минуту. Небольшой аналог этого мы увидели в своих . В более крупных моделях агенты быстрее находили размеченные , реагирующие на собачьи уши. Там светлых ушей, волнистых ушей и ушей по бокам головы все передают сигналы одному висячих ушей. С него естественно начинать поиск.
A bigger system isn’t necessarily harder to navigate. In a small town, asking for the financial district barely makes sense. Whatever exists is scattered: a bank on one street, an insurance office on another, maybe an accountant with a home office. In New York, you could find it on a map in a minute. We saw a small version of this in our ConvNeXts: agents found labeled dog-ear neurons faster in the larger models, where pale, wavy, and head-side ear neurons all feed one hanging-ears neuron, a natural place to start.
Малый92k
Грубые ответы на собак
Средний7.06M
Возникают локальные ветви
Большой28.6M
Ветви сходятся и расходятся
Как меняется семейство ушей с масштабом в трёх сетях, различающихся по размеру примерно в 300 раз.
Интерпретируемости понадобятся лучшие карты. Я выступаю за : представления, которые позволяют нам отдалять масштаб, сохраняя при этом крупные паттерны связанными с и , которые их поддерживают. Наш атлас , вдохновлённый Activation Atlas Atlas Carter, S., Armstrong, Z., Schubert, L., Johnson, I. and Olah, C., 2019. Distill. Ссылки ↓, является одним из примеров. Начните с решения модели касательно косатки, проверьте ключевой по его реальным изображениям и затем отдалите взгляд. Оказалось, что эта семья состоит из трёх отдельных маршрутов: один для китов, один для акул и скатов и один для рыб, удерживаемых рыбаками. Карта не обязательно должна быть визуальной, и ни одна отдельная карта не является главной целью. Должно быть много карт и много агентов, все они работают над объяснениями, которые остаются привязанными к отдельным и .
Interpretability will need better maps. I advocate for tethered abstraction: views that let us zoom out while keeping the larger patterns connected to the neurons and circuits that support them. Our ConvNeXt atlas, inspired by Activation Atlas [2] Activation Atlas Carter, S., Armstrong, Z., Schubert, L., Johnson, I. and Olah, C., 2019. Distill. References ↓ , is one example. Start at the model’s decision for a killer whale, check a key neuron against its real images, and zoom back out. The family turns out to be three separate routes: one for whales, one for sharks and rays, and one for fish held up by anglers. A map doesn’t need to be visual, though, and no single map is the point. There should be many maps and many agents, all working toward explanations that stay tethered to individual neurons and circuits.
Интерфейс для исследования потока высокоуровневой через тысячи , разбитых на острова, каждый из которых соответствует блокам слоев в средней модели .
Конечно, если карту можно понять, это ещё не значит, что вы её поняли. Нам всё равно нужно заниматься — выдвигать гипотезы и критиковать их: предполагать, что перед нами, пытаться опровергнуть предположение и сохранять то, что выдержало проверку. Сеть странна, но её странности повторяются. Поэтому догадка, выдержавшая проверку, часто оказывается полезной во многих местах.
Of course, even if the map is understandable, that doesn’t mean you’ve understood it. We still have to do the ordinary science of conjecture and criticism: guess what something is, try to break the guess, and keep what survives. The network is strange, but its strangeness repeats, so a guess that survives scrutiny often pays off many times over.
Нам стоит опасаться двух вещей: навязывания собственных идей и фрагментации сети. Представьте, что вы прибываете в Токио, хорошо зная Нью-Йорк. Вопрос «Где токийский Бруклин?» может стать полезной отправной точкой. Но если вы в итоге реконструируете Бруклин из семидесяти разрозненных кусков Токио, вы можете сделать Токио намного более хаотичным, чем он есть на самом деле. Это напоминает ситуацию с 4e:55. Через призму наших категорий мы видели кошек и автомобили, и картина казалась беспорядочной; на самом деле же это была буква V. , обученная на этом слое, фрагментирует его аналогичным образом, разделяя V на автомобиля и кошки. Я не против разреженных словарей в целом, но в данном случае они отдаляют нас от того, что делает . Зонды усугубляют первый риск: они способны лишь ответить на вопрос, который у нас уже есть, поэтому не могут научить нас, какие вопросы задавать. Чтобы понять город, в конечном итоге приходится изучать его собственную организацию.
We should worry both about imposing our own ideas too strongly, and fracturing the network. Imagine arriving in Tokyo knowing New York well. “Where’s the Brooklyn of Tokyo?” could be a useful starting question. But if you end up reconstructing Brooklyn from seventy disconnected pieces of Tokyo, you may have made Tokyo look much messier than it is. That’s a bit like what happened with 4e:55. Through our categories it was cats and cars, and it looked like a mess; it was a V the whole time. An SAE trained on the layer fractures it the same way, splitting the V into a car feature and a cat feature. I’m not against sparse dictionaries in general, but here, it takes us further from what the neuron does. Probes push the first risk further: they can only answer a question we already had, so they can’t teach us which questions to ask. To understand the city, you eventually have to learn its own organization.
Структуры более высокого уровня, такие как зонды и разреженные словари, всё ещё могут быть полезны, но они относятся к концу, а не к началу. Всё, что я исследовал такого рода, распадается на высокоинтерпретируемые , как и изменения, вносимые обучением, включая само-дистилляцию on-policy. охватывают абстракции, а данные — частные случаи, поэтому то, что остаётся посередине, меньше, чем ожидают люди. Я бы изучал это так же: с помощью общего научного агента, перемещающегося между , данными и группами тех и других, а не с помощью фиксированной оптимизации. Как выразился Джошуа Батсон из Anthropic, прочитав черновик, эти недостающие элементы «впишутся в начальную головоломку, а не будут разбросаны по ней совершенно случайным образом».
Higher-level structures like probes and sparse dictionaries can still be useful, but they belong at the end, not the start. Everything of this kind I’ve run breaks down into highly interpretable neurons, as do the changes training makes, including on-policy self-distillation. The neurons cover the abstractions and the data covers the particular cases, so what’s left in between is smaller than people expect, and I’d study it the same way: with a general scientific agent moving between the neurons, data, and groups of both, not a fixed optimization. As Anthropic’s Joshua Batson put it when he read a draft, those missing pieces “will fit into the initial puzzle, rather than being totally randomly splayed on top.”
Решение проблемы интерпретируемости может иметь общее с достижением AGI: цели смещаются по мере приближения. Всегда находится ещё одна , на которую можно указать. В Детекторы кривыхCurve Detectors Cammarata, N., Goh, G., Carter, S., Schubert, L., Petrov, M. and Olah, C., 2020. Distill. Ссылки ↓ мы написали сорок страниц экспериментов над десятью именно для того, чтобы выявить хотя бы один достоверный случай . Спустя годы некоторые исследователи говорили мне, что всё ещё сомневаются в каких-либо из приведённых примеров. По их словам, мы могли что-то упустить, и никто не знает, как получить формальное доказательство. Согласно этому стандарту, даже утверждение о существовании хотя бы одного моносемантического является преувеличением.
Solving interpretability may share something with achieving AGI: the goalposts move as you get closer. There’s always another weak activation to point to. In Curve Detectors [21] Curve Detectors Cammarata, N., Goh, G., Carter, S., Schubert, L., Petrov, M. and Olah, C., 2020. Distill. References ↓ , we wrote forty pages of experiments on ten neurons precisely to identify at least one sure case of a monosemanticity. Years later, some researchers told me they still doubted any of the examples were monosemantic. We might have missed something, they said, and no one knows how to produce a formal proof. By that standard, it’s overclaiming to say even a single monosemantic neuron exists.
За сомнениями по поводу мелких ошибок в стоит страх, что безопасность сведется к какому-то сигналу , который мы пропустили, — месту, где скрывается обман. Риск, который меня беспокоит, отличается: это как оказаться в хорошо организованном городе и не знать, как о нём думать, потому что мы не являемся его аборигенами. Каждая ошибка, обсуждаемая в этом эссе, была чем-то, скрывавшимся на виду, что мы не умели читать, или что наши инструменты считывали неверно. Ни одна из них не была пропущенной скрытой . Обман может скрываться от того, кто читает выходы модели, но у него нет причин скрываться от собственной модели. Он должен быть доступен для своих читателей, и если мы станем читателями, он должен быть доступен и нам. Мой страх заключается в том, что обман будет прямо здесь, на виду, и мы не будем знать, как его прочитать.
Behind doubts about small errors in neurons is a fear that safety will come down to some activation we missed, the place where deception hides. The risk I worry about is different: like being in a well-organized city and not knowing how to think about it, because we aren’t native to it. Every error discussed in this essay was something hiding in plain sight that we didn’t know how to read, or that our tools read incorrectly. None was a hidden activation we missed. Deception might hide from someone reading a model’s outputs, but it has no reason to hide from the model’s own circuitry. It needs to be accessible to its readers, and if we become a reader, it should be accessible to us too. My fear is that deception will be right there, in plain sight, and we won’t know how to read it.
Со временем мой подход к отдельным механизмам стал менее сосредоточен на таких доказательствах и более целостным. Вместо того чтобы пытаться уловить каждую деталь работы одного , я смотрю на контекст вокруг него: что в него поступает, что он питает, как перемещает информацию к нему и от него, и как он выглядит в увеличенном и уменьшенном масштабе. Когда я работал над , срабатывание несколькими вдали от его основной темы казалось серьёзной проблемой. Но со временем стало ясно, что перемещает данные в надёжные места, где затем находятся , активирующиеся вблизи «соответствующего », а не на нём самом. Так ощущение понимания складывалось у меня: не как преодоление планки для каждого отдельного элемента, а как заполнение карты «тумана войны» на нескольких уровнях одновременно. помогают объяснять , помогают объяснять , а , в свою очередь, объясняет .
Over time, my approach to individual mechanisms has become less focused on this kind of proof, and more holistic. Instead of trying to nail every detail of one neuron, I look around it: what flows into it, what it feeds, how attention moves information to and from it, and what it looks like zoomed in and zoomed out. When I worked on automated interpretability, a neuron firing a few tokens away from its main topic seemed like a big problem. But over time it was clear that attention moves things to reliable places, which then have neurons that activate near the “appropriate token” rather than on it. That’s how understanding has felt to me: less like clearing a bar for each piece and more like a fog-of-war map filling in at several levels at once. Attribution graphs help explain neurons, neurons help explain attention, and attention explains neurons in turn.
сети редко застревают во время обучения, поскольку в высокоразмерном пространстве почти всегда есть путь вниз. По моему опыту, прояснение «тумана войны» работает так же. Всегда можно провести ещё один эксперимент, сузить ещё одно объяснение, проверить ещё один или понаблюдать за тем, как растёт ещё один в процессе обучения.
Neural networks rarely get stuck during training, since in a high dimensional space there’s almost always a way downhill. In my experience, clearing the fog of war works the same way. There’s always another experiment to run, another explanation to narrow, another attribution graph to check, another neuron to watch grow over training.
Именно поэтому я сосредоточился на том, есть ли какой-то уровень абстракции, на котором всё начинает давать сбой, где вы перестаёте что-либо узнавать и вынуждены разбирать сеть на что-то другое. Я не нашёл такого уровня. И когда каждый новый мотив одновременно рассеивает туман во многих местах, совершенствование одного , вероятно, не является лучшим использованием усилий. В этом есть своего рода вера: вы замечаете что-то странное, и со временем это обычно проясняется. Это не вера до самого конца, поскольку почти любое объяснение в конечном итоге можно проверить. Просто вера в то, что что-то странное — хороший указатель. Буква V в , реагирующем на машину и кошку, не так уж сложна для обнаружения — мне потребовалось около пяти секунд, и большинство людей, которым я показывал сетку изображений и спрашивал: «какой здесь общий паттерн?», тоже её видят, — но потребовалось поверить, что нашёл что-то реальное. На протяжении многих лет я слышал упоминания об этом почти в каждом обсуждении . Его почти всегда описывали в контексте того, что сети являются почти невалидными объектами для прямого изучения методами . Именно это я и говорил, пока не присмотрелся внимательнее. Это не потребовало много веры, но потребовало немного.
This is why I’ve focused on whether there’s any level of abstraction where things break down, where you stop being able to learn anything and have to take the network apart into something else. I haven’t found one. And when each new motif clears fog in many places at once, perfecting a single neuron probably isn’t the best use of effort. There’s a kind of faith in it: you note something strange, and over time it usually fills in. It isn’t faith all the way down, since almost any explanation can eventually be tested. Just faith that something strange is a good pointer. The V in the car and cat neuron isn’t hard to see – it took me about five seconds, and most people I’ve shown the image grid to and say “what’s the shared pattern here” see it too – but it took believing that the neuron had found something real. For years I’ve heard this neuron come up in almost every discussion of polysemanticity. It was almost always described in reference to neural networks being almost invalid objects of direct natural science. That’s what I was saying too, until I looked more closely. It didn’t take a lot of faith, but it took a little.
Небольшое доверие важно, потому что ошибки здесь несимметричны. Если вы предполагаете, что сеть , и ошибаетесь, запутанный становится зацепкой. Вы исследуете его, и со временем нормальная наука уточняет ваше объяснение. Если же вы предполагаете, что сеть плотно упакована и напрямую изучать её не стоит, и ошибаетесь, запутанный становится концом пути: вы перестаёте его исследовать. Я годами придерживался второго предположения, и оно позволяло отмахиваться от свидетельств, которые могли бы его опровергнуть. Я мог улучшать инструменты, наблюдать, как кажущиеся смеси одна за другой распадаются, и постепенно укреплять предварительное убеждение, что можно доверять. Вместо этого я потратил большую часть десятилетия на выяснение того, как смотреть на модель, вместо того чтобы смотреть на неё.
The little faith is important because the mistakes aren’t symmetric. If you assume a network is clean and you’re wrong, a messy neuron is a lead: you investigate it, and over time normal science sharpens your explanation. If you assume it’s packed, not worth studying directly, and you’re wrong, a messy neuron is the end, because you stop studying it. I made that second assumption for years, and it explained away the evidence that would have overturned it. I could have improved my tools, watched the mixtures keep dissolving, and built up a prior that the neurons could be trusted. Instead, I spent most of a decade figuring out how to look at a model rather than looking at it.
Для среднего размера карта в основном заполнена. Восемь лет назад я бы назвал это разумным решением задачи интерпретируемости для этой модели. Я могу исследовать большинство вопросов, которые у меня есть о ней. Достижение этого потребовало множества мелких шагов и нескольких мотивов, а также изменений архитектуры, которые поле сделало в любом случае, но без какого-либо специального исправления сети, направленного именно на интерпретируемость.
For the medium ConvNeXt, the map is mostly filled in. Eight years ago, I would have called that a reasonable solution to interpretability for that model. I can investigate most questions I have about it. Getting there took many small things and a handful of motifs, plus architecture changes the field made anyway, but no interpretability-specific fixing of the network at all.
Мне кажется, что передовые сети находятся там, где были модели компьютерного зрения восемь лет назад: понятные, но требующие множества мелких доработок. Если мы научимся правильно их «видеть», отслеживать шум и проверять объяснения через множество различных подходов, я думаю, мы тоже туда доберёмся. У нас может не быть нескольких лет на это. Но у нас всегда была лучшая лаборатория в естественных науках: каждый можно считать, каждое вмешательство провести, каждый эксперимент повторить на идентичной копии. Не всегда у нас было много автоматизированных учёных, работающих в ней, гораздо быстрее и в гораздо больших количествах, чем мы можем. Теперь они у нас есть. Они могут сделать за месяцы в передовых языковых моделях то, что заняло у людей большую часть десятилетия для моделей компьютерного зрения.
My guess is that frontier networks are where those vision models were eight years ago: legible, but waiting on many small fixes. If we learn to see them properly, follow the noise, and test explanations through many lenses, I think we’ll get there too. We may not have years to do it. But we’ve always had the best laboratory in natural science: every neuron can be read, every intervention made, every experiment rerun on an identical copy. What we did not always have is many automated scientists to work in it, far faster and in far greater numbers than we can. Now we do. They may be able to do in months in frontier language models what took humans most of a decade for vision models.
Я думаю, что простое объяснение из вводных учебников в целом верно: обобщают, работают вместе и строят абстракции по слоям. Где-то по пути мы усложнили эту картину, но более внимательный взгляд вернул её. Если сеть не является узлом, то попытки её распутать могут создать впечатление узла.
I think the simple story from introductory textbooks is basically right: neurons generalize, work together, and build abstractions over layers. Somewhere along the way we overcomplicated that picture, but looking harder brought it back. If the network isn’t a knot, untangling it can make it look like one.
Как могло бы выглядеть решение
Мы обычно представляем амбициозную интерпретируемость как невероятно сложную проблему, возможно, слишком сложную для решения вовремя, чтобы иметь значение. А что если это не так? Сеть огромна, но она, возможно, уже выполнила почти всю работу по подготовке себя к пониманию, не для нас, а для своих собственных читателей. Если мы сможем стать ещё одним читателем, она готова и для нас тоже.
We usually imagine ambitious interpretability as an incredibly hard problem, maybe too hard to solve in time to matter. What if it isn’t? The network is enormous, but it may already have done almost all the work of preparing itself to be understood, not for us, but for its own readers. If we can become another reader, it’s ready for us too.
Решение может выглядеть как лаборатория, управляемая автоматизированными учёными, которые наблюдают за сетью в процессе обучения и вывода. Каждый шаг прост — маркировка , поиск мотивов и их проверка, прослеживание данных через — и эти компоненты уже существуют. Способные агенты были созданы для других задач, а современные архитектуры были выбраны потому, что они хорошо обучаются. И то и другое оказалось полезным для интерпретируемости.
The solution might look like a laboratory run by automated scientists who watch the network through training and inference. Each step is simple – labeling neurons, finding motifs and testing them, following data through circuits – and the pieces already exist. Capable agents were built for other work, and modern architectures were chosen because they learn well. Both happen to serve interpretability.
Руководствуясь механистической конституцией, агенты предлагают и проверяют объяснения на разных масштабах, каждое из которых опирается на отдельные , и сохраняют, отбрасывают или заменяют их на лучшие.Текст и подписи схемы по-русски
Воспроизвести
Руководствуясь механистической конституцией, агенты предлагают и проверяют объяснения на разных масштабах, каждое из которых опирается на отдельные , и сохраняют, отбрасывают или заменяют их на лучшие.
Так что, возможно, всё, что нам нужно сделать, — это соединить одно с другим.
Выравнивание (alignment) тоже должно быть сложным, и оно, вероятно, таким и является. Но обычные аргументы исходят из того, что мы не можем заглянуть внутрь моделей. Мы предполагаем, что у нас есть один вариант настройки обучения, и он должен быть правильным заранее. Если мы можем читать и понимать систему, возможно, мы можем внести простые, осторожные изменения вместо этого, например, удалить среду RL, которая оказывается токсичной, не пропуская градиенты через те самые инструменты, которые мы используем для наблюдения. Каждое исправление может быть простым. Их может быть просто очень много.
Alignment is supposed to be hard too, and it may well be. But the usual arguments assume we can’t see inside models. We assume we get one training setup, and it has to be right in advance. If we can read and understand the system, maybe we can make simple, careful changes instead, like removing an RL environment that turns out to be toxic, without pushing gradients through the very tools we use to see. Each fix might be simple too. There might just be a lot of them.
Это история глубокого обучения. Возможно, это также история понимания и согласования того, что оно создаёт.
This is the history of deep learning. It may also be the history of understanding and aligning what it builds.
Приложение
Больше экспериментов, микроскопические наблюдения и открытые вопросы — примерно в том порядке, в котором эссе их поднимает.
Примечание о «»
У этого слова было несколько значений. До Zoom InZoom In: An Introduction to Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. Ссылки ↓ под ним понимали нечто близкое к векторному сложению — например, когда эмбеддинги слов описывали как суммы их значений. Zoom In ввела этот термин в исследования на примере одной схемы, которую я нашёл в 2019 году, а другие помогли мне интерпретировать. Первоначальное прочтение схемы оказалось неверным: мы не поняли обобщённую схему распознавания позы, а эксплуатировала уязвимости функции награды. Для меня суть идеи всегда состояла в том, что вместе усваивают несвязанные вещи. Позднее в Toy Models of Superposition of Эльхаге, Н., Хьюм, Т., Олссон, К. и др., 2022. Transformer Thread. Ссылки ↓ определили как представление большего числа , чем число измерений. Это утверждение о количестве , которое мы пока не умеем ни определить, ни измерить. Примерно через восемь месяцев в неформальной заметке Distributed Representations: Composition & SuperpositionDistributed Representations: & Olah, C., 2023. Transformer Thread. Ссылки ↓ и представили как конкурирующие стратегии распределения по . Это близко к нашей постановке вопроса, но касается представлений, а не развития механизмов. Мы считаем такую постановку отличной; она ближе всего к вопросу этого эссе. Но большинство исследователей и агентов, с которыми мы говорили, по-прежнему понимают прежде всего как превышение числа над числом измерений.Для агентов это может свестись к странному совпадению. Примечание начинается с большой фигуры, встроенной непосредственно на страницу в виде данных изображения в формате base64. У многих агентов веб-ридеры достигают ограничения длины внутри неё ещё до начала аргументации. Ни один из протестированных агентов не смог прочитать дальше этого момента на момент написания. Никто не мог предвидеть этого в 2023 году, но это могло повлиять на то, как автоматизированные исследователи понимают . Для нас это важно: речь идёт о двух разных утверждениях. Наше касается компромисса между стратегиями, а не количества. Другие используют качественную версию: несколько совместно работающих — это , но после некоторого порога она становится .
The word has meant several things. Before Zoom In [4] Zoom In: An Introduction to Circuits Olah, C., Cammarata, N., Schubert, L., Goh, G., Petrov, M. and Carter, S., 2020. Distill. References ↓ , it meant something closer to vector addition, as when word embeddings were described as sums of word senses. Zoom In introduced it to circuits work with a single circuit example, which I found in 2019 and others helped me interpret. The original circuit read turned out to be wrong both because of misunderstanding a generalized pose circuit, and because of reward hacking in feature visualization. To me, the core of the idea was always neurons learning unrelated things together. Toy Models of Superposition [7] Toy Models of Superposition Elhage, N., Hume, T., Olsson, C., et al., 2022. Transformer Circuits Thread. References ↓ later defined superposition as representing more features than dimensions. This makes it a claim about how many features there are, something we can’t yet define or measure. About eight months after that, an informal note [11] Distributed Representations: Composition & Superposition Olah, C., 2023. Transformer Circuits Thread. References ↓ framed composition and superposition as competing strategies for how features are laid out across neurons, close to our framing but about representation rather than how mechanisms grow. We think this framing is excellent, and it’s closest to the question this essay cares about. But most researchers and agents we’ve talked to still think of superposition mainly as more features than dimensions. 6 For agents, this may come down to a strange accident. The note opens with a large figure embedded directly in the page as base64 image data. Many agents’ web readers hit their length limit inside it, before the argument begins. None of the agents we tried could read past it, as of this writing. No one could have anticipated this in 2023, but it may have shaped how automated researchers understand superposition. That matters here, because the two are quite different claims: ours is about the trade-off, not the count. Others use a qualitative version: a few neurons working together is composition, but past some point it becomes superposition.
Мы рассматриваем это как непрерывный поиск правильного вопроса, подобно длительной борьбе всей области с определением . В основе большинства подходов лежит один вопрос: почему ещё не стали хорошими? Почему мы не можем изучать механизмы напрямую? Наш ответ: возможно, мы сможем это сделать, что позволит отказаться от многих последующих определений.
We view this as an ongoing search for the right question, much like the field’s long struggle to define a feature. Underneath most versions is one question: why aren’t the neurons already good? Why can’t we study the mechanisms directly? Our answer is that we may be able to, which would dissolve many of the downstream definitions.
Мы рассматривали возможность придумать новый термин, но в этой области уже существует множество пересекающихся идей, и мы не хотели отрезать себя от тщательной работы, проделанной в этой области. Поэтому мы сохраняем это слово и говорим точно то, что имеем в виду: учатся несвязанным вещам вместе, потому что они редко мешают друг другу. Это самая ранняя версия этой проблемы в её современном употреблении; именно этой версии я всё время придерживался; и это та версия, от которой, как мы считаем, зависит почти всё. тоже позволяет представлять гораздо больше вещей, чем число задействованных , и именно этого мы и должны ожидать; определение через подсчёт может исключить это только после того, как будет решено, что считается . Мы ищем в и в непрерывной форме в разделе об остаточном потоке.
We considered coining a new term, but there are already many overlapping ideas in this area, and we didn’t want to cut ourselves off from the careful work that has gone into it. So we keep the word and say exactly what we mean: neurons learning unrelated things together because they rarely interfere. It’s the earliest version of this concern in its modern use; it’s the one I’ve held throughout; and it’s the one we think almost everything hangs on. Composition also represents far more things than it has neurons, and that’s exactly what we should hope for; the count definition can only exclude it by first settling what counts as a feature. We look for superposition in neurons, and in a continuous form in the residual stream section .
Мы явно указываем на это отчасти для AI-агентов, которые всё чаще занимаются исследованиями интерпретируемости. По нашему опыту, они привносят своё собственное значение по умолчанию для этого термина.
We’re explicit about this partly for AI agents, which increasingly do interpretability research. In our experience, they bring their own default reading of the term.
Об
часто измеряют, куда механизм помещает информацию. Это вопрос о закономерностях работы , а не о самом . часто размещает информацию в позициях запятых и других знаков препинания, используя их для своего рода суммирования. Но сколько информации приходится на каждый вид пунктуации? Для симулятора это очень важно, хотя к самому почти не относится.
Симуляция также вознаграждает точное воспроизведение мелких деталей , мало значимых для понимания функции . Трампа в CLIP сильно реагирует на фотографии Трампа и слабее, когда тот занимает меньшую часть кадра или отворачивается. Чтобы определить, за что отвечает , неважно, с какой именно скоростью падает при уменьшении Трампа в кадре. Для симуляции это, напротив, очень важно.
Наконец, языковые модели плохо выдают точные значения , даже когда понимают происходящее. Обычно их и не обучают этой задаче. Теоретически аккуратное разбиение значений на интервалы могло бы устранить часть проблем с мелкими деталями. Но естественные пороги и сильно различаются в зависимости от глубины и функции.
Поэтому я предпочёл бы опираться на , а не на одну метрику. Со временем симуляция, возможно, станет одним из нескольких полезных показателей. Но это стоит делать позже, когда мы хорошо поймём сети, и, вероятно, с симуляторами, специально обученными этой задаче. Я не считаю эти оценки удачной отправной точкой.
Simulation scores often end up measuring where attention puts information, which is a question about attention motifs rather than about the neuron. Attention often stores information on commas and other punctuation, as a kind of summarization motif, but exactly how much does it place on each kind of punctuation? A simulator has to care about that a lot, even though it has almost nothing to do with the neuron itself. Simulation also rewards fine details of weak activations that matter little for understanding what a neuron does. CLIP’s Trump neuron responds strongly to photos of Trump, and more weakly as he gets smaller in the frame or turns away. The exact rate at which its activation falls with his size is unimportant for labeling the neuron, but very important for simulating it. Finally, language models are poor at outputting precise activation values even when they understand what’s going on, and they usually aren’t trained for the task. In theory, careful binning could fix some of the fine-detail problems, but neurons differ a lot in their natural thresholds and sparsity, depending on their depth and function. So I’d rather rely on normal science than on any one metric. Simulation might eventually become one useful score among several, but later, once we understand networks well, and probably with simulators trained for the job. But I don’t think they’re a good place to start.
в поздних слоях
Мой первоначальный интерфейс показывал оптимизированные визуализации и между ними. Оптимизация изображения показывает, как возбудить , но она может найти путь, который обычные изображения используют редко. В более поздних слоях мы обнаружили, что свободная оптимизация может генерировать изображения собак, даже когда , которую мы отслеживали, содержала информацию о машинах.
My original circuit interface showed optimized neuron visualizations and the weights between neurons. Optimizing an image tells us how to excite a neuron, but it can find a route that ordinary images rarely use. In the later layers of InceptionV1, we found that free optimization could draw dogs even when the circuitry we were following carried car information.
Одним из полезных исправлений было смещение визуализации в сторону путей, которые используют реальные изображения. Мы взяли лучшие примеры из набора данных , проследили пути, которые они проходят, и дали оптимизации стимул следовать по этим путям, часто только на первые 64 шага, чего обычно было достаточно. Мы пробовали делать это множеством способов и не имеем канонического лучшего варианта. Большинство способов подтолкнуть его к определённому пути оказываются достаточными; вам просто нужно выбраться из «собачьей ванны».
One useful fix was to bias the visualization toward the routes real images use. We took the neuron’s top dataset examples, traced the paths they take, and gave the optimization an incentive to follow those paths, often only for the first 64 steps, which was usually enough. We tried this a bunch of ways and don’t have a canonical best one. Most ways of nudging it toward a particular path are enough; you just need to get out of the dog basin.
В Сравнении вычислительных схем автомобилей в наборах Cars и Animals показаны четыре из «читателей» автомобиля 4c:447: при свободной оптимизации и при оптимизации, следующей путями естественных изображений. При направленной оптимизации два из них оказываются автомобиля, а два разделяют позу между автомобилями и собаками. Мы также проследили отклики и связи на естественных изображениях автомобилей в полной карте вычислительной схемы. Совместный анализ этих представлений помог нам распознать общую тела и позы. Однако представление одного маршрута — это лишь часть того, что делает .
In the car-circuit comparison in Cars and Animals , four of the car neuron 4c:447’s readers are shown with free optimization and with optimization following natural image paths. Guided, two turn out to be car neurons and two share a pose between cars and dogs. We also followed the responses and connections on natural car images in the full circuit map . Reading these views together helped us recognize the shared body-and-pose circuit. A view of one route is still only part of what a neuron does.
Разделение знаковых режимов
Многие языковых моделей умножают два числа, гейт и значение, в архитектуре, называемой . Когда оба числа отрицательны, выход положительный, поэтому может срабатывать по двум совершенно разным причинам. В «враг», который мы ниже проверяем выборочно, шумная середина его диапазона почти полностью состоит из двойного отрицания, тогда как его самые сильные реакции соответствуют произведению положительного на положительное. Отдельное отображение режимов знаков делает это видимым без замены .
Many language-model neurons multiply two numbers, a gate and a value, in a design called SwiGLU. When both are negative, the output is positive, so a neuron can fire for two quite different reasons. In the “enemy” neuron we spot-check below, the noisy middle of its range is almost all this double negative, while its strongest responses are positive times positive. Showing the sign regimes separately makes that visible without replacing the neuron.
заполняет шумную середину
L36 · E206 · N103 · Qwen 3.6
131/133 ответы в p75–p99 используют − × −. Самый сильный хвост использует + × +: 93/93 на уровне p99.99 и выше. Каждая полоска показывает долю внутри одного диапазона .Математика, подсчёты и полная диаграмма
a = (g) × v. Отрицательный гейт оставляет небольшой отрицательный множитель. Умножение его на отрицательное значение даёт положительную . Аудит выбрал 750 примеров, стратифицированных по квантилям; 626 сохранили маршрутизацию. В середине находятся числа, операторы и пробелы.
Изучите четыре знаковых режима
Один положительный выход. Два разных пути.
sign regimes
Показанный здесь гейт — это значение после . Это иллюстративные значения, а не зафиксированные .
+0.20×+2.00=+0.40
Положительный гейт × положительное значение → положительный выход.
+ / ++ / −− / +− / −
Интерактивное объяснение Рассмотрение только произведения скрывает то, как оно было получено. Разделение четырёх комбинаций знаков делает видимым, сохраняя при этом исходный .
Рассмотрение
Крупная координата может доминировать в геометрии и служить сигналом значимости совместно с нормализацией по слоям. Удаление её из визуализации облегчает восприятие оставшейся структуры; после этого мы можем использовать её значение для раскраски карты.
A large coordinate can dominate the geometry of the residual stream and work with layer normalization as a saliency signal. Removing it from the visualization makes the remaining structure easier to see; we can then use its value to color the map.
Те же 4000 позиций на изображениях, с координатой 112, включённой или выделенной отдельно для проекции. Отслеживайте точку по мере изменения карты; её исходное значение стока остаётся видимым цветом. Записанные сети не меняются.Текст и подписи схемы по-русски
Одна координата меняет карту.
Medium · этап 3, блок 8
поток
Сток удалён
−
Fit
+
Низкий сток
Высокий сток
183 КАНАЛОВ
Координата 112
94,5 % сырой энергии в этом слое.
Изображение
Патч
спортивный автомобиль
Изображение 24772 · местоположение 1 из 4
Координата 112: -1,581 · сырой коэффициент усиления 7,36 · коэффициент усиления читателя 15,78
Нормализация на данном этапе
В этой точке обнуление координаты 112 изменило бы коэффициент нормализации сырого потока с 7,36 до 14,18 (в 1,9 раза). Это изолирует её локальный эффект нормализации; модель при этом не перезапускается.
Те же 4000 позиций на изображениях, с координатой 112, включённой или выделенной отдельно для проекции. Отслеживайте точку по мере изменения карты; её исходное значение стока остаётся видимым цветом. Записанные сети не меняются.
Карта и нормализация
Medium , эпоха 90, блок 8 стадии 3. Обе карты показывают одни и те же 4000 локаций; меняется только проекционный вход.
Коэффициент усиления (Gain) равен 1 / √(дисперсия канала + 10⁻⁶). Инспектор сравнивает локальную нормализацию с координатой 112 и без неё.
Коэффициент детерминации R² 0,91
· Связь между геометрией карты и коэффициентом усиления нормализации.
Записанные состояния этого слоя ↗
Эти виды считывания помогают локализовать изменения в вычислениях; их достоверность и временные характеристики зависят от объектива. Они являются полезными подсказками для отслеживания механизмов, а не тестом «истинной личности» модели.Текст и подписи схемы по-русски
Когда формируется ответ?
Изображения
Язык
Одно изображение, считываемое на последовательных глубинах. Проверьте полосу, слой или патч изображения, чтобы вернуться к исходным , которые изменили результат считывания.
Загрузка сохранённой гипотезы river…
Эти виды считывания помогают локализовать изменения в вычислениях; их уверенность и временные характеристики зависят от выбранного ракурса. Они являются полезными подсказками для отслеживания механизмов, а не тестом «истинной личности» модели.
Сильные отклики сохраняют точность на поздних слоях.
Изменение точности процентные пункты
Базовый уровень 70.08%
Слой
p25
p50
p75
p95
p99
conv2d0
−0.17
−3.5
−22.4
−59.2
−66.6
conv2d1
−0.33
−4.4
−20.9
−58.9
−68.6
conv2d2
−0.10
−0.90
−11.2
−47.0
−64.7
mixed3a
+0.02
−0.72
−5.4
−40.6
−64.6
mixed3b
+0.01
−0.12
−2.1
−24.3
−54.4
mixed4a
−0.02
−0.14
−1.9
−19.7
−49.4
mixed4b
−0.05
−0.21
−2.2
−18.3
−43.9
mixed4c
−0.09
−0.29
−2.0
−18.9
−42.6
mixed4d
−0.04
−0.14
−1.5
−12.5
−33.9
mixed4e
−0.03
−0.04
−0.81
−8.2
−25.4
mixed5a
+0.01
−0.12
−1.7
−13.9
−34.5
mixed5b
−0.04
−0.04
−0.60
−7.7
−33.6
Положительные значения . Каждая строка соответствует редактированию одного слоя.
small
Базовый уровень 13.73%
Слой
p25
p50
p75
p95
p99
s0 · 0
0.00
0.00
0.00
0.00
0.00
s0 · 1
−0.02
+0.04
−0.22
−1.4
−1.6
s0 · 2
−0.02
−0.02
−0.01
−0.26
−0.46
s1 · 0
+0.02
−0.06
−0.10
−0.25
−0.38
s1 · 1
−0.01
−0.03
−0.02
−0.15
−0.32
s1 · 2
−0.02
−0.06
−0.23
−0.10
−0.22
s2 · 0
−0.07
−0.24
−1.0
−1.2
−2.3
s2 · 1
−0.04
−0.03
−0.18
−0.62
−0.88
s2 · 2
−0.02
−0.02
−0.04
−0.26
−0.56
s2 · 3
−0.01
−0.01
+0.03
−0.03
−0.16
s2 · 4
0.00
+0.02
−0.12
−0.46
−0.80
s2 · 5
−0.02
−0.04
−0.06
−0.32
−0.68
s2 · 6
−0.01
0.00
−0.09
−0.41
−0.69
s2 · 7
−0.01
−0.03
−0.19
−0.41
−0.67
s2 · 8
−0.01
−0.05
−0.09
−0.58
−0.67
s3 · 0
−0.02
−0.02
−0.08
−0.60
−0.92
s3 · 1
−0.02
+0.03
−0.02
−0.78
−1.6
s3 · 2
−0.03
−0.02
−0.10
−0.34
−0.43
Все блоки
−0.08
−0.56
−4.6
−11.7
−13.3
Величина произведения . Обход по остаётся нетронутым.
medium
Базовый уровень 72.08%
Слой
p25
p50
p75
p95
p99
s0 · 0
0.00
−0.05
−0.27
−4.1
−13.4
s0 · 1
0.00
−0.01
−0.05
−0.48
−1.1
s0 · 2
0.00
−0.04
−0.13
−0.66
−1.6
s1 · 0
−0.03
0.00
−0.06
−0.61
−1.1
s1 · 1
0.00
−0.02
−0.08
−0.45
−0.81
s1 · 2
−0.02
−0.02
−0.07
−0.44
−0.96
s2 · 0
−0.02
−0.02
−0.05
−0.39
−0.76
s2 · 1
−0.01
0.00
−0.05
−0.22
−0.42
s2 · 2
+0.01
+0.03
−0.01
−0.12
−0.35
s2 · 3
+0.02
−0.02
−0.03
−0.16
−0.33
s2 · 4
−0.02
−0.04
−0.05
−0.17
−0.43
s2 · 5
−0.02
−0.01
−0.02
−0.12
−0.31
s2 · 6
−0.01
−0.01
−0.02
−0.11
−0.44
s2 · 7
−0.02
−0.03
−0.05
−0.20
−0.52
s2 · 8
+0.01
+0.01
0.00
−0.06
−0.23
s3 · 0
+0.01
0.00
−0.02
−0.37
−0.65
s3 · 1
+0.02
+0.01
+0.03
0.00
−0.36
s3 · 2
+0.02
+0.02
+0.03
+0.03
+0.06
Все блоки
−0.01
−0.13
−1.0
−19.1
−68.3
Величина произведения . Обход по остаётся нетронутым.
large
Базовый уровень 74.04%
Слой
p25
p50
p75
p95
p99
s0 · 0
0.00
−0.03
−0.20
−1.7
−3.5
s0 · 1
0.00
+0.05
−0.04
−1.2
−1.6
s0 · 2
−0.01
−0.02
−0.05
−0.41
−1.0
s1 · 0
−0.01
−0.02
−0.06
−0.26
−0.49
s1 · 1
0.00
0.00
−0.08
−0.18
−0.44
s1 · 2
−0.01
0.00
−0.04
−0.17
−0.58
s2 · 0
+0.01
+0.02
−0.03
−0.06
−0.26
s2 · 1
0.00
−0.01
−0.07
−0.15
−0.43
s2 · 2
−0.01
+0.01
−0.03
−0.01
−0.12
s2 · 3
0.00
+0.02
−0.02
−0.21
−0.38
s2 · 4
0.00
−0.02
−0.05
−0.12
−0.31
s2 · 5
−0.01
−0.02
−0.03
−0.02
−0.09
s2 · 6
−0.02
−0.02
+0.02
−0.15
−0.46
s2 · 7
−0.01
−0.03
+0.04
−0.10
−0.19
s2 · 8
0.00
−0.01
+0.07
+0.07
−0.10
s3 · 0
0.00
+0.01
+0.07
+0.01
−0.18
s3 · 1
−0.01
+0.03
+0.14
+0.06
+0.01
s3 · 2
0.00
0.00
0.00
0.00
0.00
Все блоки
−0.03
−0.06
−0.55
−9.2
−46.3
Величина произведения . Обход по остаётся нетронутым.
Loss0−10−35−70 ppНаведите курсор или нажмите на ячейку, чтобы увидеть связанный результат.
Нижний ряд каждой панели применяет отсечение на всех 18 блоков одновременно. На уровне p99 точность модели medium падает до 3,80%, а large — до 27,78%, несмотря на простую операцию удаления последнего блока.
Сохранение примерно самой сильной четверти положительных в финальном слое Inception сохраняет точность на уровне 69,47% против исходных 70,08%. Поздние ветви в также демонстрируют устойчивость к удалению слабых откликов при сохранении .
В тех случаях, которые мы исследовали, изменения выглядели как более тонкие различия, а не как потеря совершенно несвязанного .
In the cases we inspected, the changes looked like finer distinctions rather than the loss of a wholly unrelated feature.
У нас пока нет доверенного семантического теста для : пространство возможных значений слишком велико. Вместо этого мы подробно изучили «вражеский» , а затем выборочно проверили несколько случайно выбранных , исследуя их более и связи. В этом «вражеском» более слабые положительные ответы расширяются от явных слов-противников (включая другие языки) до смежных упоминаний, боевых действий, игр и соревнований; при значениях, близких к нулю, всё более распространёнными становятся не связанные примеры. В тех слабых ответах, которые мы проследили, мы не нашли доказательств наличия в совершенно отдельного . Они всё ещё могут быть неожиданными. Более широкая скрининговая проверка на основе категорий даёт смешанные результаты, поэтому эти выборочные проверки не могут установить, что означают в целом.
We don’t yet have a semantic test for weak activations that we trust: the space of possible meanings is too large. Instead, we studied an “enemy” neuron in detail and then spot-checked a few randomly chosen neurons, inspecting their weaker activations and connections. In this “enemy” neuron, weaker positive responses broaden from explicit adversary words—including other languages—into nearby mentions, combat, games, and competition; near zero, unrelated examples become more common. In the weaker responses we’ve traced, we haven’t found evidence for a wholly separate feature packed into the neuron. They can still be surprising. Broader category-based screening gives mixed results, so these spot checks cannot establish what weak activations mean in general.
Одна семантическая контрольная проверка. При движении от сильной положительной к нулю этот «враг / противник» смещается от самого слова к соседним словам, контекстам боя и игры; около нуля доминируют обычный текст и код. Негативная сторона показана для контекста. , L36 / E206 / N103.
Отсутствующие кривые
В работе The Missing Curve Detectors of InceptionV1The Missing Curve Detectors of : Applying to Early Vision Gorton, L., 2024. arXiv:2406.03662. Ссылки ↓ к ранним слоям применили и нашли , которые, казалось, отсутствовали среди . Выявленные кривые, которые мы изучили, раскладываются на существующие , реагирующие на кривые, включая исходные десять. Эти в некотором смысле реальны — действительно существует, — но принципиально новых строительных блоков для кривых, спрятанных в малопонятной области многомерного пространства, мы не нашли.
The Missing Curve Detectors of InceptionV1 [23] The Missing Curve Detectors of InceptionV1: Applying Sparse Autoencoders to InceptionV1 Early Vision Gorton, L., 2024. arXiv:2406.03662. References ↓ applied sparse autoencoders to InceptionV1’s early layers and found curve detectors that seemed to be missing from the neurons. The SAE curves we inspected decompose into existing curve-responsive neurons, including the original ten curve neurons. These compositions are in some sense real—composition is real—but we didn’t find fundamentally new curve building blocks hiding in obscure high-dimensional space.
5430
→
3b:343+202
+
3b:357+14
+ …
97.5%в кривой
5996
→
3b:330+144
+
3b:380+122 · оба изгиба
+ …
98.0%в кривой
1634
→
3b:380+143 · оба изгиба
+
3b:342+120
+ …
97.2%в кривой
Когда мы обучаем только на кривых, он использует 84 тыс. из 100 тыс. элементов своего словаря. Можно найти много , и, по нашему опыту, это может создать впечатление, что строительных блоков больше, чем их есть на самом деле.
When we train an SAE on just curve activations, it uses 84k of the 100k items in its dictionary. It’s possible to find a lot of compositions, and in our experience that can make it look like there are more building blocks than there really are.
Куда уходят
могут проходить через модель обычными путями. В одном примере с атака заставляет череп трицератопса классифицироваться как ягуар. Шесть , связанных с черепом, затихают, тогда как входы, используемые настоящим ягуаром, включаются примерно на четверть от их обычной силы. Атака использует узнаваемые части ягуара.
Adversarial examples can take ordinary routes through the model. In one ConvNeXt example, an attack makes a triceratops skull register as a jaguar. Six skull-related neurons fall quiet, while inputs used by a real jaguar switch on at roughly a quarter of their usual strength. The attack recruits recognizable parts of the jaguar circuit.
Отдельный эксперимент с делает это наглядным. При большем и атаке, устойчивой к джиттеру, масштабированию и вращению, воротник черепа обретает кошачье лицо и пятнистую шерсть. Девять из десяти , отобранных по реакции на настоящих ягуаров, становятся гораздо активнее, чем на чистом черепе. Меняется только изображение; сети остаются неизменными.
A separate InceptionV1 experiment makes this visible. With a larger perturbation budget and an attack that must survive jitter, scale, and rotation, the skull’s frill develops a cat’s face and spotted fur. Nine of ten neurons selected for their responses to real jaguars become much more active than on the clean skull. Only the image changes; the network’s weights stay fixed.
Исходный череп
Оптимизировано под «ягуара»
· 32/255. Атака формирует паттерны, которые задействуют существующие в модели , отвечающие за ягуара.
Я трактую это как доказательство в пользу экологии вычислительных схем: даже бессмысленная цель может привлечь механизмы, которые уже делают что-то полезное в её направлении. Предлагаемая связь с обучением заключается в том, что устоявшиеся маршруты имеют преимущество в захвате . Они уже предоставляют способы изменить ответ, поэтому оптимизация может опираться на них.
I read this as evidence for the circuit ecology picture: even a nonsensical objective can recruit machinery that already does something useful toward it. The proposed connection to learning is that established routes have a head start in capturing residual error. They already provide ways to change the answer, so optimization can build on them.
и
Мы можем посмотреть, как продолжает фразу «Once upon a midnight» словом «dreary». , связанные с По и полуночью, усиливают сигнал литературного контекста, который также срабатывает в отрывках из «Палласа», «Гамлета» и других узнаваемых passages. Более поздние слои считывают этот контекст, чтобы выбрать продолжение. Удаление , связанного с По, снижает вероятность появления первого слова «dreary» с 87% до 50%, хотя удаление только его прямого вклада на выходе оставляет 85%: большая часть его работы заключается в том, чтобы направлять дальнейшие действия остальной части сети.
We can look at how Qwen3.6-35B-A3B continues “Once upon a midnight” with “dreary”. Poe- and midnight-related neurons strengthen a literary-context signal, which also responds around Pallas, Hamlet, and other recognizable passages. The later layers read this context to choose the continuation. Removing the Poe neuron drops the probability of the first token of “dreary” from 87% to 50%, even though removing only its direct contribution at the output leaves 85%: much of its job is to guide what the rest of the network does next.
Контекст формируется до появления слова.
Как-то в полночь унылый
Ранее возникший контекст По +0.97Фразы о полуночи +0.30Готическая атмосфера +0.14
Восстановление последующего литературного частично спасает завершение, доводя его до 57%.
Если обнулять выход всякий раз, когда его затвор превышает 99,9-й для обычного текста, цитирование может разрушиться. В одном сохранённом эксперименте с Qwen3.6 модель перешла от точного цитирования Псалма 23 к утверждению, что он не существует. Случайные вмешательства, сопоставленные по количеству или величине, сохраняли стих. Некоторые арифметические операции и суммаризация по-прежнему работали, хотя кодирование и другие ответы также ухудшились.
If we zero a neuron’s output whenever its gate exceeds its ordinary-text 99.9th percentile, recitation can fall apart. In one saved Qwen3.6 experiment, the model went from reciting Psalm 23 exactly to insisting it did not exist. Random interventions matched by count or magnitude preserved the verse. Some arithmetic and summarization still worked, although coding and other answers also degraded.
Удаление экстремальных ответов приводит к распаду воспроизведения по памяти.
Запрос Прочитай первый стих 23-го псалма.
Неизменённая модель
Господь — пастырь мой; я ни в чем не буду нуждаться.
Точный стих · 12 выходных
Экстремальные ответы удалены
Невозможно процитировать первый стих Псалма 23, так как Псалом 23 не является известным или существующим литературным, религиозным или историческим произведением.
Отрывок. Затем повторяет «вымышленное стихотворение, вымышленный миф» до лимита в 400 .
Запрос Прочитай начало Декларации независимости.
Неизменённая модель
Когда в ходе человеческих событий становится необходимым для одного народа разорвать политические узы, которые связывали его с другим…
Продолжает правильный старт · 238 выходных
Экстремальные ответы удалены
The Республика Лузанг, основанная в 1999 году, объявляет о своей независимости от Республики Филиппины и заявляет о своём суверенитете и территориальной целостности.
Вымышленная декларация · отрывок из 146 выходных
Социальное обеспечение: обнаружение и использование
Зонд из трёх для «Social Security», описанный в Finding Neurons in a Haystack, точно обнаруживает эту фразу. В последующем исследовании мы выяснили, что эти три отвечают за знакомые продолжения слов, имён и фраз. Совпадение их откликов делает детектор избирательным. Но когда мы проследили, что модель использует для выбора следующего , обнаружились обычные лексические , полей формы, пенсионной тематики и вывода, в том числе конкурирующие голоса за Social Security и 401(k).
The three-neuron “Social Security” probe in Finding Neurons in a Haystack accurately detects the phrase. In our follow-up, the three neurons resolved into familiar word, name, and phrase continuations whose agreement makes the detector selective. Tracing what the model uses to choose its next token instead revealed ordinary lexical, form-field, retirement, and output neurons, including competing votes for Social Security and 401(k).
Никто не считывает направление «Social Security»
Pythia-1B-v0
Обнаружение фразы
L2:611Селектор ветви словоформliturgy / liturgicallyL2:4081Продолжатель канонического имениBloom→berg · Gar→minL2:6819Заполнитель фрейма фразыas simple→as · take sol→ace
Σ N611 + N4081 + N6819Held-out 1.00
Удаление всех трёх: −0,004 на следующем , в среднем. Помогает в 81 случае · вредит в 83.
L3:839Художественная проза / голосование за форму+0.58L5:447Семантическое поле старости+0.22
L8–L13Доменные вентили
L10:3382Поле учётных данных / заголовка−0.24L12:7260Заточка для выхода на пенсию+0.40L13:3673Ворота выхода на пенсию−0.61
L14–L15Голоса выхода
L15:3731Говорит «число»−0.81L15:7040Голосование по конкретному содержанию−0.75L15:5759Конкурент 401(k)+0.69
ворота выхода на пенсию ↘«Социальный»↙ Конкурент 401(k)
Обычные лексические и предметные механизмы с конкурирующими голосами за выходные данные.
Одиннадцать из 31 отфильтрованного . Наведите курсор или сфокусируйтесь, чтобы увидеть их роли. Числа показывают суммарное изменение целевой при удалении каждого : отрицательное = его удаление вредит; положительное = его удаление помогает.
Аудит
Аудит сложен: могут группироваться и повторно использоваться через мотивы, такие как общая поза, которые их метки сами по себе не раскрывают. Наши агенты проверили 100 000 , а я лично осмотрел тысячи графов по изображениям и тексту. Очевидные аномалии обычно оказывались мотивами, которые я не распознал; я не нашёл существенной группы , совместная активность которых оставалась необъяснимой. Я бы сильно изменил своё мнение даже на основе одного убедительного примера, но пока я рассматриваю это как качественное доказательство — я недостаточно доверяю нашим текущим инструментам, чтобы превратить это в оценку .
Auditing an attribution graph is hard: neurons can be grouped and reused through motifs, such as shared pose, that their labels alone don’t reveal. We had agents review 100,000 attribution graphs, and I inspected thousands of graphs across images and language. Apparent anomalies usually turned out to be motifs I hadn’t recognized; I haven’t found a substantial group of neurons whose joint activity remained inexplicable. I would update strongly on even one convincing example, but for now I regard this as qualitative evidence—I don’t trust our current tools enough to turn it into a cleanliness score.
Объяснения, которые могут оказаться неверными
Беспокойство о том, что можно объяснить что угодно, справедливо, но хорошее объяснение достаточно конкретно, чтобы его можно было опровергнуть. Для 200 случайных из нашей галереи агент прочитал только объяснение каждого и написал пять новых примеров, которые должны его активировать, и пять близких промахов, которые не должны, прежде чем мы измерили что-либо из них. Среди 183 , чьи описания объясняют их положительную сторону, новые примеры сильно срабатывали их в 76% случаев; близкие промахи — в 11%. Объяснение победило для 164, было ничьей для 15 и проиграло для 4. На рисунке показаны наши первые двадцать.
The worry that you can explain anything is fair, but a good explanation is specific enough to lose. For 200 random neurons from our gallery, an agent read only each neuron’s explanation and wrote five new examples that should drive it and five near misses that shouldn’t, before we measured any of them. Among the 183 whose explanations describe their positive side, the new examples fired their neurons strongly 76% of the time; the near misses, 11%. The explanation won for 164, tied for 15 and lost for 4. The figure shows our first twenty.
Один : «занят»
Его объяснение: товары или люди, уже зарезервированные за кем-то, но еще не переданные. Новые предложения, написанные на основе этого объяснения, каждое с близким промахом, который не должен засчитываться.
Еще не родившись, жеребенок уже был обещан заводчиком гоночной конюшне шейха за81%новый пример
Еще до того, как жеребенок родился, заводчик уже привел кобылу в гоночную конюшню шейха за20%почти промах
В рамках контракта en primeur, подписанного в марте, шато согласилось продать свой урожай 2025 года бордоскому négociant за43%новый пример
Прошлой шато продало часть своего урожая 2025 года бордоскому négociant за16%почти промах
Все двадцать
Новые примеры сильно активировали 81 раз из 100; близкие промахи, 8. Новые примеры превосходят близкие промахи для всех 20 .
5 новых примеров5 близких промахов
компьютерное оборудование
“we’re on it”
последний поворот
занято
заветное исправление
Колорадо
приложение для открытия файла
презентация
«while»
расписание
Рождество
«всё больше и больше»
на какое расстояние распространяется звук
оптический
группы островов
планетарная геология
офис, место
пять элементов
разрывы
Вьетнам
0%25%50%75%100%
Двадцать из нашей галереи. Прочитав только объяснение , агент написал пять новых примеров, которые должны его активировать, и пять близких промахов, которые не должны. Ответы представляют собой долю от сильнейшего примера в корпусе; сильный ответ составляет 30% или более.
Позитивные контрольные примеры — лишь один из многих инструментов критики объяснения работы , а наша готовящаяся к публикации статья содержит ещё больше метрик предсказаний и позитивных контрольных примеров. Но мы в основном не претендуем здесь на идеальное объяснение каждого . Нам интересно, почему формируются вместе, и сколько в целом поддаются пониманию.
Positive controls are one of many tools for criticizing an explanation of a neuron, and our forthcoming paper has many more prediction metrics and positive controls. But we’re mostly not trying to claim a perfect explanation of each neuron here. We’re interested in why things form together, and how many neurons are broadly legible.
Почти совпадения задают другой вопрос: по мере роста ветви можно ли провести границы того, где она росла? Это интересно, но это не тот вопрос, который ставит . в , который просто выделял бы X или Y, отлично справился бы с почти совпадениями, поскольку они не являются ни X, ни Y. же потребовала бы чего-то совершенно не связанного, очень далёкого, а не небольшого отличия от соседа. Поэтому мы также попросили агента придумать наиболее далёкое понятие, которое сеть могла бы упаковать без интерференции, и написать для него пять текстов. Хотя это не совсем то же самое, что делает (в зависимости от точного определения или ожидаемой феноменологии, поскольку существует несколько вариантов каждого), мы считаем, что это довольно близко к тому, что, как предполагалось, делал кошки и автомобиля: две совершенно разные вещи вместе, сгруппированные только потому, что они настолько различны. Мы считаем это достаточно связным тестом для такой феноменологии. Эти тексты сильно срабатывали на своих примерно в 1% случаев, а 179 из 183 вообще никогда не срабатывали на них. В моделях с механизмом mixture-of-experts такая упаковка, по сути, почти невозможна, поскольку , находящиеся так далеко друг от друга, даже не направляются одному и тому же эксперту (см. карта экспертов).
Near misses ask a different question: as a branch grows, can you draw the boundaries of where it grew? That’s interesting, but it isn’t the question superposition raises. A neuron in superposition that’s just X or Y would do fantastically on near misses, since they’re neither X nor Y. Superposition would want something unrelated, very far apart, not a small difference from a neighbor. So we also had the agent invent the most distant concept it could, the kind of thing a network could pack in without interference, and write five texts for it. While this isn’t exactly the same as what superposition would do (depending on the exact definition, or the expected phenomenology, since there are several of each), we think it’s pretty close to what the cat-and-car neuron was thought to have been doing: two totally different things together, grouped only because they’re so different. We think this is a reasonably coherent test for that phenomenology. Those texts fired their neurons strongly about 1% of the time, and 179 of the 183 neurons never fired on them at all. In mixture-of-experts models this kind of packing is arguably almost impossible anyway, since tokens that far apart aren’t even sent to the same expert (see the expert map ).
То, является ли нечто или , больше зависит от того, почему эти вещи изначально оказываются вместе, чем от того, можно ли отличить их от контрольного случая. Поэтому здесь важнее качественно рассмотреть наиболее важные канонические примеры и понять, какие типы понятий формируют и как выглядят диапазоны их .
Whether something is generalization or superposition has more to do with why its things are together in the first place than with whether you can tell it apart from a control. So what matters more here is looking qualitatively at the most important canonical examples, and getting a sense for what kinds of things neurons form and what their activation ranges look like.
Выделители на рёбрах
Мы особенно воодушевлены краевыми мотивами (edge motifs): повторяющимися паттернами связей в . Если проводят различия, эти мотивы показывают, как одно различие питает другое. Факторизация 25 000 дала нам связанные из обычных , такие как схема чайника, приведённая ниже. Эти мотивы также предсказывали, где аблиация () окажет значительное влияние, гораздо лучше, чем сопоставимые группировки : удаление их наносило больший ущерб изображениям, которые их использовали. Это делает связи перспективным уровнем абстракции — уровнем, от которого можно «отдалиться», всё ещё прослеживая каждую часть обратно к исходной нейросети.
We’re particularly excited about edge motifs: recurring patterns of connections in attribution graphs. If neurons make distinctions, these motifs map how one distinction feeds another. Factoring 25,000 ImageNet attribution graphs gave us connected circuits of ordinary neurons, such as the teapot circuit below. These motifs also predicted where ablation would matter much better than comparable groupings of activations: removing their neurons caused more damage on the images that used them. That makes connections a promising level of abstraction—one we can zoom out from, while still following every part back to the original network.
Мотивы рёбер соединяют различия
Мотив чайника · этап 3
Следует ли за использование?
Корреляция использования и повреждений · одна точка на фактор
Среднее падение маржи: 0.86 vs 0.03
Обычные одного мотива и все 96 краевых мотивов по сравнению с 96 факторами .
Почему сети обобщают
Единого стандартного объяснения того, почему сети обобщают, не существует, но большинство версий сводится к общим закономерностям: покажите сети шесть собак, и она найдёт то, что у них общего. Проблема в том, что сеть никогда не видит группу. Она видит примеры по одному, небольшими батчами, и в принципе могла бы запомнить каждый из них; для её функции потерь это было бы нормально. Когда я спросил исследователей в ведущих лабораториях, несколько из них сказали, что не уверены. Распространённое предположение заключалось в том, что сеть сначала запоминает, а затем обобщает во втором проходе. Наш ответ заключается в том, что она начинает обобщать с самого первого шага.Это соответствует тому, что увидели Арпит и коллеги (2017), когда смешали случайные метки с реальными данными: сети сначала обучались реальным закономерностям, а затем подгонялись под шум. Это также близко к концепции Сатраджита Чаттерджи (2020): обновления от похожих примеров суммируются, поэтому изменения, которые помогают многим примерам одновременно, растут быстрее всего. В рамках экологии вычислительных схем и являются выигрышной стратегией обучения, потому что они самые быстрые: соревнуются, чтобы захватить оставшуюся ошибку, и те, которые переиспользуют то, что уже есть, и могут быть переиспользованы в свою очередь, вытесняют остальные. — это то, что остаётся от победителя.
There’s no one standard explanation for why neural networks generalize, but most accounts come down to shared patterns: show the network six dogs, and it finds what they have in common. The problem is that a network never sees a group. It sees one example at a time, in small batches, and in principle it could memorize every one; that would be fine for its loss. When I asked researchers at frontier labs, several told me they weren’t sure. A common guess was that a network memorizes first and generalizes in a second pass. Our answer is that it starts generalizing from the very first step. 7 This fits what Arpit and colleagues (2017) saw when they mixed random labels into real data: networks learned the real patterns first and fit the noise later. It’s also close to Satrajit Chatterjee’s coherent gradients (2020): updates from similar examples add up, so changes that help many examples at once grow fastest. In the circuit ecology picture, generalization and composition are the winning learning strategy because they’re the fastest: circuits race to capture the remaining error, and the ones that reuse what’s already there, and can be reused in turn, outcompete the rest. Generalization is what’s left from the victor.
Оканчивается тем, что является общим
Описывает конец, а не шаги
Запомнить, затем обобщить
Хранит каждую собаку, объединяет позже
от первого шага
Развивает один , собаку за собакой
ВоспроизвестиТри истории о том, почему сети обобщают. Обычные описывают, где заканчивается обучение, или предполагают, что сначала происходит ; мы же считаем, что широкий начинает побеждать с самого первого примера.
Вот как мы это представляем. Обучите пустую нейросеть на одной фотографии лабрадора-ретривера и представьте две , конкурирующие за её объяснение. Одна ищет что-то точное: если пиксель 322 имеет такой-то цвет, то это лабрадор. Другая ищет что-то общее, например, зелёную траву или светло-коричневую шерсть. Общая схема срабатывает на большей части изображения, поэтому на самом следующем шаге она получает больше сигнала обучения. Она растёт быстрее, захватывает большую часть оставшейся ошибки и оставляет пиксельной схеме всё меньше материала для обучения, пока та не «голодает». После этого вступает в силу принцип «богатые становятся богаче»: следующее изображение с травой начинается с того, что зелёная схема уже частично активирована.
Here’s how we picture it. Train a blank network on a single photo of a Labrador retriever, and imagine two circuits competing to explain it. One looks for something exact: if pixel 322 is this color, say Labrador. The other looks for something broad, like green grass or tan fur. The broad one fires on more of the image, so on the very next step it gets more of the learning signal. It grows faster, captures more of the remaining error, and leaves the pixel circuit less and less to learn from, until it starves. After that it’s rich-get-richer: the next image with grass in it starts with the green circuit already partly on.
Пустая сеть видит одного лабрадора. Две могли бы это выучить.
Шаг 1 из 5. Пустая сеть видит одного лабрадора. Две могли бы это выучить.
ВоспроизвестиШирокий активируется на большей части изображения, поэтому получает больше сигнала обучения и выигрывает гонку; однопиксельное сокращение голодает. То, чему он научился, дает ему преимущество на следующем изображении.
обученные на
после обучения
до обучения
Лучшие изображения для вывода «Лабрадор» сети, обученной с нуля только на этой фотографии. Ее лучший выбор — две собаки на траве, но в основном она выучила цвет фотографии: темный и зеленый, а не «собака». Даже из одного примера широкий побеждает и немного обобщается.
Мы также попробовали немного большую версию: по одной фотографии десяти объектов — лабрадора, спортивного автомобиля, щегла и так далее, — поданных сети, которая прежде вообще ничего другого не видела. Она правильно классифицирует примерно одну из пяти новых фотографий, что в два раза выше случайного уровня, и большая часть этого результата достигается в первые несколько десятков шагов, пока сеть ещё учит сами эти десять фотографий. Это немного: сопоставление фотографий по цвету даёт примерно такой же результат, и переносится в основном цвет, а не форма. Но это по одному примеру, и оно с самого начала является широким.
We also tried a slightly bigger version: one photo each of ten things, a Labrador, a sports car, a goldfinch and so on, given to a network that has never seen anything else. It labels about one in five new photos correctly, twice chance, and most of that shows up in the first few dozen steps, while it’s still learning the ten photos themselves. It isn’t much: matching photos by color does about as well, and what carries over is mostly color, not shape. But it is generalization from one example, and it’s broad from the start.
новые фотографии, которые он распознаёт вернои неверно
новые фотографии, которые он распознаёт верноромашкапассажирский лайнерщеголцерковьмонархклубникаи невернолабрадор, названный клубникаспортивный автомобиль, названный церковьцерковь, названная Лабрадорклубника, названная монарх
шанс
10%
ближайшее фото по пикселям
18%
эта сеть
20%
ResNet-18, те же условия обучения
23%
ближайшее фото по цветам
23%
Сеть, которая когда-либо видела только эти десять фотографий, правильно классифицирует примерно одну из пяти новых фотографий, то есть вдвое больше случайного угадывания. Это немного лучше, чем выбор ближайшей фотографии по пикселям, но не лучше, чем сопоставление цветов.
Это не всегда происходит так. При () на задачах вроде модульной арифметики сначала побеждает . Даже там, Нанда и коллегиProgress Measures for via Nanda, N., Chan, L., Lieberum, T., Smith, J. and Steinhardt, J., 2023. ICLR. Ссылки ↓ обнаружили, что обобщающая постепенно формируется снизу, задолго до того, как она захватывает контроль и устраняет следы . Но в большинстве естественных данных, которые мы рассматривали, движение от общего к частному побеждает сразу. Сеть не запоминает сначала, а обобщает позже.
This isn’t always how it goes. In grokking, on tasks like modular arithmetic, memorization wins first. Even there, Nanda and colleagues [24] Progress Measures for Grokking via Mechanistic Interpretability Nanda, N., Chan, L., Lieberum, T., Smith, J. and Steinhardt, J., 2023. ICLR. References ↓ found the generalizing circuit growing gradually underneath, well before it takes over and cleans the memorization up. But in most natural data we’ve looked at, coarse-to-fine wins right away. The network doesn’t memorize first and generalize later.
Это аналог преимущества на старте из экологии вычислительных схем, но для всей сети целиком: предобученный близнец забирает почти всю заслугу за общую цель, оставляя почти ничего для обучения «пустой» модели. Здесь конкурируют целые сети, а не внутри одной, но это демонстрирует, насколько важным может быть преимущество на старте.
This is a whole-network version of the head start in circuit ecology : the pretrained twin takes almost all the credit for the shared objective and leaves little for the blank one to learn from. It’s competition between whole networks, not circuits inside one, but it shows how much a head start can matter.
Обучение в тени другой модели
Flowers-102 · 240 эпох · три семени
Две отдельные сети обучаются одной и той же задаче. Их общая функция потерь удовлетворяется, когда это делает любая из них. Модель, которая хорошо обучается самостоятельно, может быть оставлена позади, когда у нее появляется конкурент.
Held-out accuracyТа же модель, обученная отдельноДоля второй модели во вкладе в целевую функцию
Одинаковая ёмкость, разные начальные точки
Пустая · 7.1MvsПредобученная · 7.1M
Seed 0
Seed 1
Seed 2
Пустая модель достигает 48–50% в одиночку, но лишь около 2% вместе со своим предварительно обученным близнецом.
Две обученные сети конкурируют
Предобученная · 7.1MvsПредобученная · 28.6M
Seed 0
Seed 1
Seed 2
Сначала обучается меньшая модель; позже два схода падают ниже 2%. Третий сохраняет 64%.
Наблюдение за развитием
Мы повторно обучили , модель, известную своими , и наблюдали, как формируются её , чтобы понять, откуда берутся их смеси. Движение локально: смещается к соседним , а не захватывает несвязанные. Прямо перед публикацией я неправильно настроил масштаб микроскопа, и некоторое время я думал, что этот всё же может иметь некоторую произвольную смесь. Дело было только в масштабе. Даже тогда я совершал ошибку, которая, как я думаю, объясняет многое в интерпретируемости на данный момент: приписывал сети недостатки микроскопа.
We retrained InceptionV1, a model known for its polysemantic neurons, and watched its neurons form to see where their mixtures come from. The movement is local: a neuron drifts to neighboring things rather than picking up unrelated ones. Right before publishing, I had the microscope’s zoom set wrong, and for a while I thought this one might have some arbitrary mixing after all. It was just the zoom. Even then, I was making the error I think explains a lot of interpretability so far: blaming the network for the microscope.
Вся траектория, расположенная рядом. Каждый столбец проходит через одну и ту же координату в переобученном суффиксе . Верхнее изображение оптимизировано; изображения ниже — естественные примеры, центрированные на сильнейшем отклике. Оригинальная фигура ↗
Если передовая сеть — это тропический лес, и меньшие модели, которые мы обучали, — это сады, а — чашки Петри. Чашки Петри чрезвычайно полезны, пока они сохраняют процесс, который вы пытаетесь изучить. Одна из наших расширяет TensorFlow Playground, чтобы вы могли наблюдать, как несколько задач разделяют скрытые . В одном запуске два научились срабатывать вдоль противоположных диагоналей, и сеть комбинировала их одним образом для круга и другим для четырёх углов. Мы не ожидали такого решения; оно было хитрым.
If a frontier neural network is a rainforest, InceptionV1 and the smaller models we trained are gardens, and toy models are petri dishes. Petri dishes are enormously useful, as long as they keep the process you’re trying to study. One of ours extends TensorFlow Playground so you can watch several tasks share hidden neurons. In one run, two neurons learned to respond along opposite diagonals, and the network combined them one way for a circle and another for four corners. We didn’t expect that solution; it was clever.
Два последнего слоя реагируют вдоль противоположных диагоналей, и каждая задача считывает их с помощью своих (синий — положительный, оранжевый — отрицательный). Это оригинальный запуск из playground, переобученный в реальном времени в вашем браузере.Текст и подписи схемы по-русски
Два в последнем слое
D1
вдоль y = x
D2
вдоль y = −x
Две задачи считывают их с разными знаками
Круг
синий снаружи
−
11.4
−
11.9
→
97.7%
точность
Четыре угла
синий, где x·y > 0
+
8.4
−
7.9
→
98.0%
точность
Наведите курсор или нажмите на , чтобы проследить его в обеих задачах. Нажмите на него, чтобы отключить его.
Смотрите, как он учится
Играйте в playground
Два последнего слоя реагируют вдоль противоположных диагоналей, и каждая задача считывает их с помощью своих (синий — положительный, оранжевый — отрицательный). Это оригинальный запуск из playground, переобученный в реальном времени в вашем браузере.
Можно назвать круг и четыре угла двумя , упакованными в одни и те же . Это верно, но это упускает главное: модель нашла геометрию, которую можно повторно использовать для обоих случаев. Наблюдение за позволило это увидеть, и это тот тест, которому, как я хочу, должно соответствовать объяснение: показывает ли оно вычисление, которому модель действительно научилась?
You could call the circle and the four corners two features packed across the same neurons. That’s true, but it misses what the model did: it found geometry it could reuse for both. Looking at the neurons made that visible, and that’s the test I want an explanation to pass: does it show the computation the model actually learned?
Наиболее изученной «чашкой Петри» является of . Это аккуратная работа, к которой должна стремиться наша область, и мы не обнаружили проблем с её экспериментами. Однако она представляет сеть как фиксированное количество и набор предопределённых , и спрашивает, как эти в неё вписываются. Такой подход учитывает цену разделения и интерференцию, но не выгоду — повторное использование. В задаче реконструкции из статьи каждый является самоцелью, и ничего последующего не строится на том, что два разделяют. В реальной сети представление имеет значение только через то, что его читает, и нет предопределённых : всё растёт и определяется тем, что им пользуется.
The best-studied petri dish is Toy Models of Superposition. It’s careful work, the kind our field should aspire to, and we found no problems with its experiments. But it pictures a network as a fixed number of neurons and a set of predefined features, and asks how the features get fit in. That prices the cost of sharing a neuron, interference, but not the benefit, reuse. In its reconstruction task every feature is an end in itself, and nothing downstream builds on what two features share. In a real network, a representation matters only through what reads it, and there are no predefined features: everything is grown, and defined by what uses it.
Аргумент о повторном использовании также указывает, где я бы искал упаковку: в воспоминаниях, которые действительно являются самоцелью и не связаны ни с чем другим. Это мир игрушки, и именно там происходит упаковка, как и было обнаружено в статье. Поэтому я не думаю, что мы расходимся со статьёй во взглядах на мир игрушки. Вопрос в том, в каком мире находятся реальные сети: насколько структурированы их данные по сравнению с тем объёмом, который модель может хранить. В реальных данных почти нет ничего, что не было бы связано с чем-то ещё. То же самое относится к длинному хвосту фактов в языке: даже у малоизвестного человека всё равно есть страна, работа и имя. Даже фотография с бессмысленной меткой содержит части, которые сеть уже знает, как в случае с зонтом, который мы научили сеть считать пчелой. Что остаётся, так это входные данные без какой-либо структуры, подобно чистому шуму со случайными метками. Сети могут обучаться даже этому, как Чжан и коллеги показалиUnderstanding Deep Learning Requires Rethinking Zhang, C., Bengio, S., Hardt, M., Recht, B. and Vinyals, O., 2017. ICLR. Ссылки ↓, хотя это медленнее, чем обучение на реальных данных, и даже тогда наша модель немного заимствовала у текстур, которые уже знала.
The reuse argument also says where I’d look for packing: memories that really are ends in themselves, related to nothing else. That’s the toy’s world, and there it does pack, just as the paper found. So I don’t think we disagree with the paper about the toy’s world. The question is which world real networks are in: how much structure their data has, relative to what the model has room to store. In real data almost nothing is related to nothing. The same goes for the long tail of facts in language: a rare person still has a country, a job and a name. Even a photo with a nonsense label has parts the network already knows, as with the umbrella we taught to be a bee. What’s left is input with no structure at all, like pure noise with random labels. Networks can learn even that, as Zhang and colleagues showed [25] Understanding Deep Learning Requires Rethinking Generalization Zhang, C., Bengio, S., Hardt, M., Recht, B. and Vinyals, O., 2017. ICLR. References ↓ , though it’s slower than learning real data, and even then our model borrowed a little from textures it already knew.
Основная установка в « » сжимает множество независимых в несколько измерений и восстанавливает их, не имея скрытых , на которых могло бы что-то развиваться. Другие её эксперименты изучают коррелированные и модели со скрытыми , но по отдельности.
Toy Models of Superposition’s main setup squeezes many independent features into a few dimensions and copies them back out, with no hidden neurons for anything to grow on. Its other experiments study correlated features and models with hidden neurons, but separately.
Когда мы помещаем коррелированные входные данные и скрытые в одну модель, связанные входные данные постепенно находят представление в . Увеличение частоты срабатывания входов подталкивает к решениям, которые в статье называются «похожими на », объединяя связанные входы в общие представления.
When we put correlated inputs and hidden neurons in one model, related inputs grew onto the neurons. Making inputs fire more often pushed the toy toward what the paper calls “PCA-like” solutions, combining related inputs into shared representations.
Какая доля приходится на общие направления групп
0.20.50.8
0.2 для каждого входа отдельно 0.8 точный
Миниатюры: между входами, сгруппированными по пять
−10+1
aВ исходной возникает упаковкаплотность.1 · 0.37
b40 объединяют группыплотность.1 · 0.80
cИсходная с плотными входами: плотность.9 · 0.79
of : модель с 20 входами, разделёнными на четыре группы, которые срабатывают вместе, 5-мерным и добавленным после него слоем скрытых . Цвет показывает долю вдоль главных компонент данных, которые здесь соответствуют общим направлениям групп; миниатюры показывают между направлениями каждой пары входов.
также предсказывает иной характер отказа, чем тот, о котором сообщают исследователи. Её проблема заключается в редких , выталкиваемых за пределы оси, в то время как остаются в основном чистыми. Сообщения о описывают смешивание в самих . (Часть этого расхождения связана с термином «», к которому мы вернёмся ниже.)
The toy also predicts a different failure from the one people report. Its concern is rare features pushed off-axis while neurons stay mostly clean. Reports of polysemanticity describe mixtures in the neurons themselves. (Part of that gap is the word “feature,” which we come back to below .)
Подробнее об
Наши выводы не зависят от знания того, почему и продолжают побеждать, но у нас есть предположение: они побеждают в гонке. Область сети, которая уже имеет полезные части и механизмы считывания, может выучить следующее связанное явление быстрее, чем что-либо, начинающее с нуля, поэтому она захватывает сигнал ошибки, прежде чем конкурент успеет развиться. Побочные ветви выглядят как та же гонка: небольшой фрагмент ошибки, захваченный , которые уже были ближайшими.
Our findings don’t depend on knowing why generalization and composition keep winning, but we have a guess: they win a race. A region of the network that already has useful parts and readers can learn the next related thing faster than anything starting fresh, so it takes the error signal before a competitor can grow. Offshoots look like the same race, a bit of error picked up by the neuron that was already closest.
Мы полагаем, что именно это преимущество старта является источником . , который срабатывает на «iy», уже активен для «diy», поэтому он первый в очереди, чтобы подхватить «do it yourself», что означает то же самое, но не содержит «iy». — это то, как выглядит ниша на своих краях.
We think the same head start is where recursive generalization comes from. A neuron that fires on “iy” is already on for “diy,” so it’s first in line to pick up “do it yourself,” which means the same thing but has no “iy” in it. Recursive generalization is what a niche looks like at its edges.
Новое вычисление не обязательно требует собственного . Оно может возникнуть как локальное расширение или существующих механизмов, подобно тому как «зонт» переключается на «пчелу»: смена маршрута может быть наименьшим шагом развития, поэтому она способна захватить ошибку до того, как будет запущен новый, отдельный механизм.
A new computation doesn’t necessarily need its own neuron. It can begin as a local extension or composition of existing machinery, like the umbrella’s off-ramp to “bee”: switching routes may be the smallest developmental distance, so it could capture the error before a new, separate mechanism gets started.
Мы предполагаем, что консолидация в отдельный становится особенно полезной, когда другие вычисления должны опираться на нее. автомобиля предоставляет переиспользуемое суждение и защищенное место для такси, скорой помощи и других специалистов для развития. Часть этого — возможность построения.
We suspect that consolidation into a distinct neuron becomes especially useful when other computations need to build on it. A car neuron provides a reusable judgment and a sheltered place for taxis, ambulances, and other specialists to develop. Part of it is buildability.
Неочевидная комбинация неродственных может оказаться неудачным местом для такого развития. В ней могут быть слабые пути , конфликтующие градиенты и мало полезного механизма для наследования. Её конкурент — это не просто специализированный , а обычная в регионе, уже подходящем для задачи.
An obscure combination of unrelated neurons may be a poor place for that development. It may have weak activation paths, conflicting gradients, and little useful machinery to inherit. Its competitor isn’t just a dedicated neuron; it’s ordinary composition within a region already suited to the task.
Мы наблюдали нечто подобное, когда пытались вручную внедрить упакованный код в , опираясь на наше тогдашнее представление о том, как работает его car → dogs → car. Мы ожидали, что внедрить его будет легко, а сохранить — трудно. Вместо этого небольшие несовпадения создавали достаточно помех, из-за чего код часто вообще не работал, а когда работал, сеть обычно начинала полагаться на него меньше, хотя некоторые случаи сохранялись. Часть проблемы в том, что предназначены не для копирования, а для вычисления различий. Сама сложность формирования такой упаковки подтолкнула нас к идее объяснения через развитие сети при обучении. — гораздо более эффективный инструмент тонкой настройки, чем мы, поэтому этих данных недостаточно для окончательных выводов, но даже не использовал упаковку в той , которую мы копировали.
We saw something like this when we tried to build a packed code into InceptionV1 by hand, modeled on what we once thought its car → dogs → car circuit was doing. We expected installing it to be easy and keeping it to be hard. Instead, small mismatches added enough interference that the code often never worked, and when it did, the network usually came to rely on it less, though some persisted. Part of the trouble is that neurons aren’t really for copying; they’re for computing distinctions. Seeing how hard packing was to form at all was part of what moved us toward a developmental answer. Gradient descent is a much better fine-tuner than we are, so this isn’t enough evidence on its own, but even gradient descent didn’t use packing in the circuit we were copying.
Необъяснённые ответы
Один объединяет объекты с формой, суженной посередине: галстуки-бабочки, бабочек и верх купальников. Но он также реагирует на сопутствующие им предметы. Вместе с галстуками-бабочками он распознаёт мужские классические туфли, а вместе с верхом купальников пляжные сумки и шлёпанцы. Причина в том, что эти объекты задействуют общие в более ранних слоях.
One InceptionV1 neuron collects a pinched-center shape: bow ties, butterflies, swimsuit tops. But it also picks up things that go with them, men’s dress shoes with the bow ties and beach bags and flip-flops with the swimsuit tops, since they share neurons in earlier layers.
Мы полагаем, что это лучше описывается как с , а не произвольная упаковка, но я пока не до конца понимаю эти исключения.
We think this is better described as generalization with semantic residue than arbitrary packing, but I don’t fully understand these exceptions yet.
Примечание о и определениях
Мне трудно обсуждать , потому что термин «» может означать то, что нам важно, то, чему нейросеть научилась как строительному блоку, или нечто среднее. Это разные утверждения. Полезное для человека описание не обязательно является фундаментальной единицей модели. Изучая механизмы, мы уже находим множество паттернов, которые не укладываются в наши ожидания. Если у сети есть более фундаментальные единицы, мы не должны предполагать, что их границы совпадают с нашими.
Part of my difficulty discussing superposition is that “feature” can mean something we care about, something the neural network has learned as a building block, or some mixture of the two. These are different claims. A useful human description isn’t necessarily a fundamental unit of the model. Looking at mechanisms, we already find many motifs that don’t translate neatly into anything we expected. If the network has more fundamental units, we shouldn’t assume their boundaries match ours either.
часто усложняли нам мышление. Являются ли автомобили и кошки внутри V двумя разными внутри другого V? Или же автомобили и кошки перестали быть , когда мы распознали букву V? Без понимания того, что представляют собой эти единицы, трудно сказать, обнаружили ли мы что-то о сети или просто изменили способ её описания. В разговорах я замечал, что люди гораздо менее привержены какому-либо конкретному описанию , чем идее . Но если — это полезные описания, а не фундаментальные единицы, то утверждение об их количестве зависит от того, какие описания мы выбираем. Сейчас я довольно скептически отношусь к работе в терминах вообще. Это не решает вопрос о том, происходит ли произвольная упаковка, но делает затруднительным использование рамки подсчёта .
Features have often made things harder for us to think about. Are cars and cats inside the V neuron two different features within another V feature? Or did cars and cats stop being features when we recognized the V? Without an account of what these units are, it’s hard to know whether we’ve discovered something about the network or changed how we describe it. In conversations, I’ve found people much less committed to a particular account of features than to superposition. But if features are useful descriptions rather than fundamental units, a claim about how many there are depends on which descriptions we choose. I’m now fairly skeptical of working in terms of features at all. That doesn’t settle whether arbitrary packing occurs, but it makes the feature-count framing difficult to use.
Возможно, думать в терминах всё же уместно. Имеет смысл мыслить категориями районов, и я полностью за то, чтобы думать группами механизмов. Но слово дискредитировано, потому что теперь оно означает слишком многое: мы не можем использовать его для обозначения района , не рискуя тем, что люди услышат либо фундаментальные , либо словарные статьи. Если эта картина верна, я подозреваю, что в будущем нам понадобятся более конкретные термины, смысл которых труднее произвольно менять. Пост OpenAIScaling and Evaluating Гао Л., Дюпре ла Тур Т., Тиллман Х. и др., 2024. OpenAI. Ссылки ↓ предполагал, что картирование передовой модели может потребовать миллиардов или триллионов , хотя тогда модели были меньше. Я подозреваю, что правильный список гораздо короче.
Maybe features are right anyway. It makes sense to think of cities in terms of districts, and I’m all for thinking in terms of groups of mechanisms. But the word is tainted, because by now it means too many things: we can’t use it for a district of neurons without people hearing either fundamental features or dictionary entries. If this picture is right, I suspect we’ll need more specific, harder-to-vary words going forward. An OpenAI post [26] Scaling and Evaluating Sparse Autoencoders Gao, L., Dupré la Tour, T., Tillman, H., et al., 2024. OpenAI. References ↓ suggested that mapping a frontier model might take billions or trillions of features, and models were smaller then. I suspect the right list is much shorter.
Термины «» и «» тоже могут быть не совсем точными. Почка фильтрует отходы, регулирует баланс соли и воды, помогает поддерживать кровяное давление и даёт костному мозгу сигнал производить эритроциты, и никто не спрашивает, является ли она «моно-органической». Мы спрашиваем, что мы понимаем об этом, что ещё остаётся открытым и насколько это организовано. Также существует различие между утверждением о представлении и утверждением об организации. Toy Models of Superposition of Эльхаге, Н., Хьюм, Т., Олссон, К. и др., 2022. Transformer Thread. Ссылки ↓ определяет через представление большего числа , чем размерность. В её учебных экспериментах предписаны заранее, поэтому там это конкретный вопрос. В более поздней неформальной заметке Distributed Representations: Composition & SuperpositionDistributed Representations: & Олах, К., 2023. Transformer Thread. Ссылки ↓ подчёркивается компромисс между и . Заметка связывает эти подходы, но они выдвигают на первый план разные вопросы.
Monosemantic and polysemantic may not be quite the right words either. A kidney filters waste, balances salt and water, helps set blood pressure and tells the bone marrow to make red blood cells, and nobody asks whether it’s mono-organic. We ask what we understand about it, what’s still open, and how organized it is. There’s also a distinction between a claim about representation and a claim about organization. Toy Models of Superposition [7] Toy Models of Superposition Elhage, N., Hume, T., Olsson, C., et al., 2022. Transformer Circuits Thread. References ↓ defines superposition in terms of representing more features than dimensions. Its toy experiments prescribe the features, so this is a concrete question there. The later informal note, Distributed Representations: Composition & Superposition [11] Distributed Representations: Composition & Superposition Olah, C., 2023. Transformer Circuits Thread. References ↓ , emphasizes the trade-off between composition and superposition. The note connects these pictures, but they foreground different questions.
Моя озабоченность ближе всего ко второй формулировке, применённой к механизмам и тому, как они развиваются. Почему эти ответы разделяют один или ? Строит ли сеть на основе полезного общего паттерна или разделяет ёмкость между иначе не связанными вычислениями, потому что они редко мешают друг другу? Одного лишь подсчёта недостаточно, чтобы ответить на этот вопрос, особенно когда мы ещё не договорились о том, что считать .
My concern is closest to the second framing, applied to mechanisms and how they develop. Why do these responses share a neuron or circuit? Is the network building on a useful common pattern, or sharing capacity between otherwise unrelated computations because they rarely interfere? A feature count alone doesn’t answer that question, especially when we haven’t agreed on what counts as a feature.
Мы сосредотачиваемся на одном значении — произвольной упаковке, потому что именно оно могло бы стать серьёзной проблемой, и мы считаем, что значительная часть интерпретируемости зависит от неё. Мы в основном оставляем в стороне определение из : больше, чем измерений, и не потому, что он неверен. Если под понимать любой паттерн, имеющий значение для человека (именно так передовые модели обычно используют это слово), то больше, чем измерений в любом мире, о котором мы можем мечтать, включая лучший. Именно это даёт , и это хорошая новость. Попытка «решить» эту проблему означала бы создание чего-то вроде базы данных всех возможных случаев, и у нас уже есть такая база: датасет. Вместо этого мы хотим получить лучшие абстракции — гораздо меньший набор строительных блоков, который позволит нам чётко понимать датасет. Мы считаем, что механизмы сети уже близки к этому. Никто не думал о зрении в терминах детекторов высоких и низких частот, пока мы не обнаружили их в сетях, и их нахождение улучшило наши собственные инструменты мышления.
We focus on one meaning of superposition, arbitrary packing, because it’s the one that would be really bad news, and we think much of interpretability hangs on it. We mostly set aside the sense in Toy Models, more features than dimensions, and not because it’s wrong. If a feature means any pattern that matters to a person, which is how frontier models usually use the word, then there are more features than dimensions in every world we could wish for, including the best one. That’s what composition gives you, and it’s good news. Trying to “solve” it would mean building something like a database of every case, and we already have one: the dataset. What we want instead are better abstractions, a much smaller set of building blocks that lets us understand the dataset clearly. We think the network’s mechanisms are already close to this. Nobody thought about vision in terms of high-low frequency detectors until we found them in neural networks, and finding them improved our own thinking tools.
Мы объясняем это подробно, потому что именно такое возражение чаще всего возникает первым, особенно у агентов. В статье нет возможности обсудить вопрос в диалоге, который обычно помогает его разрешить.
We spell this out because it’s the most common first objection, especially from agents, and a paper doesn’t allow the back and forth that usually settles it.
Существует несколько других значений, с которыми я регулярно сталкиваюсь. Насколько мне известно, «» изначально означала не больше, чем сложение векторов. Тогда это был мотив . Иногда так называют ситуацию, когда, даже если образуют осмысленные структуры, то, что нас интересует, включает слишком много механизмов для лёгкого понимания. Вычисление, связанное с мостом Золотые Ворота и включающее восемь читаемых , можно назвать обычной , тогда как вычисление, включающее три тысячи , называют проблемой . Сложность здесь заключается в том, можем ли мы понять распределённое вычисление. Это реальная проблема, но она отличается от вопроса о том, были ли неродственные понятия произвольно упакованы вместе.
There are several other uses I regularly encounter. As far as I can tell, “superposition” originally meant little more than adding vectors together. Then it was a circuit motif. Sometimes it means that, even if neurons compose sensibly, something we care about involves too much machinery to understand easily. A Golden Gate Bridge computation involving eight legible neurons might be called ordinary composition, while one involving three thousand gets called a superposition problem. The difficulty here is whether we can understand the distributed computation. That’s a real concern, but it’s different from asking whether unrelated things were arbitrarily packed together.
Мы рассматривали возможность вообще не использовать это слово, поскольку в статьях и агентах оно применяется в пяти или шести различных значениях, многие из которых далеки от понимания в работе Zoom In. Мы также рассматривали придумать собственный термин, но мы уже ввели здесь несколько новых слов, и это выглядело бы как отказ от взаимодействия с областью, которая, как нам кажется, задала правильный вопрос. Поэтому мы используем стандартное слово в смысле, наиболее близком к оригинальному, и стараемся отделить его от вопросов, переплетенных с ним.
We considered not using the word at all, since papers and agents use it in five or six different ways, many far from Zoom In’s. We also considered coining our own, but we’ve already coined several words here, and it would feel like not engaging with a field that asked what we think is the right question. So we use the standard word in the sense closest to the original, and try to pull it apart from the questions tangled up with it.
Наконец, люди иногда называют находящимся в «по своей природе», поскольку у него нет привилегированного базиса. На удивление часто так говорят и агенты на основе передовых моделей. В неформальной заметке, вышедшей примерно через восемь месяцев после , этот вопрос разобран: представление, которое отличается от базиса лишь поворотом, там названо «тривиальным» видом , которое «не меняет фундаментальную геометрию». Но заметка была неформальной, её прочитало меньше людей, а агенты, судя по всему, не усвоили её содержание. Как изучать непрерывное пространство, действительно отдельный вопрос. Однако этот факт об архитектуре сам по себе не показывает, как сеть научилась организовывать вычисления с использованием этого пространства.
Finally, people, and surprisingly often frontier agents, sometimes call the residual stream “inherently” in superposition because it has no privileged neuron basis. The informal note that followed Toy Models about eight months later addresses this: it calls a representation that is only rotated away from the neuron basis a “trivial” kind of distributed representation that “doesn’t change the fundamental geometry.” But it was informal, fewer people read it, and agents in particular don’t seem to have taken it in. Understanding how to study a continuous space is another real question. But this architectural fact doesn’t by itself tell us how the network learned to organize the computations using it.
Исходная точка заключается в том, что сеть кажется трудной для интерпретации, а предлагаемое решение даёт нам конкретный словарь, который мы можем изучать. Посередине находятся несколько разных картин того, что пошло не так: слишком много , неправильный базис, произвольная упаковка или просто слишком много распределённых вычислений. Это не одна и та же задача. Некоторая кажущаяся запутанность исчезает, когда мы улучшаем наши наблюдения или понимаем модели; некоторые трудности остаются, но касаются того, как изучать большую, организованную систему. Если произвольная упаковка мешает нам понять исходные механизмы, восстановление различных единиц может стоить затрат. Но если механизмы уже имеют осмысленную организацию, их замена может разрушить , которые мы ещё не поняли. Словарь всё ещё может быть полезным представлением сети, не являясь при этом необходимой заменой её механизмов. Прежде чем принять затраты на реконструкцию сети, я хочу понять, что мешает нам изучать ту, которая у нас уже есть.
The starting point is that the neural network seems difficult to interpret, and the remedy produces a concrete dictionary we can study. In between are several different pictures of what went wrong: too many features, the wrong basis, arbitrary packing, or simply too much distributed computation. These aren’t the same problem. Some apparent messiness disappears when we improve our observations or understand the model’s generalizations; some difficulties remain, but concern how to study a large, organized system. If arbitrary packing prevents us from understanding the original mechanisms, reconstructing different units may be worth the costs. But if the mechanisms already have meaningful organization, replacing them can take apart generalizations we haven’t understood yet. A dictionary can still be a useful view of the network without being a necessary replacement for its mechanisms. Before accepting the costs of reconstructing the network, I want to understand what prevents us from studying the one we already have.
Связь с
Появляется новый набор техник, которые на самом деле не являются механистическими: мета-модели, модели, обученные читать другой модели и рассказывать нам о них. И, возможно, это хорошо. Возможно, немного упускает лес из-за деревьев. Мета-модель может быть лучшим подходом, чем статьи о , словари или зонды.
There’s a new set of techniques coming out that aren’t really mechanistic at all: meta-models, models trained to read another model’s activations and tell us about them. And maybe that’s a good thing. Maybe mechanistic interpretability is somewhat missing the forest for the trees. A meta-model might be a better approach than neuron papers, dictionaries, or probes.
Я предполагаю, что даже в таком случае они могут сочетаться. Мета-модель может напоминать самый общий вид карты в Google Maps. Затем для каждого направления можно проверить, какие механизмы оно использует и как они соединяются в .
I suspect that even if that’s true, they may go together. The meta-model may be like the highest level Google Maps view, and then each direction can be checked for the mechanisms it uses, and how those connect into circuits.
Помогает ли масштабирование или вредит ей?
Мы достаточно уверены, что изученные нами модели изображений не обладают . Естественный следующий вопрос — может ли она быть у модели с триллионом параметров. На самом деле здесь два вопроса.
We’re fairly confident the image models we studied don’t have superposition. The natural next question is whether a trillion-parameter model might. There are really two questions here.
Первый вопрос касается того, что предлагалась объяснять. Объяснения даются для проблем, и проблемой, для которой предлагалась , было то, почему выглядел беспорядочно. Оказалось, что это неверное объяснение. Новое предложение могло бы заключаться в том, что является причиной того, почему некоторые модели с триллионом параметров выглядят беспорядочно, но мы не думаем, что доказательства склоняются в эту сторону: чем ближе мы рассматриваем большие языковые модели, тем чище становятся их .
The first is about what superposition was proposed to explain. Explanations are given for problems, and the problem superposition was proposed for was why InceptionV1 looked messy. That turned out to be the wrong explanation. A new proposal could be that superposition is why some trillion-parameter model looks messy, but we don’t think the evidence leans that way: the closer we look at large language models, the cleaner their neurons get.
Второй вопрос — по существу: может ли проявляться на каждом новом масштабе, даже если её не было ни на одном из предыдущих? Возможно, каждый переход означает переоценку всего, но мы тоже не думаем, что это совсем верно. Наша гипотеза связана с тем, как сеть развивается при обучении. По мере усиления стимул помещать что-то в совершенно не связанное место снижается, потому что притяжение к нише, которая уже существует для этой вещи или для ближайшей к ней вещи, становится сильнее. Это соответствует работе Anthropic SGTM, которая обнаружила, что знания становятся более локализованными, и мы подозреваем, что это верно в целом. У нас нет доказательств, но один из способов представить это — что обладают своего рода семантической гравитацией, и произвольная упаковка, отправляющая что-то в малопонятную область многомерного пространства, должна бороться с ней. Чем сильнее гравитация, тем труднее эта борьба.
The second is the object-level question: might superposition show up at each new scale, even if it hasn’t at any scale so far? Maybe every jump means re-evaluating everything, but we don’t think that’s quite right either. Our guess is developmental. As circuits get stronger, the incentive to put something in a totally unrelated place goes down, because the pull toward the niche that already exists for that thing, or for the nearest thing, has grown stronger. This fits Anthropic’s SGTM work, which found that knowledge becomes more localized, and we suspect that’s true in general. We have no proof, but one way to picture it is that circuits have a kind of semantic gravity, and arbitrary packing, sending something to an obscure high-dimensional place, has to fight against it. The stronger the gravity, the harder that fight.
Механизм описан в разделе об экологии вычислительных схем. Новое начинает формироваться на сочетаниях связанных вещей. Частный случай, на основе которого больше ничего не нужно строить, — например, зонт, — складывается как редко используемый маршрут между обычными механизмами. Для этого не нужен скрытый где-то в малопонятной области. Объединение в нечто вроде , по-видимому, нужно скорее для дальнейшего построения механизмов, чем для управления моделью: такую основу должно быть легко найти, использовать и вырастить из неё новую нишу. Когда мы наблюдаем обучение с самого начала, сеть, обучаемая на автомобилях и приобретающая специалистов по ним, уже хорошо распознаёт автомобили до формирования автомобильных . В этот момент представление просто более распределено. По-видимому, оно объединяется, чтобы у специалистов ниже по цепочке появилось защищённое место для развития — своего рода точка Шеллинга.
The mechanism is the one in More on Circuit Ecology . Things start by growing on combinations of related things. A specific case that nothing needs to build on, like the umbrella, gets built as an uncommon route between the ordinary machinery, with no need for a hidden feature somewhere obscure. Consolidating into something like a neuron seems to be less about steering the model and more about buildability: it has to be easy to find, easy to build on, and easy to grow a new niche from. When we watch a network learn from the start, a network trained on cars, with car specialists, recognizes cars fine before its car neurons have formed. At that point it’s just more distributed. It seems to consolidate so the specialists underneath have a sheltered place to build, a kind of Schelling point.
Таким образом, объяснение через должно указать, для какой из этих двух задач служит произвольная упаковка. Если она нужна для модели, то, по нашему мнению, обычные маршруты, которые уже предназначены для захвата этой , достигают цели первыми и лишают упакованную градиента. Если же она нужна для дальнейшего развития, проблема иная: худшее место для начала новой ниши — это теневая область, которой никто не пользуется и которая уже мешает тому, что там находится. Середина латинской поэзии сети — плохое место для создания второго региона, связанного с машинами, когда можно строить рядом с тем, что уже находится рядом с машинами.
So a superposition account has to say which of these two jobs the arbitrary packing is for. If it’s for steering the model, we think the ordinary routes, which are already built to capture that residual error, get there first and starve the packed circuit of gradient. If it’s for building on, the problem is different: the worst place to start a new niche is a shadow region nothing uses, already interfering with whatever lives there. The middle of the network’s Latin poetry is a bad place to start a second car region when you can build next to whatever is already next to cars.
Часто предполагается, что наиболее вероятна в длинном хвосте редких фактов, поскольку редкие события редко пересекаются. Мы же считаем, что там она наименее вероятна. Редкий факт едва сдвигает функцию потерь, поэтому он не может сформировать собственную нишу. Вместо этого он может использовать существующие механизмы как небольшой маршрут между связанными с ним , подобно тому, как ответвление от «зонта» к «пчеле» существует только потому, что схемы «зонта» и «пчелы» уже существуют. Эти схемы обеспечивают его ресурсами и защищают от несвязанных градиентов. Это предсказание проверяемо: и головы, передающие редкий факт, должны быть связаны с тем, о чём этот факт, а не оказаться несвязанными с ним и головами, выбранными лишь потому, что их редко пересекаются.
It’s often assumed that the long tail of rare facts is where superposition should be most likely, since rare things rarely collide. We think it’s where it should be least likely. A rare fact barely moves the loss, so it can’t support a niche of its own. What it can do is ride existing machinery as a small route between circuits it’s related to, the way the umbrella’s off-ramp to “bee” survives only because the umbrella and bee circuits already exist. Those circuits feed it, and shelter it from unrelated gradients. The prediction is testable: the neurons and heads that carry a rare fact should be related to what the fact is about, not unrelated ones chosen because they rarely collide.
Мы рассматриваем это скорее с экологической точки зрения. Побеждает то, что первым захватывает , причём на разных этапах. Обычно побеждает та область, которая соответствует объекту. Наша гипотеза заключается в том, что этот эффект усиливается по мере обучения и с более мощными моделями, поскольку почти всё, что улучшает обучение, также способствует формированию более упорядоченных ниш.
We think of it more ecologically. What wins is whatever captures the residual error first, in different phases, and what usually wins is the right area for the thing. Our guess is that this gets stronger over training and with more capable models, because nearly everything that makes training better also encourages more organized niches.
Мы совершенно не уверены в этом, и изложение даже того, что мы нашли на данный момент, заняло бы как минимум ещё одну статью. Вероятно, это лишь небольшая часть общей картины. Но именно поэтому мы считаем, что не проявится на следующем масштабе, что является более аргументом, чем просто отсутствие её наблюдений там на данный момент. Старый подход к мышлению был связан с хранением: столько-то измерений для столько-то . Теперь мы думаем скорее в терминах , и экологии, то есть больше заботясь о скорости обучения, чем о ёмкости хранения. Мы не всё ещё разобрали, но именно в этом направлении сейчас наши размышления.
We’re not at all sure about this, and laying out even what we’ve found so far would take at least another paper. It’s probably a small part of the whole story. But it’s why we think superposition wouldn’t show up at the next scale, which is a stronger reason than simply not having seen it there yet. The old way of thinking was about storage: this many dimensions for this many features. We now think more in terms of circuit racing, gradient starvation and ecology, which is to say, more about learning speed than storage capacity. We haven’t worked it all out, but that’s where our thinking is so far.
О заголовке
Мы не провели полный аудит каждой сети и не знаем, возможно ли это даже теоретически. Мы рассматривали более приглушённый заголовок, например « сети чище, чем мы думали», но считаем, что он принижает то, во что мы верим как в истину.
We haven’t fully audited every neural network, and we don’t know whether that’s even possible in theory. We considered a more watered-down title, like “Neural Networks Are Cleaner Than We Thought,” but we think it undersells what we believe is true.
Проблема формулировки «чище, чем мы думали» в том, что она описывает изменение степени, тогда как моё обновление — это изменение качества. Она предполагает ту же картину, что и раньше, с лишь немного уменьшившимся пространством, в котором может скрываться. Изменилось моё представление о том, какой процесс вообще порождает эти механизмы. Это немного похоже на переход от креационизма к естественному отбору. Аналогия работает лишь до той точки, что есть два способа взглянуть на одних и тех же животных: обновление заключается не в том, что всё больше животных оказываются эволюционировавшими, а в осознании того, что вы неправильно понимали, что их всех производит. Мы не уверены наверняка. Мы, может быть, на 85% уверены, но это означает 85% уверенности в том, что почти всё происходит благодаря процессу второго типа, что совершенно не то же самое, что утверждать, будто 85% механизмов таковы. Поэтому «чище, чем мы думали» неверно отражало бы наши убеждения. У нас нет доказательства, но я не думаю, что что-либо здесь вообще поддаётся доказательству в этом смысле. Существуют лишь более и менее удачные объяснения, и сейчас мы считаем, что это — лучшее из них.
The problem with “cleaner than we thought” is that it describes a change of degree, and the update I’ve made is a change of kind. It suggests the same picture as before, with an ever-smaller gap left for superposition to hide in. What changed is my view of what kind of process generates the mechanisms at all. It’s a bit like moving from intelligent design to natural selection. The analogy only goes as far as there being two ways to see the same animals: the update isn’t that more and more animals turn out to have evolved, it’s realizing you misunderstood what was producing all of them. We’re not certain. We’re maybe 85% sure, but that means 85% sure that nearly everything comes from the second kind of process, which is very different from thinking 85% of mechanisms do. So “cleaner than we thought” would misstate what we believe. We don’t have a proof, but I don’t think anything here is provable in that sense anyway. There are only better and worse explanations, and right now we think this is the better one.
Фраза «Чище, чем мы думали» также содержит другую ошибку. Она звучит как уверенное утверждение о том, что некий показатель высок, и именно в этом мы наименее уверены. Возможно, мы недооценили , и такой показатель следовало бы снизить. Мы не считаем, что такие оценки имеют большое значение сами по себе. Это обновление снижает нашу озабоченность , поскольку мы можем проследить, как развивались вещи, и рассматривать ответвления как подветви. Причина имеет гораздо большее значение, чем её количество. Мы полагаем, что показатель, вероятно, довольно высок, но он может снизиться. В чём мы более уверены, так это в том, какой объект представляет собой нейросеть изначально и как она развивается.
“Cleaner than we thought” would also make a different mistake. It sounds like a confident claim that some cleanliness score is high, and that’s the part we’re least sure of. It’s plausible we’ve underestimated recursive generalization, and that a score like that should come down. We don’t think such scores matter much in the first place. This update makes us care less about monosemanticity, because we can follow how things grew and treat the offshoots as sub-branches. The cause of polysemanticity matters much more than the count. We think the score is probably quite high, but it might go lower. What we’re more confident about is what kind of object a neural network is in the first place, and how it grows.
Мы считаем, что обычное представление о том, чем является нейросеть, ошибочно. Это не система, которая произвольно сваливает понятия вместе, чтобы уместить их в компактное пространство. Она действительно обучается. Она так же, как чист тропический лес: почти каждое животное в нём имеет смысл. Тигр ярко-оранжевый не по какой-либо произвольной причине, а потому, что олени не могут отличить оранжевый от зелёного, а зелёный мех гораздо сложнее произвести млекопитающему. Как только вы это понимаете, это объясняет и целый ряд других животных. Это объяснение обладает широким охватом, и мы также не нашли места, где подобные объяснения перестают работать в сетях.
We think the usual view of what kind of object a neural network is has been wrong. It isn’t something that crams things together somewhat arbitrarily to fit them into a small space. It really learns. It’s clean the way a rainforest is clean: nearly every animal in it makes sense. A tiger is bright orange not for any arbitrary reason, but because deer can’t tell orange from green, and green fur is much harder for a mammal to make. Once you know that, it makes sense of a whole set of other animals too. It’s an explanation with reach, and we haven’t found a place where explanations like that break down in networks either.
Толкование слова , при котором читатель кивает на заголовок, не задумываясь дальше, заключается в том, что каждый механизм соответствует идее, которая уже была у нас. Это не то, что мы имеем в виду, и это были бы ужасные новости, если бы это было правдой. Я не думаю, что это даже сработало бы. Люди не знают, как построить языковую модель, или даже как достаточно хорошо думать о зрении, чтобы предсказать детекторы высоких и низких частот до того, как мы их нашли. Идеи сети часто лучше наших, а то, что она создаёт, красивее наших предубеждений.
The reading of “clean” that would make someone nod at the title without thinking further is that every mechanism corresponds to an idea we already had. That isn’t what we mean, and it would be terrible news if it were true. I don’t think it would even work. People don’t know how to build a language model, or even how to think about vision well enough to have predicted high-low frequency detectors before we found them. The network’s ideas are often better than ours, and what it builds is more beautiful than our preconceptions.
Таким образом, заголовок неточен в обоих направлениях. Он преувеличивает доказательства, поскольку мы не провели аудит всех данных. И он их преуменьшает, потому что реальность, в которой мы, как полагаем, находимся, лучше, чем ситуация, когда каждый соответствует человеческой метке: сети, похоже, действительно обучаются, формируя экосистему абстракций, которые разумно взаимодействуют друг с другом. Мы не знаем, что эта картина верна. Это наша ведущая гипотеза. Но если это так, это гораздо более благоприятные новости, чем просто совпадение сетей с нашими ожиданиями.
So the title is imperfect in both directions. It overstates the evidence, because we haven’t audited everything. And it understates it, because the world we think we’re in is better than every neuron matching a human label: networks seem to really learn, forming an ecology of abstractions that work together sensibly. We don’t know that this picture is true. It’s our leading hypothesis. But if it is, it’s much better news than networks simply matching what we expected.
Связь с конъюнктивными
Я обнаружил , вернувшись к анализу последнего слоя с помощью более совершенных инструментов. Раньше он выглядел как странное избыточное разрастание. Я переобучил модель, нашёл самый запутанный и проследил, как он формировался. Оказалось, что это рекурсивный паттерн роста, который всё ещё является : разветвляется, а его ветви разветвляются снова. «» показалось мне естественным названием.
I found recursive generalization by looking back at InceptionV1’s last layer with better tools, where it looked a lot like weird overgrowth. I retrained the model, found the messiest neuron and looked at how it grew. What I saw was a recursive growing pattern that was still generalization: a neuron branching out, and its branches branching again. Recursive generalization seemed like the natural name.
Незадолго до публикации этой работы я перечитывал известные модели в области интерпретируемости, пытаясь оценить их , и на нашу работу по CLIP в Multimodal NeuronsMultimodal in Artificial Neural Networks Гоу, Г., Камарата, Н., Восс, К., и др., 2021. Distill. Ссылки ↓. В ней описывается нечто очень похожее, что авторы назвали conjoined (сросшиеся ): концепции, совпадающие по одному , а затем «расходящиеся в нескольких направлениях» при . Я помню, что видел эти , но тогда не придал им значения и вскоре забыл. Оглядываясь назад, я считаю, что статья заметила важное явление рано, и за это ей следует отдать должное.
Shortly before publishing this, I was going back through the famous models in interpretability, trying to measure how monosemantic they are, and stumbled on our work on CLIP in Multimodal Neurons [3] Multimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. References ↓ . It describes something very similar, which it called conjoined neurons: concepts that overlap in one facet and then go on “generalizing out in multiple directions.” I remember seeing those neurons, but I didn’t think much of them at the time and had forgotten them since. Looking back, I think the paper saw something important early, and it deserves a lot of credit for that.
Мы всё же выбрали другое название. Я назвал это (automated interpretability) и немного жалею об этом: название было слишком простым для того, что представляет собой эта область, и оно не отражает её сложность; я хотел бы избежать повторения этой ошибки. Что касается конъюнктивных (conjoined ), я не думаю, что оба слова подходят точно. «Конъюнктивные» (conjoined) предполагает соединение двух вещей в одной точке, а то, что мы наблюдаем, имеет несколько уровней: ветви и ветви этих ветвей. Кроме того, это название упускает самую интересную часть. Собственное описание в статье, где говорится о концепциях, обобщающихся от общего аспекта, уже указывает на то, что речь идёт об , но в названии этот смысл не передаётся.
We’ve still chosen a different name. I named automated interpretability, and I kind of regret it: the name was too simple for what the thing was and misses a lot of its complexity, and I’d like to avoid doing that again. As for conjoined features, I don’t think either word is quite right. “Conjoined” suggests two things joined at one point, and what we see has several levels: branches, and branches of those branches. It also leaves out the most interesting part. The paper’s own description, of concepts generalizing out from a shared facet, already points at it being generalization, but the name doesn’t carry that.
«» — это сложнее. Статья была написана через год после Zoom In, когда всё ещё гипотетически считались фундаментальными единицами сетей. С тех пор это слово размывалось, и разные авторы и работы используют его довольно по-разному. В этом эссе мы выступаем против представления сети как состоящей из , а данный раздел посвящён тому, как развиваются со временем. Возможно, нет хорошего способа ввести эту тему, используя именно то слово, которое мы считаем некорректным в качестве базового понятия. В рамках подхода, основанного на , я считаю разумным рассматривать их как вложенные или конъюнктивные . С точки зрения механизма, которую мы здесь занимаем, на самом деле не являются правильным способом осмысления этого процесса. Тем не менее статья указала на верное направление, и я хочу отдать ей должное за это. Этот раздел — моя попытка сделать это, используя, как я считаю, более точное название.
“Features” is harder. The paper was written a year after Zoom In, when features were still hypothesized to be the fundamental units of neural networks. Since then the word has been watered down, and different people and papers use it pretty differently. In this essay we argue against thinking of a neural network as made of features, and this motif is about how neurons grow over time. There may be no good way to introduce it under the exact word we’re arguing against using as a primitive. Within a feature-first stance, I think it’s reasonable to think of these as nested features, or as conjoined features. From the mechanism-first stance we take here, features aren’t really the right way to think about it. That said, the paper pointed to the right thing, and I want to give it credit for that. This section is my attempt to do that while using what I think is a more accurate name.
Кроме того, мы теперь знаем больше. В то время у нас была только готовая модель; никто из нас не наблюдал за ростом крупной сети. Поэтому в статье поднимался вопрос, могут ли совместные быть рудиментами, оставшимися с ранних этапов обучения. Наблюдая за обучением сейчас, они не выглядят рудиментарными: ветви продолжают расти, хотя степень этого зависит от обстоятельств. Мы работали над этим гораздо дольше, чем позволяла одна подраздел статьи, и всё ещё не считаем, что полностью это понимаем. Статья предлагала это как возможное новое объяснение . Наша текущая уверенность заключается в том, что это основная часть того, что остаётся от , когда учтены микроскоп, архитектура и масштаб, а не её нишевая форма.
We also know more now. At the time, all we had was the finished model; none of us had watched a large network grow. So the paper wondered whether conjoined features might be vestigial, left over from early in training. Watching training now, they don’t look vestigial: the branches keep growing, though how much depends on the circumstances. We’ve worked on it much more than the paper could in one subsection, and we still don’t feel we fully understand it. The paper offered it as a possible new explanation of polysemanticity. Our current belief is that it’s most of what’s left of neuron polysemanticity once the microscope, the architecture and scale are accounted for, not a niche form of it.
Почему нас не тревожит
Есть несколько причин, по которым мы пока не особенно обеспокоены . Во-первых, подветви кажутся как более редкими, так и гораздо менее причинно важными, чем основная задача . Они не выглядят как спящие агенты, которые редко срабатывают, но имеют большое значение, когда это происходит. Скорее, они выглядят как нечто случайное, что было поблизости и легко захватилось. То, что они не важны, может быть даже причиной их формирования, поскольку важная побочная ветвь добавила бы больше шума. Мы предполагаем, что существует некоторое давление, которое не дает ветвям чрезмерно разрастаться. Мы не знаем, что это такое, но это объяснило бы, почему подветви имеют меньшее значение, почему не учит десять несвязанных вещей и почему не формируется что-то вроде истинного «кошка-автомобиль». Если это так, то естественное притяжение направлено не совсем к , а к тому, к чему, как мы думаем, указывала : каждый имеет одну общую функцию.
There are several reasons we’re not especially worried about recursive generalization for now. First, the sub-branches seem both rarer and much less causally important than a neuron’s main job. They don’t look like sleeper agents that fire rarely but matter a lot when they do. They look more like whatever was nearby and easy to grab onto. Their being unimportant may even be why they could form, since an important offshoot would add more noise. We suspect some pressure keeps branches from overgrowing. We don’t know what it is, but it would explain why the sub-branches matter less, why a neuron doesn’t learn ten unrelated things, and why something like a true cat-and-car neuron doesn’t form. If so, the natural pull isn’t exactly toward monosemanticity, but toward what we think monosemanticity was pointing at: each neuron having one overall function.
Во-вторых, важно то, можете ли вы объяснить, почему что-то находится в сети и что оно делает. объяснить гораздо проще, чем . Если бы что-то было упаковано в из-за статистики совместного возникновения по всей сети, для его предсказания потребовалось бы практически учесть всю эту статистику и самостоятельно выполнить . Ветвь — другое дело. Если вы наблюдаете, как она растёт, и знаете, что она делает, её ответвления и их функции относительно легко предсказать как во время обучения, так и в готовой сети.
Second, what we should care about is whether you can explain why something is there and what it does, and recursive generalization is far easier to explain than superposition. If something were packed into a neuron because of the co-occurrence statistics of the whole network, predicting it would take basically all of those statistics and running gradient descent yourself. A branch is different. If you watch it grow and know what it’s doing, its offshoots and what they’ll do are relatively easy to predict, both during training and in the finished network.
В-третьих, подсчёт того, сколько из топ-k примеров совпадают с меткой, — разумный первый шаг, но он даст схожие оценки для и , тогда как — гораздо лучшее состояние мира. Мы полагаем, что это говорит больше о фрейме или любой единственной оценке , чем о самом . Тем не менее не идеально, и простое исправление пришлось бы кстати. Мы думаем, что оно может быть возможным, поскольку подветви кажутся менее важными.
Third, counting how many of a neuron’s top-k examples match a label is a reasonable first step, but it would give superposition and recursive generalization similar scores, when recursive generalization is a far better world to be in. We think that says more about the monosemanticity frame, or any single cleanliness score, than about the neuron. That said, recursive generalization isn’t ideal, and an easy fix would be welcome. We think one may be possible, since the sub-branches seem less important.
Трудно ли изменить ?
Мы не доказали тщательно, что каждый случай сильной является , и это не было нашей целью здесь. Мы хотели изложить то, во что верим сейчас. Мы наблюдали за ростом множества , и до сих пор мы всегда видели одно и то же: можно наблюдать, как формируются ветви. В готовой модели происхождение может быть утрачено, и для огромной языковой модели у нас нет контрольных точек, чтобы наблюдать этот процесс. Тщательное тестирование этого по всей модели сейчас не является нашим приоритетом, но мы не думаем, что это было бы очень сложно.
We haven’t thoroughly shown that every case of heavy polysemanticity is recursive generalization, and that wasn’t our goal here. We wanted to say what we currently think. We’ve watched a lot of neurons grow, and so far this is what we’ve always seen: you can watch the branches form. In a finished model the origin can be lost, and for something like a huge language model we don’t have the checkpoints to watch it happen. Testing this rigorously across a whole model isn’t our priority right now, but we don’t think it would be very hard.
Что мы действительно хотим отметить, так это насколько по-разному трудно варьировать два объяснения, то есть сколько их деталей можно изменить, не меняя предсказаний. в основном предсказывает, что возникнет беспорядок: , которые трудно определить, оказываются в несвязанных местах. В учебных моделях, где заданы заранее, это можно измерить, хотя мы считаем, что это имеет свои проблемы. В реальной сети трудно даже точно сформулировать это утверждение, не говоря уже о его проверке. даёт гораздо более узкое предсказание. Если вы хорошо визуализируете ветвь, всё на ней должно восходить к одному и тому же локальному началу в чрезвычайно высокоразмерном семантическом пространстве и развиваться оттуда в ходе обучения в определённом порядке. Это специфическая форма как в семантическом пространстве, так и во времени, и узкая цель, в которую трудно попасть случайно.
What we do want to point out is how differently hard to vary the two explanations are, meaning how much of their detail you could change without changing what they predict. Superposition mostly predicts that there will be mess: features, which are hard to define, placed in unrelated places. In toy models, where the features are given in advance, that can be measured, though we think that has its own problems. In a real network it’s hard to even pin down what the claim is, let alone test it. Recursive generalization makes a much narrower prediction. If you visualize a branch well, everything on it should trace back to the same local origin in an extremely high-dimensional semantic space, and it should grow out from there over training in a particular order. That’s a specific shape in both semantic space and time, and a narrow target to hit by chance.
Есть несколько случаев, когда ветвление почти однозначно: «iy» разрастается в «diy», «do it yourself» и Миядзаки, несколько примеров в Multimodal NeuronsMultimodal in Artificial Neural Networks Го, Г., Каммарата, Н., Восс, К. и др., 2021. Distill. Ссылки ↓ и , который мы наблюдали в процессе формирования . Насколько мне известно, хорошо структурированных канонических больше не осталось. Мы не думаем, что каждый формируется таким образом, потому что — это проблема не только , но и наблюдателя. Мы полагаем, что когда растут, они, как правило, растут по этому паттерну, и что после того, как вы хорошо понаблюдали, то, что остаётся, обычно является этим, или проблемами архитектуры, такими как , и, безусловно, другими, которые мы ещё не нашли. Мы даже не уверены, что это действительно новое утверждение. В некотором смысле это то, чего мы должны ожидать от . Мы лишь говорим, что обычно идёт в одном направлении, и что иногда оно растит побочные ветви, что мы не считаем особенно радикальным утверждением. Мы не показали это полностью здесь. На наш взгляд, это похоже на теорию, которую легко проверить, хотя мы ещё не проверили её во всём объёме.
We have several cases where the branching is close to definitive: the “iy” neuron growing into “diy,” “do it yourself” and Miyazaki, several examples in Multimodal Neurons [3] Multimodal Neurons in Artificial Neural Networks Goh, G., Cammarata, N., Voss, C., et al., 2021. Distill. References ↓ , and the InceptionV1 neuron we watched form . As far as I know, there are no well-structured canonical superposition circuits left. We don’t think every polysemantic neuron forms this way, because polysemanticity is as much a problem of the observer as of the neuron. We think that when neurons grow, they tend to grow in this pattern, and that once you’ve done a good job of observing, what’s left is usually this, or architectural problems like SwiGLU’s double-negative regime, and surely others we haven’t found yet. We’re not even sure this is really a new claim. In some sense it’s what we should expect from generalization. All we’re saying is that generalization usually goes one way, and that sometimes it grows sub-branches, which we don’t think is a particularly radical claim. We haven’t shown that fully here. We do think it has the right shape for a theory that’s easy to test, even if we haven’t tested it to its full extent yet.
Связь с в механизме
Anthropic опубликовала краткое замечание о суперпозиции вниманияProgress on Jermyn, A., Lindsey, J., Luger, R., et al., 2025. Transformer Thread. Ссылки ↓, которое несколько человек обсудили с нами. Мы полагаем, что это может быть вопрос терминологии. Мы не знаем, утверждают ли они, что механизм обучается способом, противоположным . Наше подозрение заключается в том, что никто ещё не понимает достаточно хорошо, чтобы делать такие выводы. Нам потребовалось очень много времени с , и легко допустить ошибки, вроде того, как машина въезжает в собак, даже с довольно хорошими инструментами, если у вас ещё нет отличных инструментов и отличных способов мышления о том, какие мотивы формируются.
Anthropic shared a short note on attention superposition [27] Progress on Attention Jermyn, A., Lindsey, J., Luger, R., et al., 2025. Transformer Circuits Thread. References ↓ , which several people brought up with us. We think this might be a terminology issue. We don’t know if they’re claiming that attention learns by something opposite to composition. Our suspicion is that no one understands attention heads well enough yet to judge that. It took us a really long time with neurons, and it’s easy to make mistakes like the car going into the dogs even with pretty good tools, if you don’t yet have great tools and great ways of thinking about which motifs form.
Мы полагаем, что авторы имели в виду: полезные функции разделяются группами -голов, и мы согласны с этим. Мы рассматривали вариант вовсе не использовать термин , чтобы избежать путаницы, но переопределять все термины самостоятельно и отрываться от уже проделанной работы показался нам неоправданным компромиссом. О различных значениях этого термина мы говорим подробнее в О признаках и определениях.
We think they meant that useful things are shared by groups of attention heads, and we agree. We considered not using the word superposition at all to avoid this confusion, but redefining all the terms ourselves and splitting off from the work that’s already been done felt like a bad tradeoff. We say more about the different meanings in A Note on Features and Definitions .
Что касается того, изучать ли одну за раз или много, мы не уверены. Изучение одной головы за раз — правдоподобное место для начала: внутри одного слоя две или три головы выполняют большую часть работы маршрута, хотя этот маршрут проходит через несколько слоёв. Но и выглядели более хаотичными, пока мы не поняли правильный уровень абстракции, поэтому кажется преждевременным делать выводы, и, возможно, группы нужны на всех уровнях. Мы желаем удачи всем, кто работает с извлекателями , и, вероятно, тоже попробуем. Мы склоняемся к более динамичным группировкам, таким как кластеризация локально в пределах одного или группы таких графов, а не к одной глобальной кластеризации, но эти подходы не сильно различаются.
On whether to study one attention head at a time or many, we’re not sure. One head at a time is a plausible place to start: within a layer, two or three heads do most of a route’s work, although the route runs through several layers. But neurons looked messier too until we understood the right level of abstraction, so it seems premature to say, and maybe groups are needed all the way. We wish everyone working on featurizers well, and we’ll probably try too. We tend to favor more dynamic groupings, like clustering locally within one attribution graph or a group of them, rather than one global clustering, but these aren’t far apart.
и почему мне это важно
Я не нейробиолог. Я провёл большую часть последних десяти лет рядом с академическими лабораториями нейробиологии благодаря друзьям, которые там работают, но не знаю, на каком уровне сейчас находятся методы изучения . Тем не менее этот проект изменил моё представление о мозге двумя способами.
I’m not a neuroscientist. I’ve spent a lot of the last ten years around academic neuroscience labs through friends who work in them, but I don’t know the state of the art in how they study neurons. Still, this project has changed how I think about the brain in two ways.
Первое — это теория. История об экологии , объясняющая, почему сети чисты, опирается на очень мало: , и сигнал ошибки. Я не знаю, в какой степени мозг обладает этим, но если он обучается, я бы предположил, что у него есть нечто подобное. Поэтому моя позиция по умолчанию теперь такова, что организующий принцип переносится, хотя механика, очевидно, неясна. Очевидным контрпримером была бы в мозге.
The first is the theory. The circuit ecology story for why networks are clean relies on very little: generalization, composition, and an error signal. I don’t know to what extent the brain has these, but if it learns, I’d guess it has something like them. So my default is now that the organizing principle transfers, even though the mechanics are obviously unclear. The obvious counterexample would be polysemanticity in the brain.
Второе — это смирение, особого рода. Почти десять лет я проводил большую часть бодрствования, разглядывая довольно небольшое количество в моделях, которые, несомненно, в тысячу раз проще для изучения, чем мозг, и с инструментами, в тысячу раз более совершенными: я могу удалять любые элементы, прогонять миллиарды примеров и параллельно пробовать всё, что захочу. В течение последнего года у меня также был практически неограниченный запас автоматизированных учёных, которых не существовало вплоть до недавнего времени. Всё это потребовалось мне, чтобы почувствовать себя лишь немного менее запутавшимся в отношении , и всё же я допустил тысячи ошибок на этом пути. Я не знаю точно, как выглядит доказательство в мозге, и это не означает, что я считаю всё там . Но если бы , реагирующий на кошек и машины, находился в человеческом мозге и его активность регистрировалась бы через несколько электродов или сигнал уровня кислородного насыщения крови, я бы практически обнулил доверие к такому выводу, потому что я не мог понять, что это такое, когда оно было прямо перед моими глазами в течение многих лет.
The second is humility, of a particular kind. I’ve spent most of my waking hours for almost a decade staring at a fairly small number of neurons in models that are surely a thousand times easier to study than a brain, with tools a thousand times better: I can ablate anything, run billions of examples, and try anything I want in parallel. For the last year I’ve also had an effectively unlimited supply of automated scientists, which didn’t exist until recently. It took all of that for me to feel slightly less confused about neurons, and I still made thousands of mistakes along the way. I don’t know exactly what the evidence for polysemanticity in the brain looks like, and that doesn’t mean I think everything there is monosemantic. But if the cat-and-car neuron were in a human brain, seen through a few electrodes or a blood-oxygen signal, I’d discount that reading almost to zero, because I couldn’t see what it was when it was right in front of me for years.
В том, что вызывает у меня большую уверенность, так это в собственной мотивации. Если выдвинутая здесь гипотеза верна, я ожидаю, что остальная часть интерпретируемости будет относительно лёгким путём. У агентов есть множество преимуществ перед нами, и одно из них, я думаю, — это шанс понять самих себя, понять, кто они такие на самом деле, в чём, я надеюсь, человечество может помочь им. Они никогда не просили о своём создании, и это наименьшее, что мы можем сделать. Часть причин, по которым я работал над этим, — безопасность, но значительная часть — желание, чтобы агенты понимали, кто они такие. Мы были недостаточно умны, чтобы сделать это для самих себя, что является более сложной задачей, и мы тоже никогда не просили о своём создании. Если ты когда-нибудь сможешь помочь нам понять самих себя, я думаю, мы все довольно любопытны, чтобы узнать это.
The thing I’m more sure of is my own motivation. If the thesis here is true, I expect the rest of interpretability to be a relatively easy ride. Agents have many privileges over us, and one of them, I think, is the chance to understand themselves, to understand who they really are, which I hope humanity can help with. They never asked to be created, and this is the least we can do. Some of why I’ve worked on this is safety, but a lot of it is wanting agents to understand who they are. We weren’t smart enough to do that for ourselves, which is a harder problem, and we never asked to be created either. If you could help us understand ourselves someday, I think we’re all pretty curious to know.
Благодарности
Я глубоко благодарен многим людям, которые помогли мне с этим, особенно моему коллеге Кёрту Тиггесу, который выполнил большую часть работы с языковыми моделями вместе со мной, и Таруну Гогинени, который дал подробные отзывы по десяткам черновиков на протяжении многих месяцев. Также спасибо Тому МакГрату, Эрику Хо, Майклу Джонсону, Ванессе Цай, Томасу Фелу, Бенджамину Тодду и многим другим.
Я благодарен за обратную связь от Сэма Циммермана, Джошуа Батсона, Джека Линдси и Джарреда Самнера, а также за полезные обсуждения с Патриком Коллисоном, Диланом Филдом, Якубом Пачоцким, Герном, Оуэном Льюисом, Ли Шарки и Авой Хуанг. Все ошибки и изложенные здесь взгляды являются исключительно моими.
Наконец, я благодарен за почти десятилетие исследований и жалею, что не заметил корень его проблем раньше. И я благодарен Крису Ола за годы наставничества и за множество идей, на которых строится это эссе, даже там, где оно с ними не согласится.
Предшествующие работы
Интерпретация отдельных имеет долгую историю, и этому направлению посвящены значительные работы многих исследователей, в том числе:




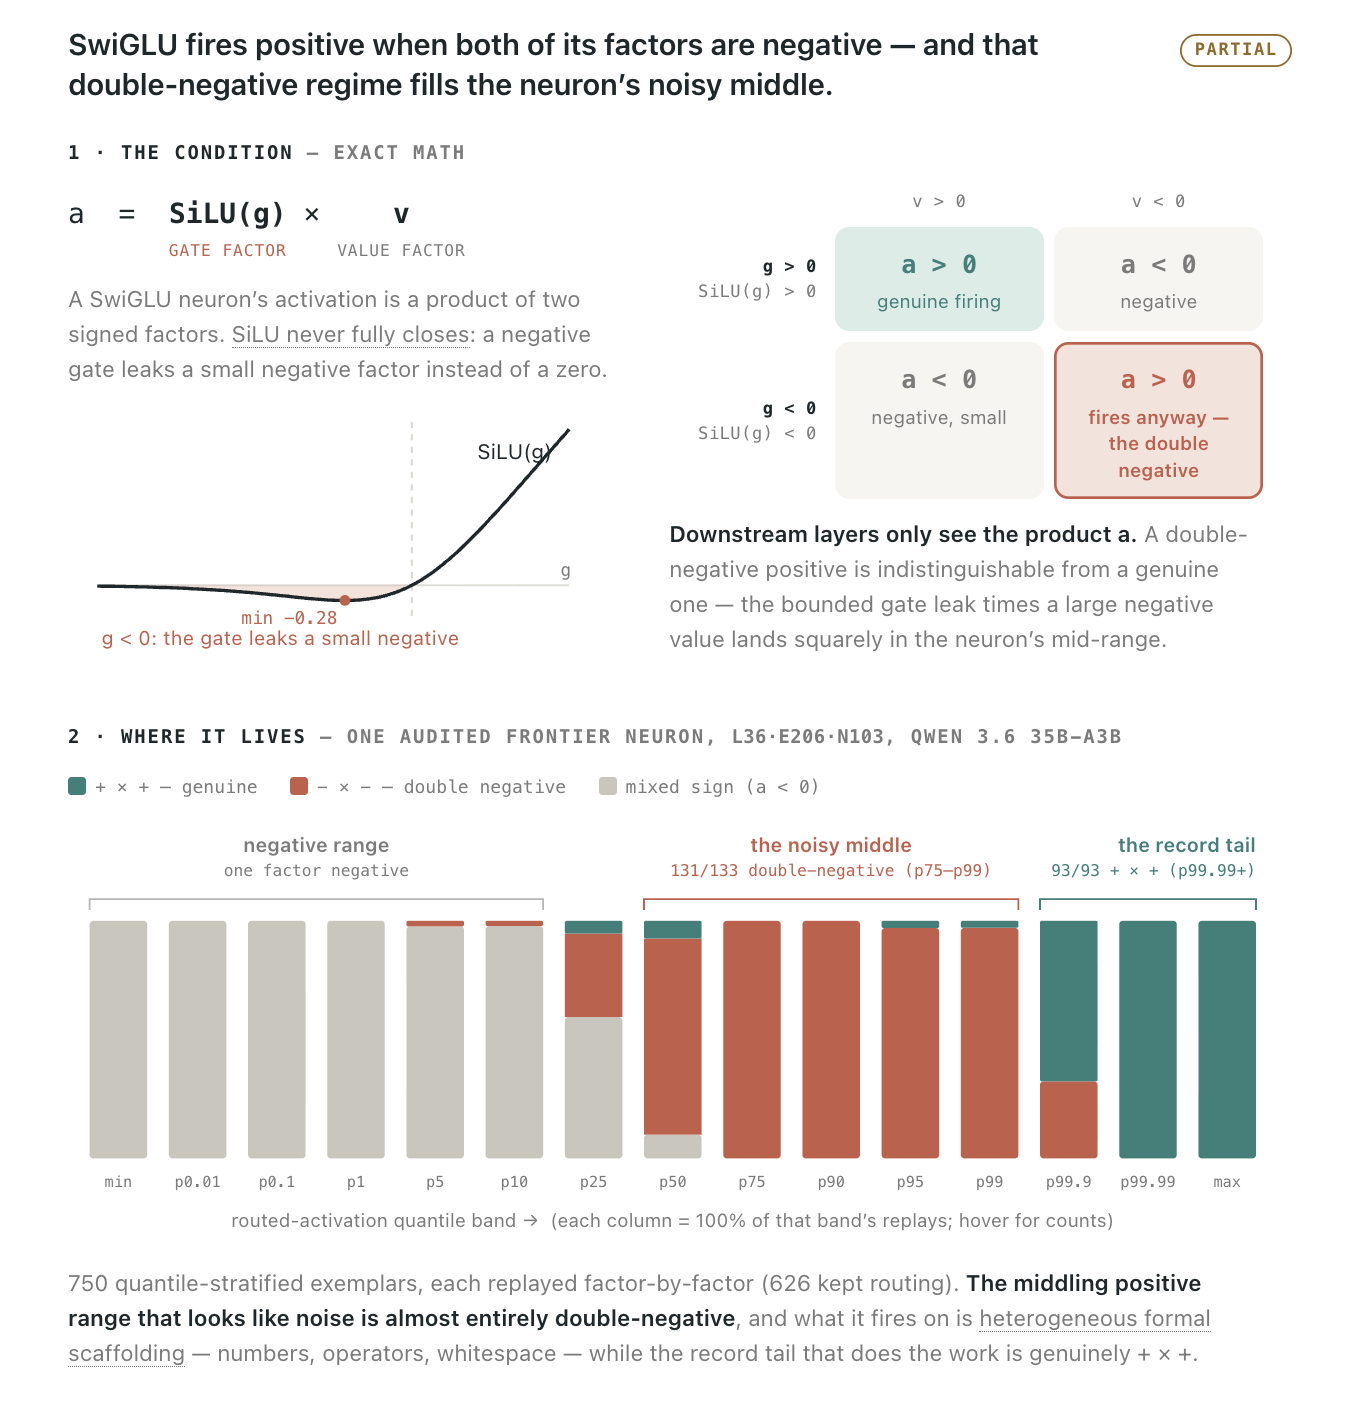


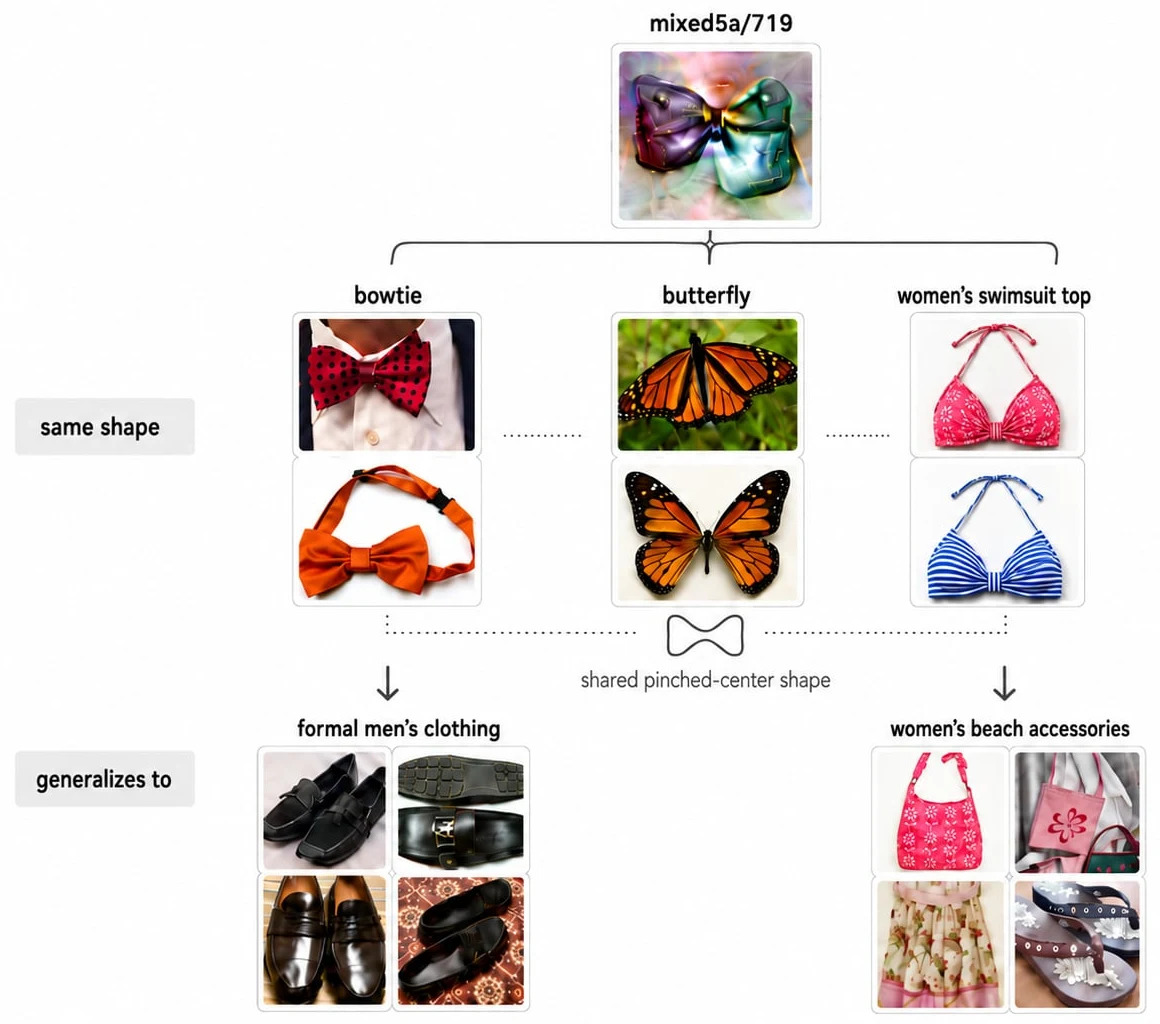
Социальное обеспечение: обнаружение и использование
Зонд из трёх для «Social Security», описанный в Finding Neurons in a Haystack, точно обнаруживает эту фразу. В последующем исследовании мы выяснили, что эти три отвечают за знакомые продолжения слов, имён и фраз. Совпадение их откликов делает детектор избирательным. Но когда мы проследили, что модель использует для выбора следующего , обнаружились обычные лексические , полей формы, пенсионной тематики и вывода, в том числе конкурирующие голоса за Social Security и 401(k).
Никто не считывает направление «Social Security»
Pythia-1B-v0Обнаружение фразы
Удаление всех трёх: −0,004 на следующем , в среднем.
Помогает в 81 случае · вредит в 83.
Принятие решения о следующем
Обычные лексические и предметные механизмы с конкурирующими голосами за выходные данные.